
大模型api平台怎么选?按计费方式和限流规则取舍
- 2026年11月18日
- 31 次
调用别家训好的模型跑自己的业务,中间那层把接口、密钥、额度、账单和限流包在一起的服务,就是大模型api平台。它卖的不是模型本身,是模型的接入方式。同一套权重,换一家平台,计价方式、允许的速率、能吃的上下文长度可以完全不同。选型要做的,是把这三张表摊开对着自己的流量算一遍,而不是看谁家模型榜单排得高。
按token计费还是按次计费
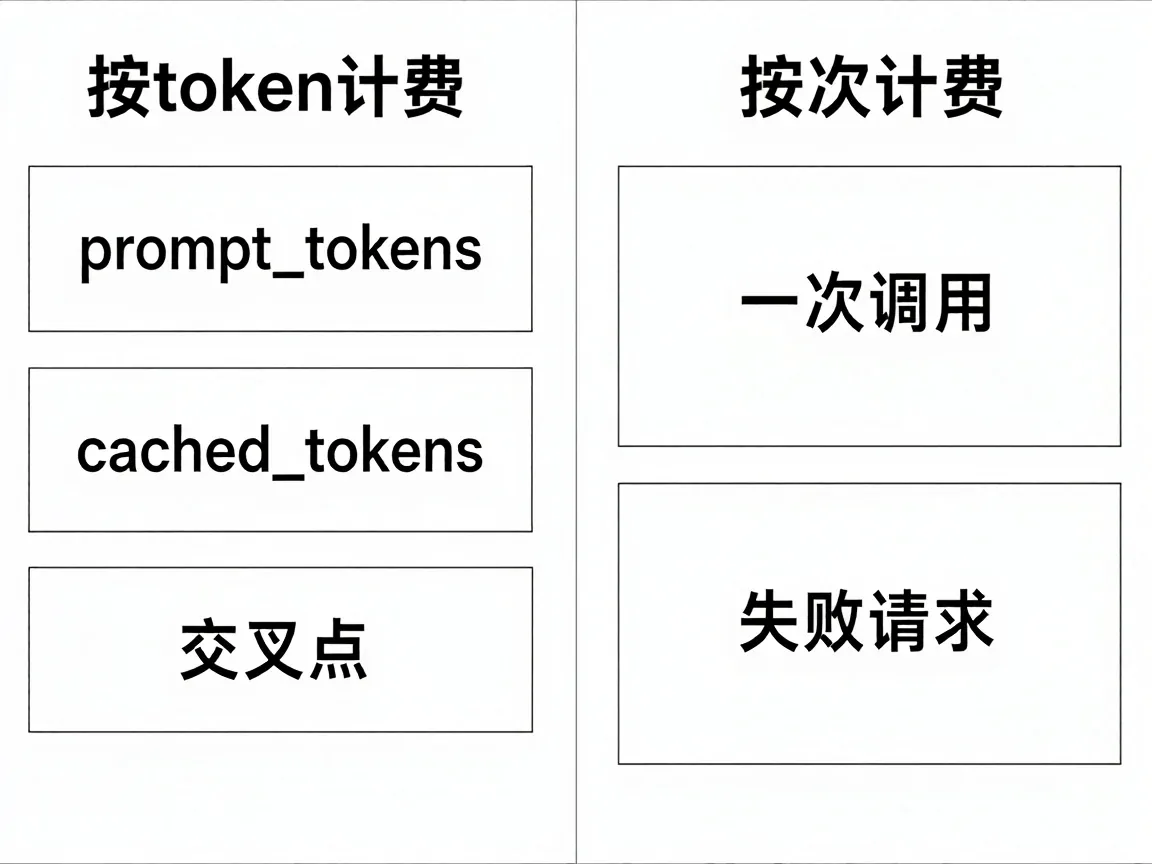
计费口径先切,因为它是唯一会随调用量线性放大的成本项。按token计费把输入和输出分开定价,输出单价普遍高于输入;按次计费一次调用一个价,跟这一条塞了多少字无关。判断点不是哪种更便宜,是单次请求的长度稳不稳。
长度稳定的任务好算。标题改写、短文本分类,每次两三百 token,把按次单价除以按token单价,得到一个 token 数,这个数就是交叉点:实际请求长期低于它,按次划算;高于它,按token那家开始便宜。带检索的问答是另一种形状,prompt 从八百字涨到六千字,按次那家不会因为你多塞五千字加钱。
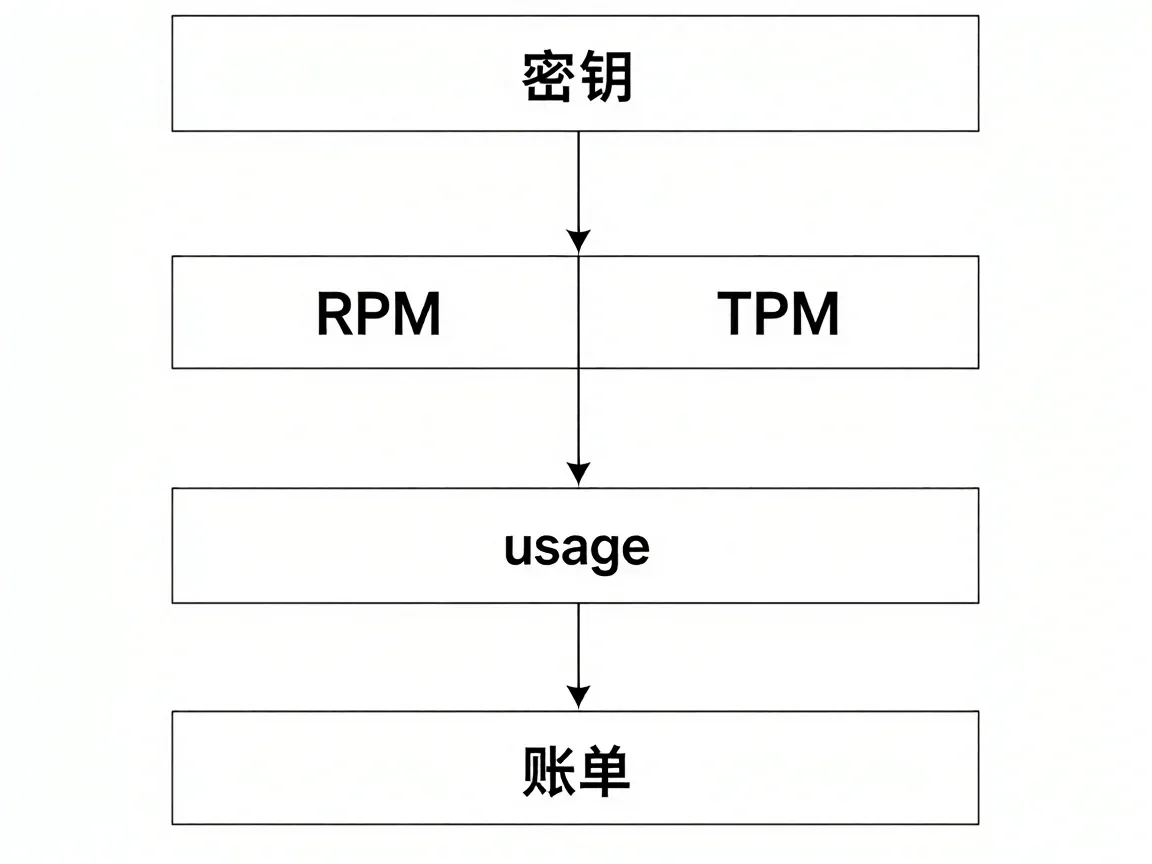
账单对不上,多半出在输入侧的口径。返回体的 usage 里通常有三个数:prompt_tokens、completion_tokens、total_tokens;做了缓存的那几家会再单列一层 prompt_tokens_details.cached_tokens。同一段八千字的系统提示词反复发,一家把命中的部分按缓存价计,input 金额只剩全价的一小截;另一家的 usage 里没有这一层,全额计。
两家月度账单的差额,就是那段重复前缀的 token 数乘上标准输入价与缓存输入价的差,不用估——用量明细导出来,按 cached_tokens 列求和就能算。
具体单价和折扣比例各家都在调,以官方文档为准。核对的位置是定价页里按模型分行的表,看「输入」「输出」「缓存命中」三列是不是都给了数;只给两列的平台,缓存那块要么没有,要么写在另一页的说明里。
按次计费还有一处容易漏:失败请求算不算一次。有的 4xx 不计费,有的把超时也算进去,压测看不出来,等线上一批重试才在账单上见到。
限流先看哪两个数
RPM 和 TPM。前者管一分钟能发几次请求,后者管一分钟能过多少 token。两条线撞的是同一个状态码 429,处理方式却相反:次数打满等一会儿就恢复,token 打满要等整个窗口滑过去。
撞了哪条,不用猜,前提是平台肯给余量。返回 x-ratelimit-* 这一套头的(OpenAI 系是典型),x-ratelimit-remaining-requests、x-ratelimit-remaining-tokens 是当下还剩多少,x-ratelimit-reset-requests、x-ratelimit-reset-tokens 是多久之后重置。后两个值长这样:6m0s、20ms,是时长字符串不是时间戳,直接丢进按秒解析的函数会得到 1970 年。国内多数平台不回这四个头,那就没有余量可读,只能从 429 反推——这是平台差异,不是普遍行为。
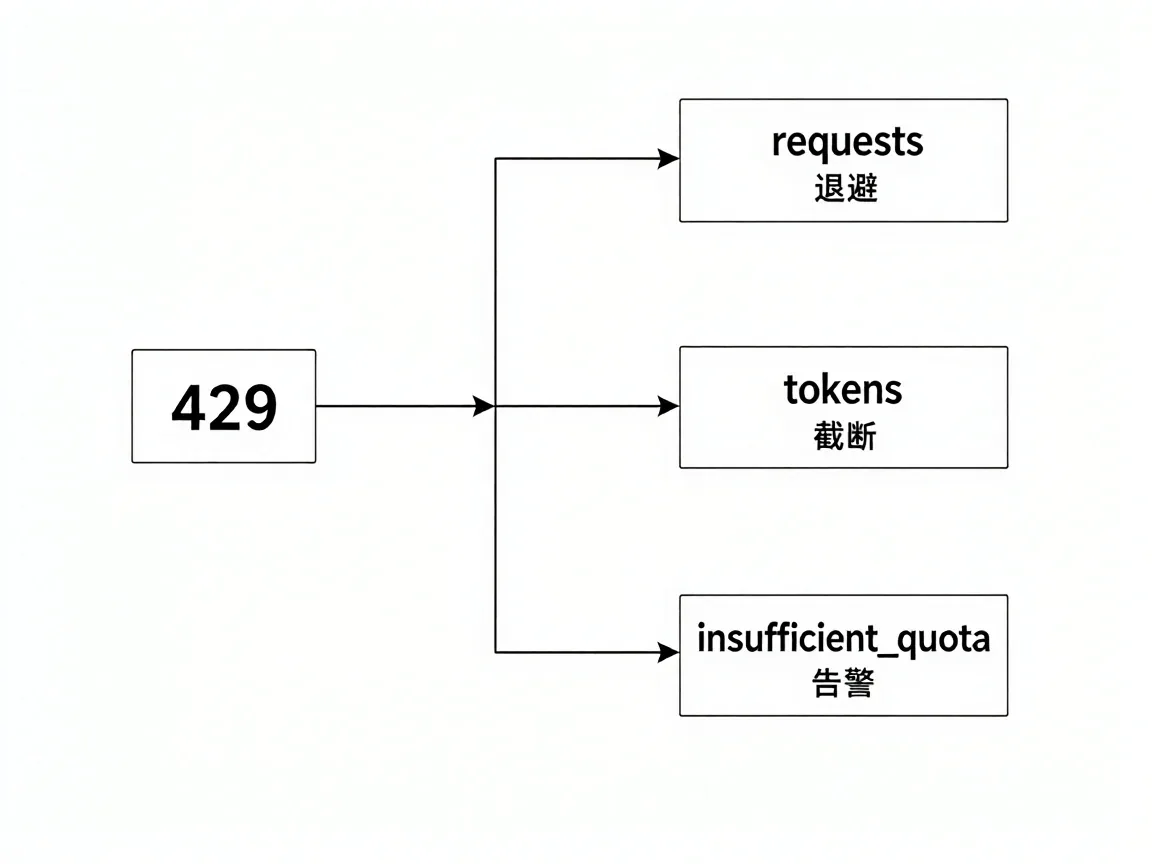
真撞上了,看返回体的 error.type。是 requests,说明次数打满,退避几十毫秒再发;是 tokens,说明这一分钟的量已经用光,重试多少次都要等窗口过去,这时该做的是削短 prompt 或者降并发。还有一种长得像限流的:error.code 是 insufficient_quota,那是余额或者配额见底,退避一万次也不会好。
压测能提前把两条线的先后顺序试出来,而这个顺序跟请求形态绑得很死。我压的时候是 20 并发、每条带六千 token 上下文,先返回 429 的是 TPM;把 prompt 压到两百 token 再压同样的并发,先撞的变成 RPM。所以看平台的限流表,不是比哪个数字大,是看业务落在哪条线附近——上下文长的应用,TPM 才是天花板。
每分钟的额度按账号等级分档,以官方文档为准,位置在控制台的「速率限制」页,看当前 key 所属 tier 那一行。有的平台把它折在模型详情页的折叠块里,不登录看不到。
上下文长度怎么比
宣称的窗口是输入加输出,不是一个能塞满的桶,这条只对按 chat completions 计窗口的那类平台成立。模型页写 128k,实际能发的输入要减掉自己设的 max_tokens。max_tokens 给 8k,输入就只能到 120k 出头。Anthropic、Gemini 这一类把输入与输出分两栏写的,窗口按输入那栏算,别拿总数减输出,否则会把可用输入估少一半。
超了返回 400,code 是 context_length_exceeded,message 里会同时给 allowed 和 requested 两个数。两个数对不上预期的时候先看自己的 max_tokens,因为校验的是两者之和,不是输入单独的长度。
除了正文,system prompt、工具定义、图片、多轮历史全部计入 input。多轮对话最费:每一轮都要把之前所有轮次重发一遍,第十次请求的 input 往往是第一次的好几倍。在多数大模型api平台,这部分按输入价实打实收钱;按次计费时它只决定你能不能发出去。
比窗口要看三个数:窗口大小、单次输出上限、超限时的行为。前两个在模型页,第三个只能试——有的平台超限直接报 400,有的静默截断,返回 200 但 finish_reason 是 length,输出缺一截还不报错。
窗口和单价要一起看。窗口翻倍、输出上限没动的平台,可用输入并没有翻倍。
大模型api平台的四步试跑
第一步,抽二十条线上真实请求原样发一遍,把每条返回的 usage 存下来。看 prompt_tokens 的分布:中位数多少,最长的到多少。
第二步,抓响应头。200 的那条也抓,记下四个余量值,隔一分钟再抓一次,看 x-ratelimit-reset-tokens 怎么变。头里字段齐全的平台,出问题时有据可查;一个都不给的,只能靠 429 反推。
第三步,压一次并发。从十路起,每路发同一段 prompt,逐步加,直到开始出现 429,记下先撞的是哪条线。客户端的失败分支按 error.type 分流:tokens 走长退避,requests 走短退避,insufficient_quota 直接告警不重试。
第四步,跑满一天对账单。把平台导出的用量明细和本地记的调用次数对一遍,差额超过百分之一就去查:多数是重试带来的重复计费、缓存没命中,或者多轮历史比预估的长。
四步走完,两家大模型api平台的区别落在数字上。剩下的文档写不清:控制台好不好用、工单多久回。
上线前的三条自查
把当月用量明细导出,按 cached_tokens 列求和,乘标准输入价与缓存输入价的差,看这一项占支出多少;占比高,说明那段重复前缀没被缓存。
抓一条 200 响应,抄下 x-ratelimit-remaining-tokens 与 x-ratelimit-reset-tokens,跟自己的 TPM 曲线对一遍,对不上就是有多个 key 在共用一个额度。
把 max_tokens 调到打算用的上限,灌一段接近窗口的输入发一次:返回 400 看 message 里的 allowed,返回 200 看 finish_reason 是不是 length。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- ChatGPT和Claude区别在哪,写作与编程怎么选 2026-11-07
- react按钮跳转页面没反应?从事件绑定查到路由配置 2026-11-15
- hermes接入agnes-ai API实现免费文本生成、文生图、图生图、图生视频 2026-07-20
- jquery each和for循环怎么选?要中断就用for 2026-11-11
- 怎么识别ai换脸?先看边缘再查光影与帧率 2026-11-11
- ChatGPT吃配置吗?网页版与本机客户端两条路的取舍 2026-11-19