
nginx 命令怎么确认配置生效?从语法检查到重载的顺序
- 2026年11月22日
- 12 次
手上这套站是三年前搭的,一台入口机做反向代理,两台应用机跑 PHP-FPM。nginx 跟着发行版仓库走,没自己编译过,版本看 nginx -v 那一行就知道。平时改配置就靠几条nginx 命令,顺序一直是想到哪跑到哪;conf.d 下按站点分文件,端口、server_name、upstream 各自在各自文件里改。现在的问题是改完一个 conf、reload 过,页面还是老样子,日志里又找不到报错。想接着在这套结构上动刀,得先把顺序固定住,每一步都能判断生效没有。
语法检查能不能代表生效
不能,它只证明这份文件能被解析。确认生效的顺序是:先 nginx -t 看返回码,再用 nginx -T 确认 include 之后真正加载的是哪一份,然后才发 reload,最后回到进程和日志上核对。跳过第一步直接 reload,最坏的结果不是报错,是旧配置继续跑,你以为改了。
nginx -t 会把主配置和所有 include 读一遍,检查指令名、括号配对、参数个数,以及证书和日志目录这些路径能不能打开。它不碰 upstream 里的后端,也不管 server_name 写得对不对。
先跑这三条,确认配置能不能读进来、合并之后长什么样:
nginx -t
echo "exit=$?"
nginx -T | grep -nE "server_name|listen" | head -20
正常是两行,第一行 nginx: the configuration file /etc/nginx/nginx.conf syntax is ok,第二行 ... test is successful,echo 打出 exit=0。失败时先给一行 [emerg],带文件名和行号,收尾是 test failed。
nginx -T 打出来的是 include 之后的合并结果。多文件拆分时 listen 到底写了几个、server_name 落在哪个 server 块里,从那份输出里能一眼看出来。
文件名只决定加载先后,不产生覆盖关系。同一上下文里重复写同一条指令,nginx 直接给 [emerg] "xxx" directive is duplicate;同名 upstream 报 duplicate upstream;多个 server 块各自生效,靠 server_name 匹配请求,不存在后者盖前者。所以改文件名改的是顺序,不是覆盖;真要查冲突,还是看 -T 展开后那份合并结果。
重载和重启差在哪
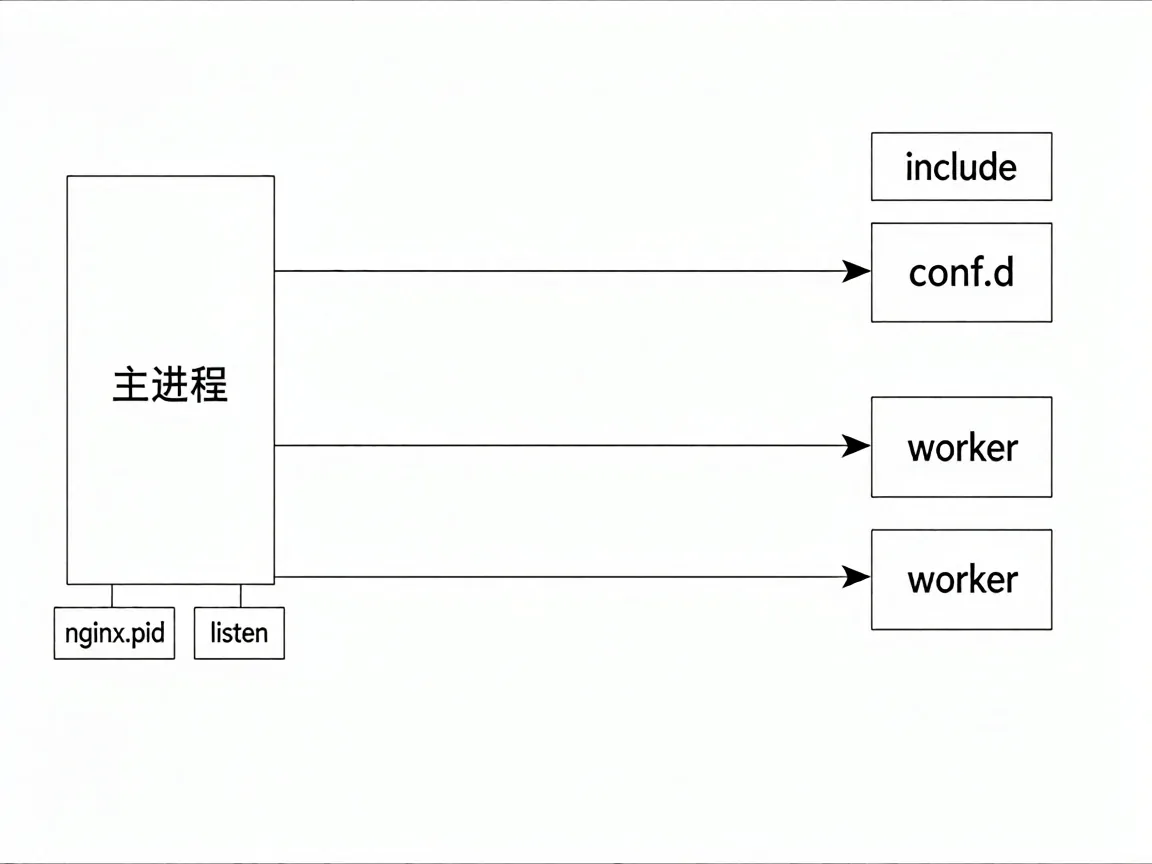
nginx 是主进程(master)带一群 worker 的模型:master 只读配置、持有监听句柄、发信号,worker 接连接。改配置不用停进程,靠的就是这个分工。
-s reload 给 master 发 HUP。master 重新解析配置,成功就 fork 新 worker,把老 worker 标成优雅退出;失败就一动不动,老 worker 继续服务。
restart 是停掉整个进程组再起来,中间有一段时间没有进程 accept,新连接直接被拒。reload 没有这个空窗。
代价在失败时的反馈上。restart 挂了,systemd 会给一行 Job for nginx.service failed;reload 失败只是控制台什么都不说,日志多一条 emerg,进程表看着一切正常。
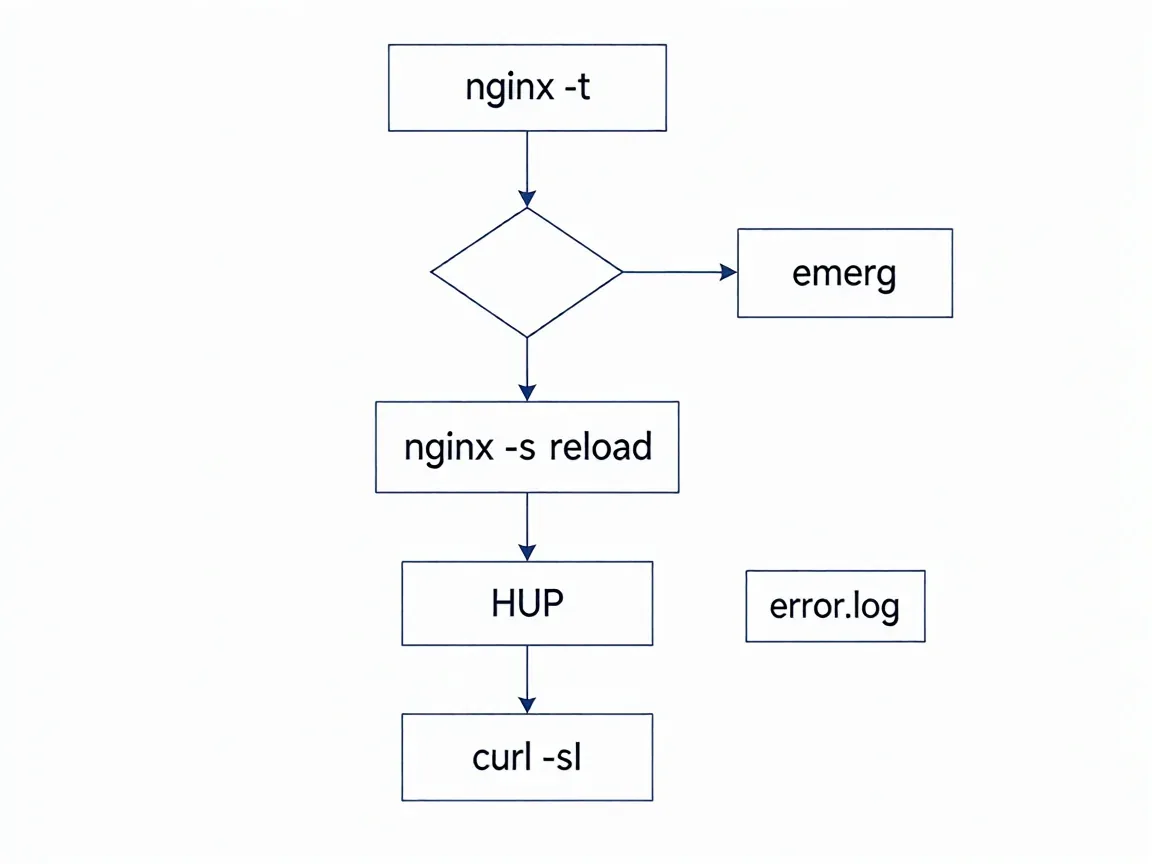
判断用哪条,标准不是改动大小,而是要不要动 user、pid、worker_processes 这类只在启动阶段确定的指令。加 server 块、改 upstream、改 location,reload 够用;换 user 或者换 pid 路径,只能 restart。加一个新的 listen 端口可以试着 reload,bind 失败只会留在日志里,不会把服务弄挂。
master 的 pid 整个生命周期不变,80 和 443 这类端口也只有它在 bind,worker 继承的是同一个句柄。ss 里看到的进程名是 nginx、pid 却属于 master,原因就在这里。
平滑重载时,nginx 命令在进程层面做了什么
执行 nginx -s reload,它做的是读 pid 文件、给里面的进程发 HUP,自己不解析配置也不做校验。成功与否取决于 master 收到信号之后那一次解析。
pid 文件的位置由 nginx.conf 里的 pid 指令决定,发行版包的默认值在 /run/nginx.pid,自己编译的常见 /usr/local/nginx/logs/nginx.pid。这个路径先对上,-s reload 才找得到 master。
master 的动作是固定的:重读主配置和 include、检查文件能否打开、尝试 bind 新的 listen、fork 新 worker。任何一步失败,它保持旧 worker 不动,只往 error.log 写一行。
日志顺序能对上:先是 signal process started,接着几行 worker process ... exited,最后是 start worker process 加新 pid。
有个容易看错的地方。老 worker 不是立刻消失,它要等手上连接结束,上限由 worker_shutdown_timeout 给。reload 完马上 ps,看到新旧两批 worker 同时存在是正常的。
只有老 worker 没有新 worker,才是解析或 bind 失败。去 error.log 找那行 emerg,别重复发信号,连着发几次 HUP 只会让 master 反复读同一份坏配置。
reload 之后核对哪几样东西
发完这条nginx 命令,返回 0 不代表生效,只代表信号送达到了。核对落在三个地方:进程号、监听端口、真实响应。
nginx -s reload
ps -eo pid,ppid,lstart,cmd | grep "[n]ginx: worker"
ss -lntp | grep nginx
curl -sI http://127.0.0.1/ | head -3
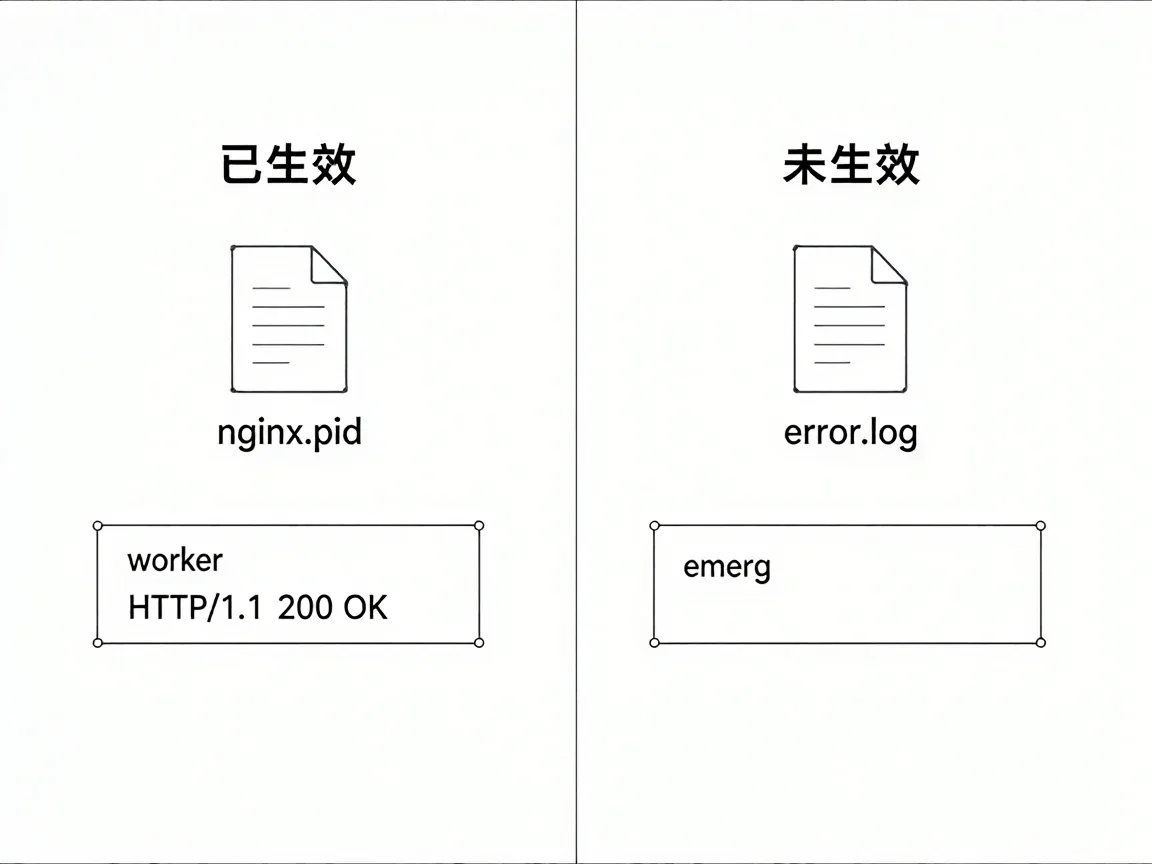
跑完该看到:worker 那几行的 pid 和 reload 之前不同,ppid 还是 master 那个号;ss 里 listen 的端口和 conf 里写的一致;curl 前三行是 HTTP/1.1 200 OK、Server: nginx、Date。pid 没变就是信号没送到,多半出在 pid 文件路径或者权限上。
lstart 那一列是 worker 的启动时间,比 pid 好认。新一批 worker 的时间应该就落在刚才那次 reload 之后,秒级对得上,说明这批进程确实是新配置起的。
用非 root 跑 nginx -s reload,常见的是两种:open() "/run/nginx.pid" failed (13: Permission denied),或者读到了 pid 却没权限发信号,给的是 kill(...) failed (1: Operation not permitted),都属于权限问题。要是真报 (2: No such file or directory),那才是 pid 路径写错、或者文件压根没生成。前两种 sudo 一下就过,与配置无关。
502 说明 nginx 连不上 upstream,跟本次 reload 有没有生效是两件事,别放在一起查。
nginx -t 报错的时候先看哪一行
-t 失败时最后一行永远是 configuration file … test failed,这行没有信息量,位置在它上面那行 [emerg]。
[emerg] 的格式是固定的:先给原因,再给文件名和行号,比如 nginx: [emerg] duplicate location "/api/" in /etc/nginx/conf.d/api.conf:42。行号指 include 文件里的行,不是主配置的行,conf.d 拆了很多文件时最容易搞混。
另一类 [emerg] 不带行号,形如 bind() to 0.0.0.0:8080 failed (98: Address already in use)。语法没问题,是端口被占了,查 ss -lntp | grep 8080 找占用者。
还有 -t 通过、reload 也返回 0、但 upstream 域名解析不到的情况。nginx 对 upstream 里的域名是在 reload 那一刻解析的,解析失败会让新 worker 起不来,日志里是 host not found in upstream。这类问题没有哪条nginx 命令能提前查出来,只能看 reload 之后的 error.log。
-t 通过只是必要条件,最终判断还是要回到进程号和响应上。
跑一遍 nginx -t,两行结尾都在,echo $? 打出来是 0。
ps 里 worker 的 pid 比 reload 之前新,ppid 还是那个 master。
error.log 从 reload 那一刻往后翻,只有 notice,没有 emerg。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- PHP如何读取文件?PHP简单读取文件函数及实例 2022-11-07
- Linux df -h 磁盘空间满了怎么办?5分钟定位大文件并清理 2026-07-02
- mysql连接报错2003是什么原因?先查端口再核监听地址 2026-11-11
- jquery常见交互动效失效?从引入到事件绑定的排查顺序 2026-11-22
- PHP的错误提示错误报告级别有哪些?如何关闭或屏蔽PHP错误报告提示 2022-11-30
- 前端跨域问题怎么解决?从控制台报错到响应头的排查顺序 2026-11-10