
mysql连接报错2003是什么原因?先查端口再核监听地址
- 2026年11月11日
- 49 次
机房那台老库服务器的托管合同月底到期,续费报价比新开一台云主机还贵,续不如换。新库的数据已经按逻辑备份导完,剩下把三台应用机的连接地址从旧内网 IP 改到新 IP。第一台改完,应用起不来,日志第一行就是mysql连接报错2003。库是活的,账号密码也没动过,问题只能出在网络这一层。
2003 是 TCP 层没连上,先看 3306 有没有在听
客户端在这一层报的 2003,和账号密码错的 1045 是两件事。1045 说明 TCP 已经连上、握手走到了认证阶段,只是 user@host 对不上;2003 是连接压根没建起来,客户端在 connect() 就失败,还没轮到验证密码。看到它,先去确认端口在不在听,别急着动 grant。
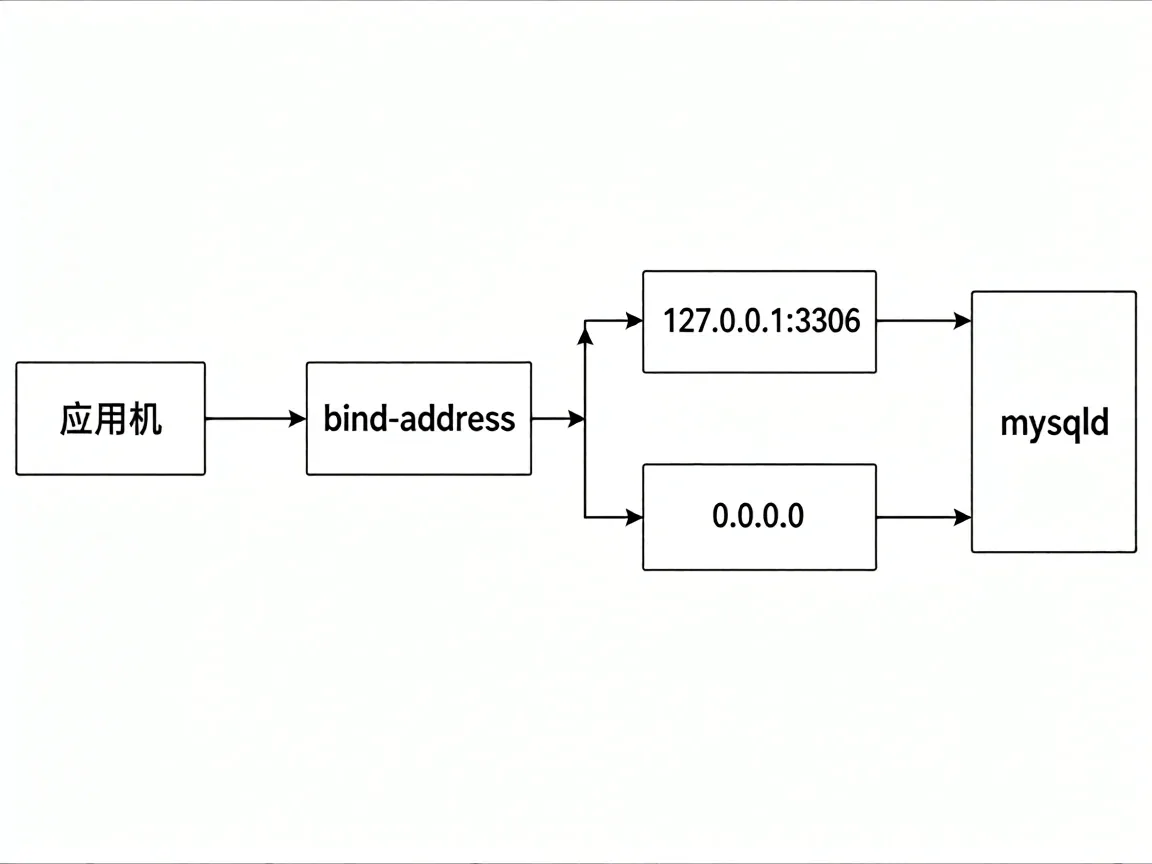
第一步,在数据库机器上跑一行:
ss -lntp | grep 3306老库上打出来的就是这一行:LISTEN 0 151 127.0.0.1:3306 0.0.0.0:*。第 4 列是本地地址,写的是 127.0.0.1:3306,既不是 0.0.0.0:3306,也不是新机器的内网地址。
答案就在这一列:mysqld 只绑了回环口,从别的机器发过来的包进不了它的监听队列,内核直接回 RST。
同一台机器上 mysql -h 127.0.0.1 -u root -p 是通的,这一点最容易误导人。它走的是回环,和从应用机发起的路径不是同一条,本机能进不代表远程能进。
完整的报错长这样:ERROR 2003 (HY000): Can't connect to MySQL server on '10.0.0.12' (111)。111 是 Linux 侧的 ECONNREFUSED,Windows 客户端同一个原因报的是 10061,Can't connect to MySQL server on '127.0.0.1' (10061)。数字不一样,指向的是同一件事。
bind-address 的取值决定谁能连进来
监听地址写在 my.cnf 的 bind-address 上。用包管理器装的 Debian/Ubuntu,配置常落在 /etc/mysql/mysql.conf.d/mysqld.cnf;CentOS 系一般是 /etc/my.cnf。老库上翻出来是这一行:
[mysqld]
bind-address = 127.0.0.1
改成 0.0.0.0 表示 IPv4 全地址监听,改成内网网卡地址则只在那张网卡上听。改完 systemctl restart mysqld,再跑一次 ss,第 4 列才会跟着变。
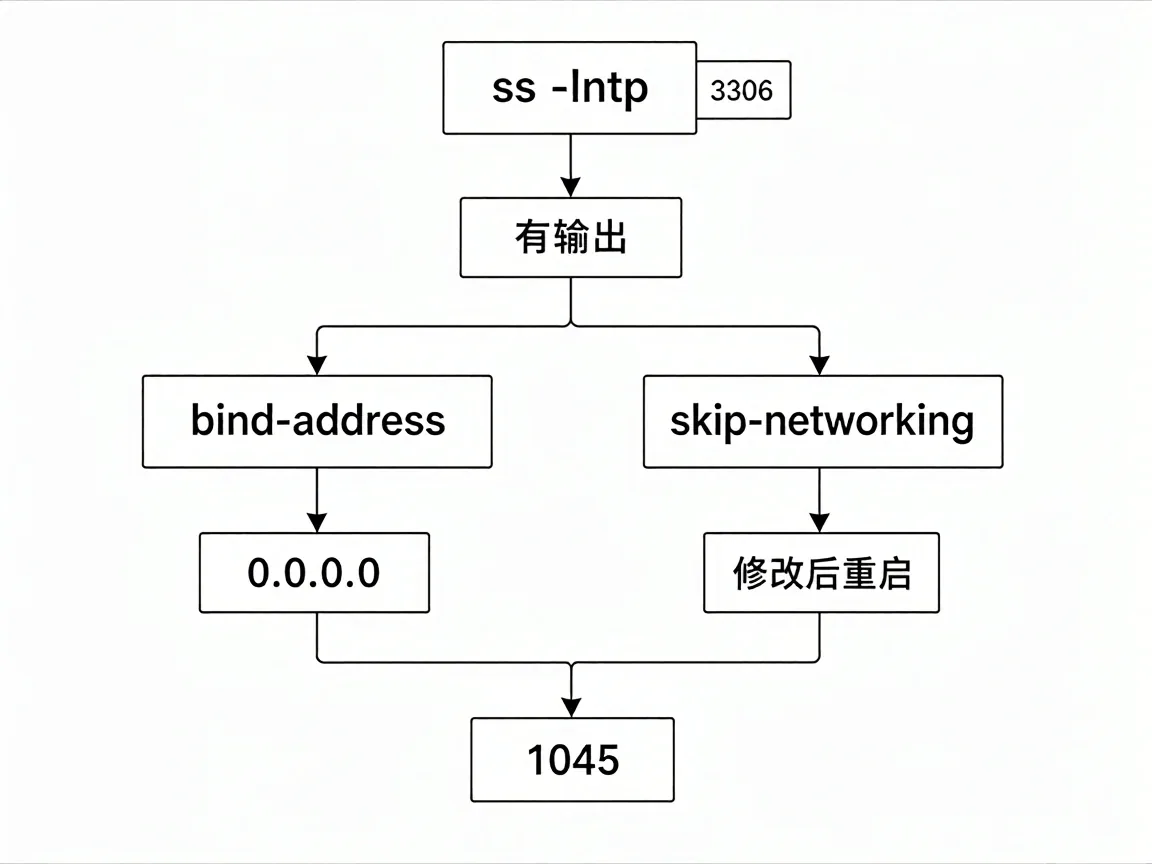
这里容易漏一层:改 bind-address 只解决「监听在哪」,不解决「谁能进来」。云主机的安全组、机器上的 iptables 或 nftables 是另外两道门,三层都对上才连得通。我给安全组只放了应用机那三段内网地址到 3306,0.0.0.0/0 没开。
skip-networking 打开时,端口压根不会出现
如果 ss 那条命令一行输出都没有,先别怀疑 grep。去配置里搜 skip-networking。
[mysqld]
skip-networking
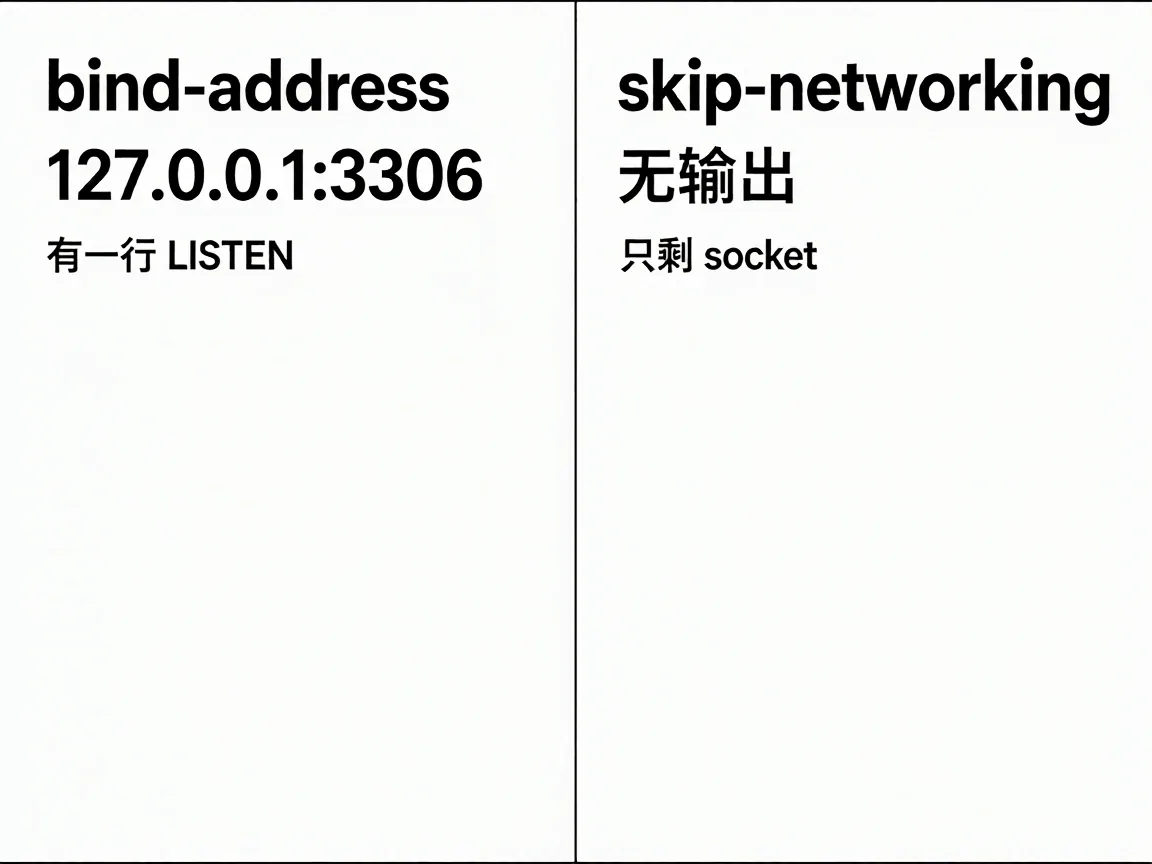
这个开关让 mysqld 不创建任何 TCP 监听,只留 unix socket。本机 mysql -S /var/run/mysqld/mysqld.sock -u root -p 照样进得去,跨机器一律失败,客户端拿到的还是同一个mysql连接报错2003。
它和 bind-address 写 127.0.0.1 的表现不同:后者 ss 还有一行 LISTEN,前者是空的。两种情形在客户端看来都是同一个mysql连接报错2003,要改的地方却完全不一样。区分它们,看 ss 有没有输出就够,不用去翻错误日志。
三种放开方式,按前提和代价挑一个
能让应用机连进来的一共三种做法,我把它们放在同一组维度上比:前提、代价、适用场景。
做法 A,bind-address 写 0.0.0.0。前提是机器在私有网络里、安全组能按源 IP 收口;代价是配置或规则错一次就是全公网可达,事后审计还得解释。
做法 B,bind-address 写内网网卡地址。前提是这张网卡地址固定、不随重启漂;代价是换机器或换网段要改配置并重启。
做法 C,bind-address 保持 127.0.0.1,应用侧走 SSH 隧道或本地代理。前提是应用机数量少、能接受多一层转发;代价是多一个要盯的进程,它断了应用就跟着断。
三种摆完,选择其实很清楚:A 最省配置,风险面最大;B 配置和风险都居中;C 不动数据库,把可用性押在隧道上。三台应用机都在同一个 VPC,库机器网卡地址是固定的,所以我选 B。
落地时写的是 bind-address = 10.0.0.12,不是 0.0.0.0。代价是以后换网段得改这一行再重启,restart 一次通常十几秒,实际看实例大小与版本,比全地址监听的暴露面划算。
C 留着兜底:哪天台数变多,或者临时要从办公室连一次,再开隧道,不必提前把所有机器都写进安全组。
改完之后的连接现象
重启后 ss 那行变成 LISTEN 0 151 10.0.0.12:3306 0.0.0.0:*,第 4 列从回环换成了内网地址。到应用机上直接测:mysql -h 10.0.0.12 -P 3306 -u app -p -e "select 1",能出结果就说明网络这关通了。
如果改完重启,应用机上还是同样的报错,那就不是监听地址的问题,回头去看安全组和本机防火墙,按源地址和端口两条规则逐条对。
要是报的是 ERROR 1045 (28000): Access denied for user 'app'@'10.0.0.31',层次就变了,卡在授权。MySQL 的账号是 user@host 两段,app@localhost 和 app@10.0.0.% 在库里是两个独立条目,只建了前者,从应用机连必然 1045。先通 TCP 再建账号,两步分开验,比一口气改完再看日志快。层次分清了,mysql连接报错2003和1045才不会混着查。
回头看这次换库,错在把「数据导完」当成了迁移完成,连接串一改就去起应用,没先在新库上确认监听地址。重来一次,顺序会倒过来:新库起来先跑 ss 看第 4 列,接着从应用机实测一次连接,确认通了再动应用配置。多花不过五分钟,代价能少掉一轮重启。当时三台都起了,其中一台带着定时任务,跑到一半被掐断,第二天补跑。配置本身只改了一行,那次报错的代价却摊在三台机器上。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- 建网站建设的流程 个人做网站该怎么做? 2022-11-09
- PHP explode() 和 implode() 函数详解:字符串与数组互转 2026-07-02
- 网站域名备案需要审核多久?网站域名备案审核的流程有哪些? 2023-01-15
- 备案域名如何注销?腾讯云取消备案流程 2022-10-17
- PHP全局变量与自定义函数的使用及PHP全局变量有哪些? 2022-10-10
- 网站打开慢命令怎么办?从解析到回源的排查顺序 2026-11-14