
网站打开慢命令怎么办?从解析到回源的排查顺序
- 2026年11月14日
- 40 次
dns=0.004 tcp=0.041 tls=0.052 ttfb=1.284 total=1.291 code=200。这组数字里建连只花了 41 毫秒,首字节却等到 1.28 秒,握手、证书、状态码全都正常,慢的那一段在被访问的一端。碰上网站打开慢命令怎么办这类问题,先弄到这样一组数字,比换服务器、加 CDN 都靠前,六个耗时已经把范围压到一段里。
curl 看首字节:一条命令把五个耗时拆开
这行数字是 curl 自带的 -w 打出来的。它的计时器比浏览器 F12 干净,没有 JS、没有并发连接、没有本地缓存,一次请求就是一次请求。
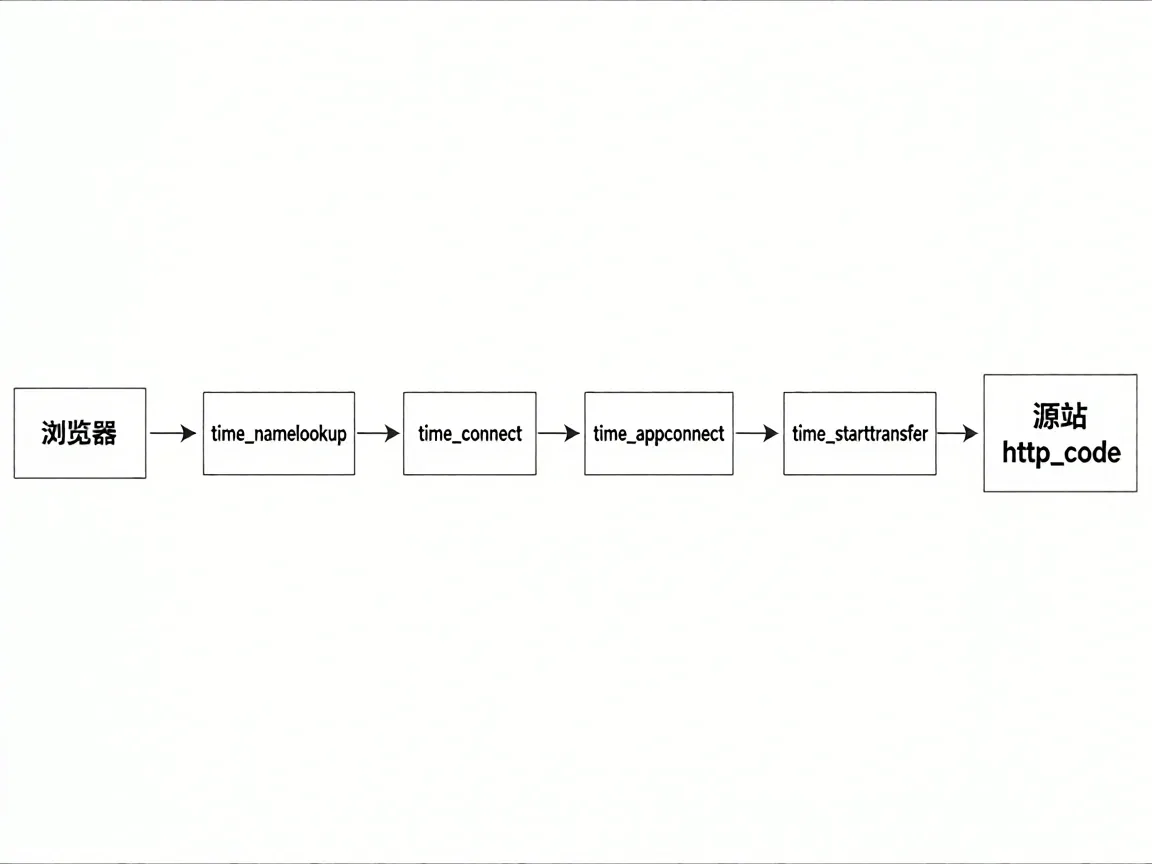
四个时间变量都是累计值,后一个包含前一个:time_namelookup 是解析完的时刻,time_connect 是 TCP 建连完,time_appconnect 是 TLS 握手完,time_starttransfer 是收到第一个字节。判断要看相邻两个的差,不要看绝对值。
curl -o /dev/null -s -w 'dns=%{time_namelookup} tcp=%{time_connect}
tls=%{time_appconnect} ttfb=%{time_starttransfer}
total=%{time_total} code=%{http_code}
' https://<你的域名>/
-o /dev/null 把响应体丢掉,-s 关掉进度条,屏幕上只剩三行数字。跑完应该看到 dns 和 tcp 在第一行、tls 和 ttfb 在第二行、总耗时和状态码在第三行;http_code 不是 200 的话,先把状态码这层解决掉,后面的耗时没有参考价值。
拿上面那行说:tcp 减 dns 是 37 毫秒,建连没问题;ttfb 减 tls 是 1.23 秒,这一段是等源站把第一个字节吐出来。前一段干净,后一段拖了一秒多,方向已经定了。
有个例外得留一手:只有 http 站点上 time_appconnect 恒为 0.000。https 就算前置了 CDN 或者反向代理,curl 也是先跟边缘节点握完手才发请求,这个数照常有值,别把它当成「没有 TLS」。真碰上它是 0 又确实是 https,先看命令里的 URL 有没有写成 http,再看中间是不是有一层把这请求接走并降级了。这种情况下 ttfb 减 tls 没有意义,改成 total 减 connect 去估服务器那一段。
到这儿,网站打开慢的原因就被切成两半:到达服务器之前(解析、建连、TLS),和进了服务器之后(排队、查库、拼页面)。后面的分支都沿着这条线走。
网站打开慢的原因:先排除解析和连接这两段
排错树往左走,第一刀是 DNS。time_namelookup 超过 100 毫秒就值得看一眼,同一个域名连跑三次差别很大,多半是本地缓存没命中。
dig <你的域名> +stats 的最后一行是 Query time,几十毫秒算正常。再换两个公共 DNS 对比:dig @223.5.5.5 <你的域名> 和 dig @8.8.8.8 <你的域名>,两边差出一倍以上,问题在本地那条递归链路上,不在你的服务器。
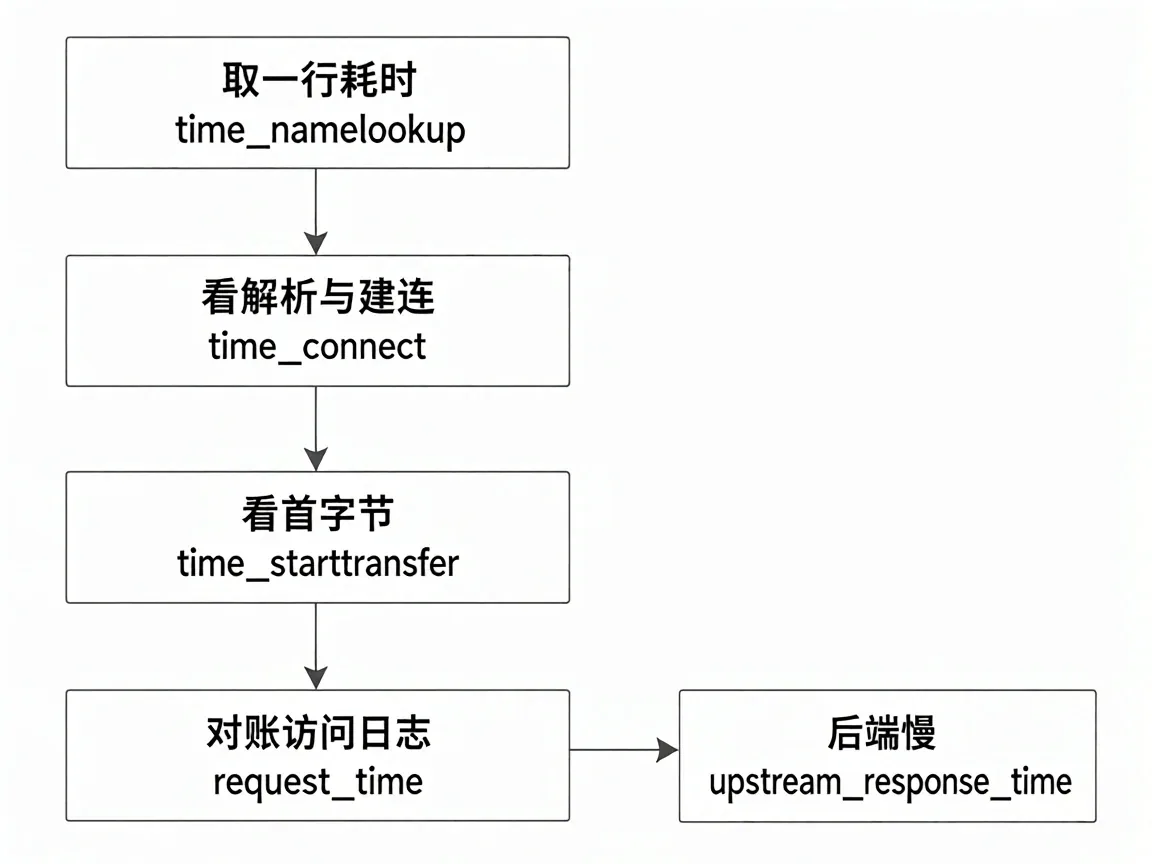
解析快、tcp 慢,是建连阶段。跨境线路丢包时 time_connect 会稳定在 200 毫秒以上,每次刷新都差不多——固定值说明是链路 RTT,偶发值才要怀疑拥塞。mtr -c 20 -r <你的域名> 能列出每一跳的丢包率,某个节点之后 Loss 一路涨,就是那一段。
还有一种会被误判成「服务器慢」的情况:域名解析到多个 A 记录,客户端按返回顺序连,第一个 IP 不通要等建连超时(Linux 默认几十秒)才换下一个,页面就白等这么久。绕开 DNS 直连某个 IP 验证:curl --resolve <你的域名>:443:<那个IP> -o /dev/null -s -w '%{time_connect}\n' https://<你的域名>/,几个 IP 各跑一次,耗时差出十倍就是它。
网络这一段干净了,再问网站打开慢命令怎么办,能查的只剩服务器内部。
回源这一段的耗时,去 access.log 里对账
客户端能看到的最后一个数字是 TTFB,再往里就得靠 nginx 自己的日志。剩下的时间花在哪,日志里的 rt 和 urt 写得最清楚,查网站打开慢命令怎么办问到这一步,也只能靠它回答。默认的 combined 格式不带计时字段,要在 http 块里加一行 log_format。
log_format timing '$remote_addr $request_uri $status '
                  'rt=$request_time urt=$upstream_response_time '
                  'ua=$upstream_addr';
nginx -t 通过再 reload,access.log 每行末尾会多出 rt=、urt=、ua= 三段。只对新请求生效,老日志不会补。
$request_time 是 nginx 收到第一个字节到把响应发完的时间,$upstream_response_time 是它等上游的时间。后者是 "-",说明这次请求没走上游,静态文件、或者 nginx 自己返回的 301 都是这个样子。
awk '{print $4, $5, $3, $2}' /var/log/nginx/access.log \
  | sort -t= -k2 -rn | head -5
字段位置和上面 log_format 的顺序对得上,第四个是 rt,第五个是 urt。按 rt 倒序取前五条,最慢的请求直接排在最前面,状态码和 URI 跟在后面。
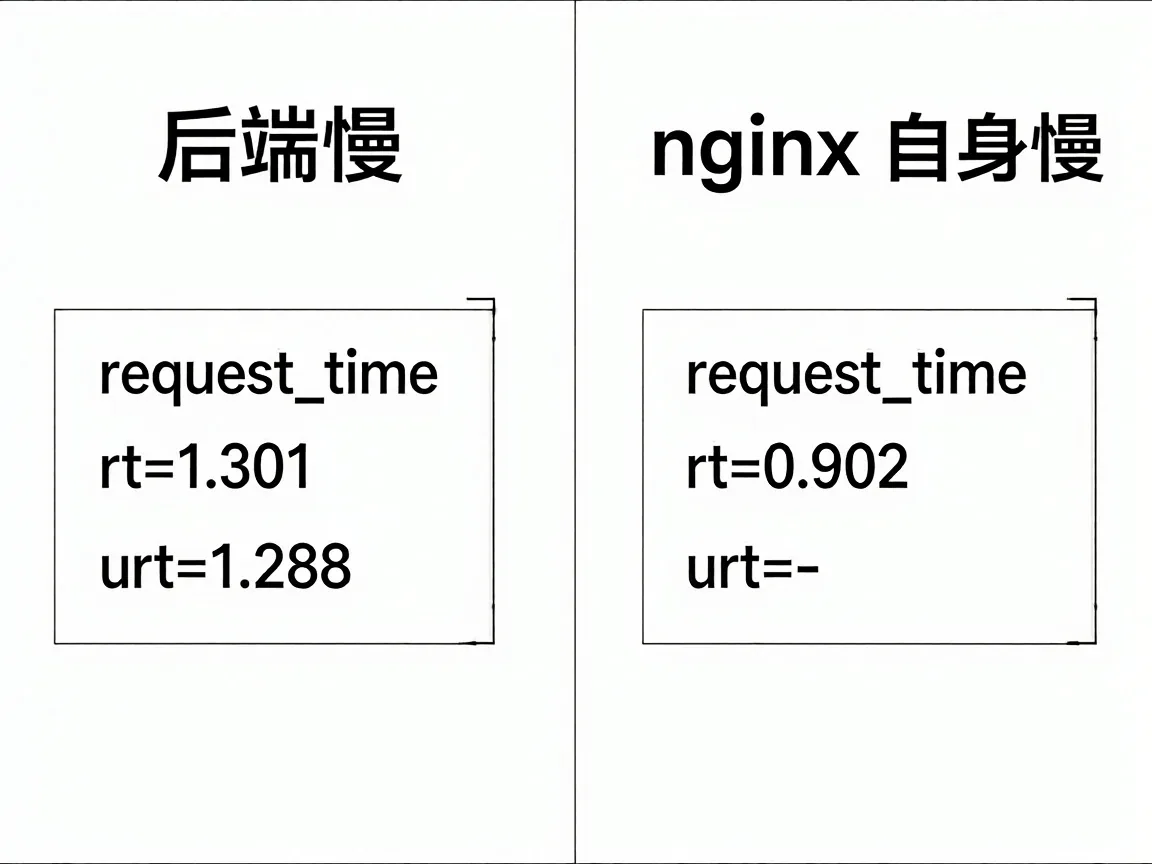
一条真实的长这样:rt=1.301 urt=1.288 200 /wp-json/wp/v2/posts。两个数几乎相等,nginx 自己没耽误,1.28 秒全压在 PHP 和数据库上,接下来该去翻 MySQL 的 slow query 或者 PHP-FPM 的 slowlog。另一种是 rt=0.902 urt=- 200 /static/app.css,没走上游却花了将近一秒,方向就换成磁盘 IO、gzip 压缩、或者 rewrite 打转。
还有 rt 大而 urt 小的:rt=3.002 urt=0.010,服务端早就返回了,时间卡在往外发。这时候要看 $body_bytes_sent 和客户端 IP,多半是响应体大,或者服务器出网带宽被别的请求占满了。
两个耗时放在一起比,往哪改就清楚了
把客户端和服务端的数摆在一起,四种组合对应的方向完全不同:
- ttfb 大、urt 也大:后端慢,查 SQL、外部接口、PHP 执行时间
- ttfb 大、urt 为 "-":nginx 自身慢,查磁盘、gzip、rewrite、大量小文件
- ttfb 小、total 大:传输慢,响应体太大或者出网带宽不够
- 两个都小但浏览器仍慢:前端的事,JS、图片、第三方脚本,curl 测不出来
第二种组合最容易被放过,因为 nginx 的 CPU 看上去是闲的。静态文件多、目录深、开了 gzip on the fly,单个请求的 rt 就会到几百毫秒,量一上来整体就垮了。
还有一个参照:同一条命令在自己电脑上跑一次、在服务器上跑一次,两个 total 一减,网络占了多少就出来了。服务器上那个数才是源站的真实处理时间,它和监控面板的平均值对不上时,一般以它为准,平均值会被大量快请求稀释掉。四种组合过一遍,下次再碰上网站打开慢命令怎么办,手上已经有一套现成的顺序,不用再从重启服务开始试。
把这行 -w 存成 alias,下次三秒出结果
每次手敲那串 -w,少打一个变量整行就错位,输出还得重新对齐。
在 ~/.bashrc 末尾加一行:alias ttfb='curl -o /dev/null -s -w "dns=%{time_namelookup} tcp=%{time_connect} tls=%{time_appconnect} ttfb=%{time_starttransfer} total=%{time_total} code=%{http_code}\n" https://',source ~/.bashrc 之后,ttfb 你的域名 就能出那六个数字。
%{...} 放在双引号里不会被 shell 展开,只会被 curl 解析;格式串用单引号也行,但整条 alias 已经套在外层单引号里,得换成双引号包住它。
今天的动作就一个:加完 alias,拿自己的域名跑一次,把这六个数字存成基线。以后页面变慢,先跑它,再看是解析、建连、TLS 还是源站那一段涨了,而不是从重启服务开始试。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- php如何连接mysql?两种扩展写法与连接失败排查 2026-11-13
- 怎么解析域名?从添加记录到生效验证的完整做法 2026-11-21
- PHP array_combine() 函数详解:用两个数组构造键值对 2026-07-02
- 自建Chevereto图床网站教程 拥有自己的图床网站 2021-12-27
- cdn加速与dns的关系:解析顺序、缓存生效与常见配置误区 2026-11-07
- 域名解析配置两个ip:轮询和故障切换的实际差别 2026-11-08