
robots协议如何查看?三个入口与三种返回状态
- 2026年11月19日
- 37 次
robots.txt 是放在站点根目录下的一份纯文本,用几行以 User-agent 起头的规则告诉爬虫哪些路径能抓、哪些别碰。它不用提交,也没有后台开关,文件能被公开读到就生效,读不到就按读不到的那一套走。至于robots协议如何查看,落到操作上是三件事:文件在哪个路径、从哪个入口读、读回来是什么状态。
三个入口分别落在哪
三个入口的可靠性差得远,查的顺序也就不该反过来。
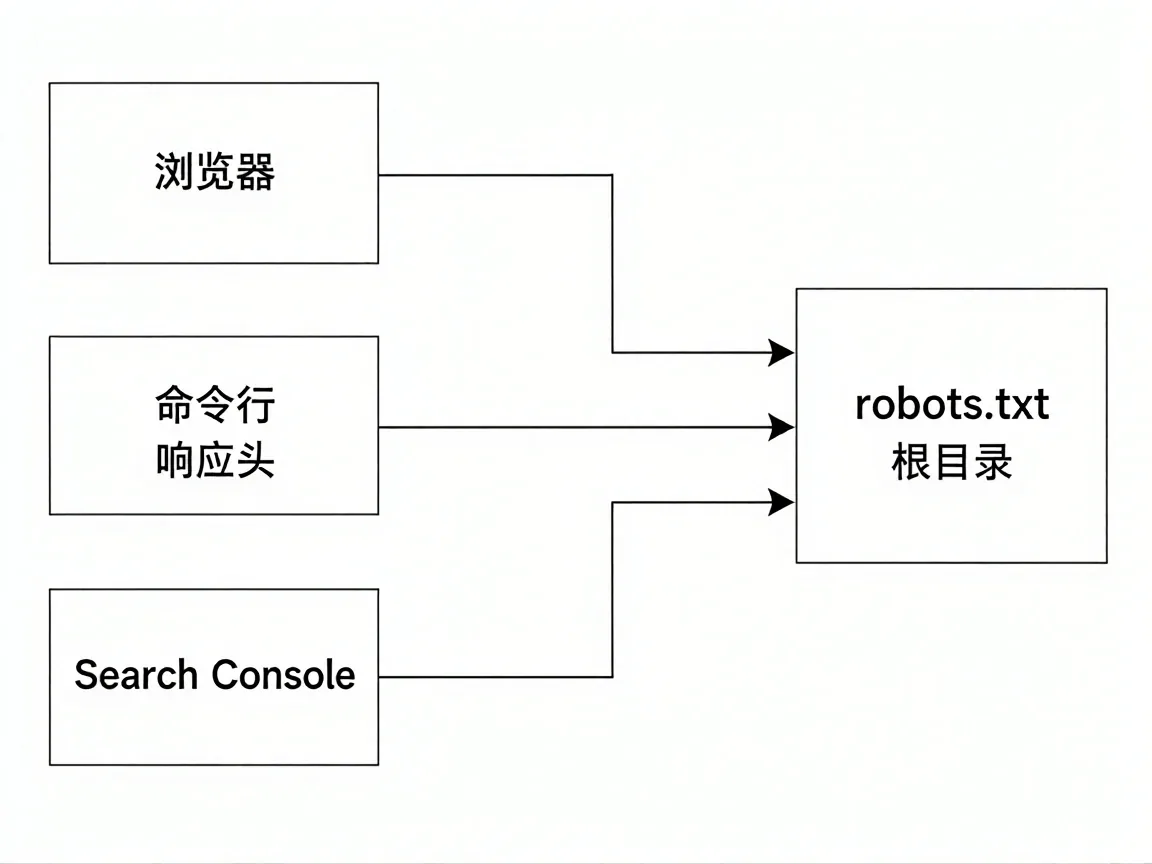
第一步走命令行,只看响应头:curl -I https://<你的域名>/robots.txt,Windows 下写成 curl.exe。输出第一行是状态码,往下几行里找 Content-Type。这一步把服务器给不给和文件内容对不对拆成两件事,这两件事经常被当成一件。
第二步是浏览器直接拼地址,域名后面加斜杠再接 robots.txt。它最快,能直接看内容,但只够回答文件在不在——浏览器会把 404 的错误页渲染成一张排好版的页面,看到的是模板,不是文件。
第三步是搜索引擎自己给的报告。Google Search Console 里的 robots.txt 报告、百度的抓取诊断,读的都是爬虫视角那一份,会指到具体哪一行解析失败、哪条规则挡了哪个地址。规则有没有生效,以这里为准。
三个入口各有盲区。要定的不是先后,而是每一层负责回答什么——robots协议如何查看,拆开就是这三层各管一段:命令行确认拿回来的是纯文本,浏览器看内容本身,报告确认爬虫那边的解析结果。反过来先看内容,容易在一份根本没生效的文件上改半天。
robots.txt 的位置只有根目录一处
路径没有变体,只有根目录那一份,域名后面直接接 robots.txt。
子目录里放一份不生效,爬虫不会去翻。www 和非 www 是两个主机名,http 和 https 也是两套,规则只对取到它的主机名、协议和端口有效,换个端口号都算另一处。
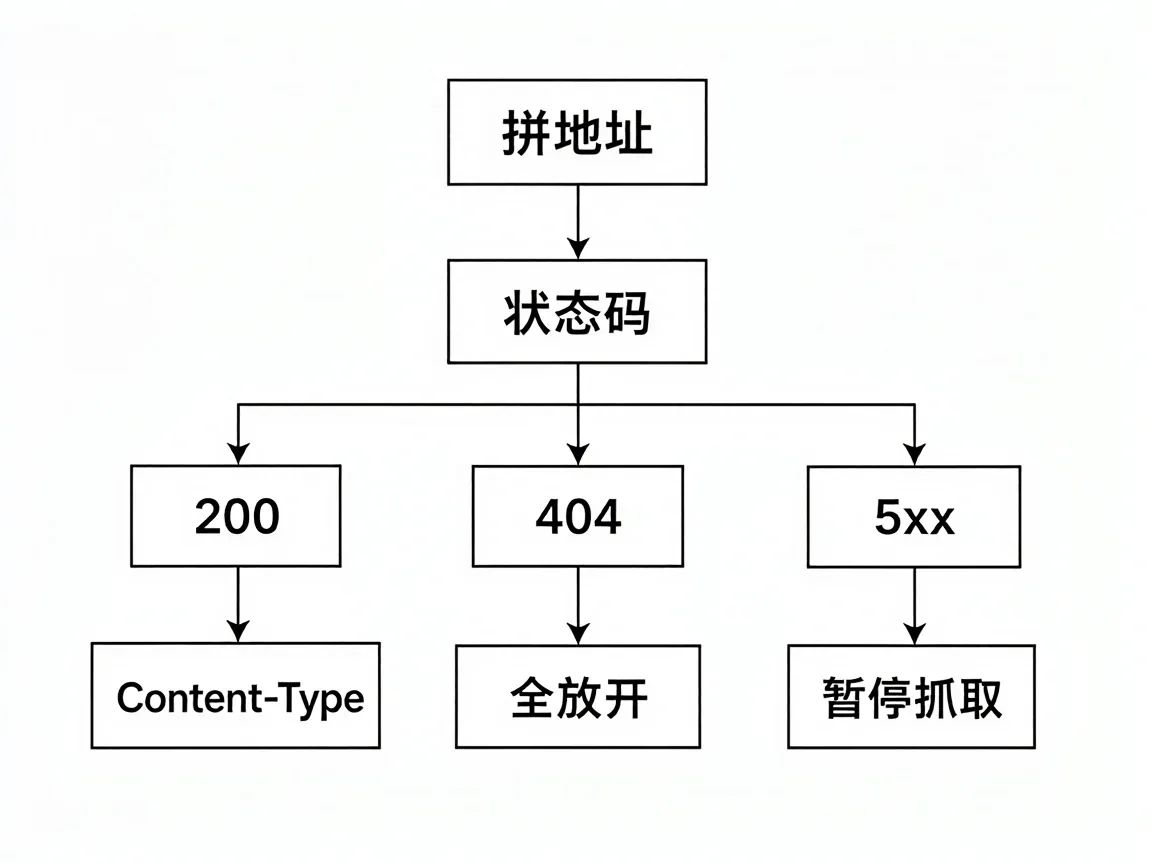
多域名站点出问题的概率最高。主站 www 配好了,裸域名没做跳转,裸域名那一份返回 404,等于对爬虫宣布这个域名随便抓。两个主机名各拼一遍,别只测一个。
返回状态码分成哪几种
状态码回来先分类,再决定要不要读内容。
这一步最容易跳过。
200 并且 Content-Type 是 text/plain,才算拿到文件本身。这一档也要看内容:单页应用把所有未知路径都交给首页兜底,robots.txt 会拿到一段 HTML,Content-Type 报的是 text/html,状态照样是 200。Google 遇到这种内容会照常解析,把看着像规则的行挑出来,其余丢掉——HTML 里没有一行符合规则格式,结果是一条规则也没读到。
4xx 除了 429,Google 按文件不存在处理,规则全放开。403 也在这一档,服务器不给看,结论却是随便抓。这条最反直觉:WAF 把 robots.txt 拦成 403,写好的 Disallow 一条都不会生效。另一些爬虫和采集库会把 403 当成拒绝信号直接停,同一份响应换一个爬虫来读,结果相反。
5xx 和 429 反过来,按服务器故障处理:前 12 小时暂停抓取并持续重试,之后最多 30 天沿用上一次抓到的版本,再往后才按无文件处理。我见过把 robots.txt 放进登录校验或者限流中间件,源站一忙就 500,全站抓取跟着停。
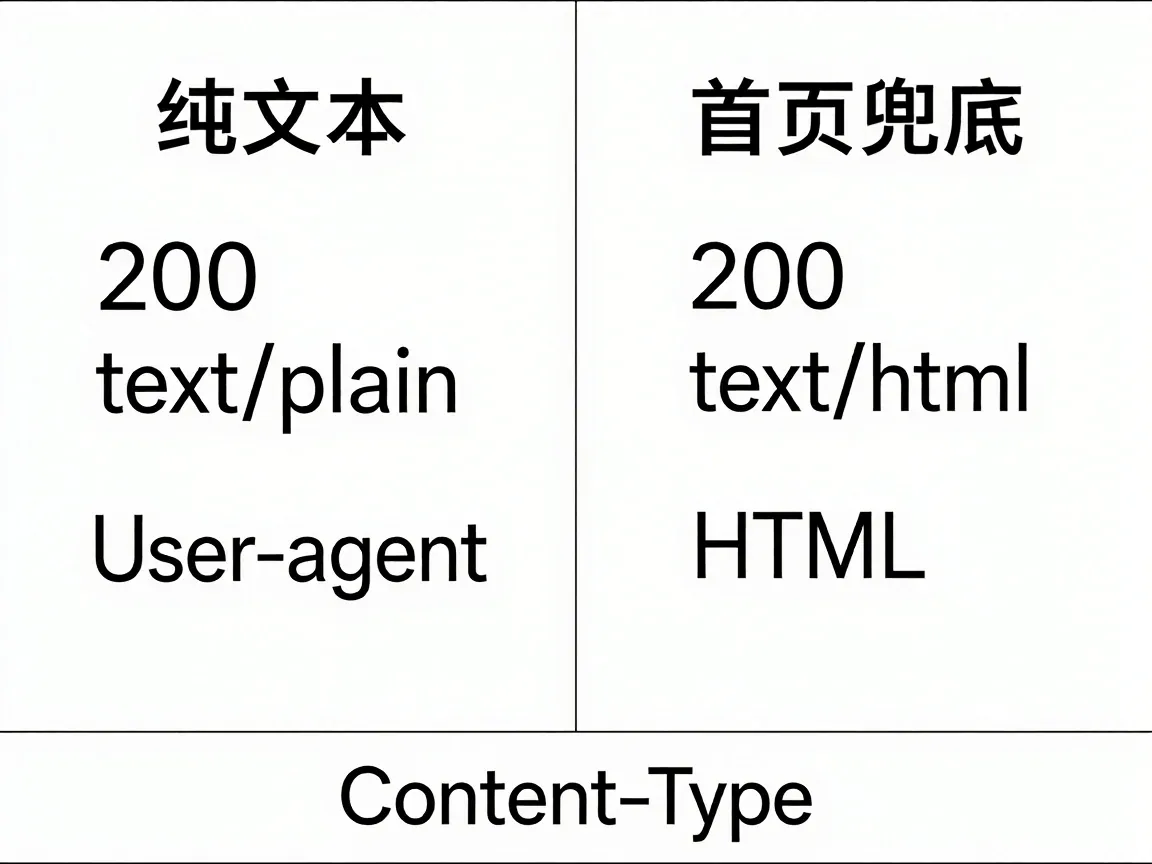
3xx 跳转不在这三类里,但也常见:跟随若干跳之后还没落地,Google 会当成 404 收尾。
读到的东西和预期不一样时
改完文件、刷新还是旧内容,先看响应头的 Last-Modified 有没有变。没变就是边缘节点压着上一版,跟文件无关。变了但爬虫没反应,那是缓存,Google 一般按一天左右缓存这份文件,急的话去 Search Console 请求重新抓取。
文件内容明明对,解析出来却是空的,多半是编码。非 UTF-8 存的 robots.txt,超出范围的字符会被吞掉,那一行就废了。BOM 在 Google 的规范里属于被忽略的无效行,它能兜住,别家不保证。
还有一种:规则堆到上千行,后面的本来就不会被读。Google 的上限是 500KB,超出部分直接忽略,把长尾规则挪进单独目录再整段屏蔽,比一条条列出来省力。
这几处改的都是读取方式,不是文件本身,而robots协议如何查看,问的常常就是这类读取侧的差异:换个主机名拼一遍、用爬虫的 UA 请求一次、清一遍边缘缓存,看到的结论就可能变。
这套查法什么时候不适用
站点在 CDN 或者 WAF 后面的时候,本地那份文件不代表爬虫拿到的内容,robots协议如何查看的重心也跟着挪到边缘节点上。中间层能改状态码、能替换正文、能按 UA 给不同结果,这时候要么在边缘节点上取,要么直接看平台报告里的原始响应。
多机房和灰度发布的站也一样,每个节点版本不一样,查到的那一份只代表那一台。
robots 也不是访问控制。它靠爬虫自觉,挡得住正经搜索引擎,挡不住不认这套规则的采集器。真要保护内容,用登录、用 401 验证,别指望这几行文本。
规则超过几十条、还要按不同 UA 分支的时候,手改的出错率高,让平台的校验工具跑一遍,或者改用 sitemap 加 noindex 处理具体页面。状态码正常就以为万事大吉,是这套流程最容易给出的错觉。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- 关键词布局区别与联系是什么?按栏目页和详情页分工 2026-11-13
- QQ邮箱在哪里找?QQ邮箱在QQ的什么位置? 2022-10-17
- css选择器优先级怎么算?四个权重位的比较顺序 2026-11-18
- 如何使用PHP函数制作一张简单的图片 使用PHP函数制作图片需要哪些函数 2022-11-21
- jquery判断class是否存在?三种写法与性能差别 2026-11-13
- Css3实现网站多彩tags标签云模块 2021-05-27