
rag知识库常见问题出在哪?按切片到检索的顺序排查
- 2026年11月12日
- 54 次
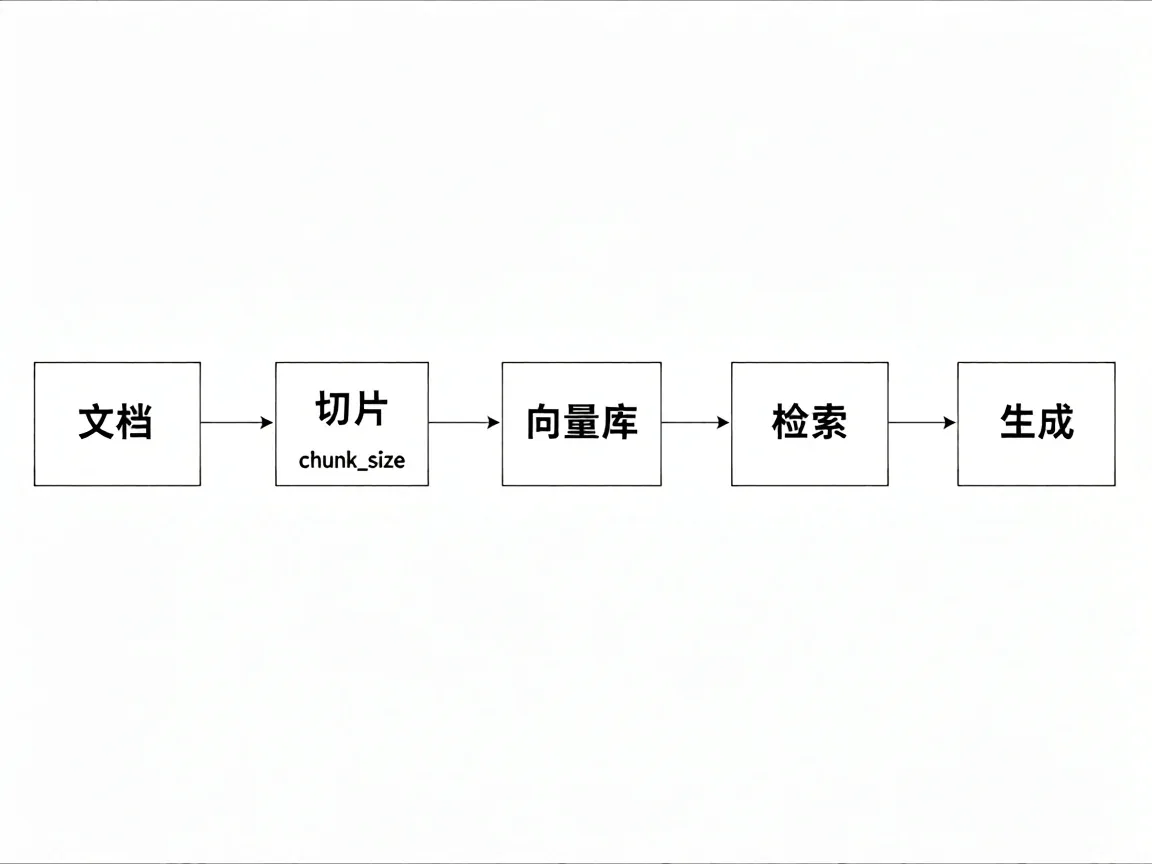
RAG 知识库的链路是五步:文档进来、切成块、编码进向量库、按相似度检索、最后交给模型组织答案,故障点就分布在这五段上。排查rag知识库常见问题时,从后往前猜最费时间:先怀疑模型、再改提示词,最后才回头看切片。检索链路上,切片决定召回的上限,召回数量决定模型看到多少材料,提示词只负责把已有材料写顺。
先查哪一环:切片、召回、提示词的三段排查
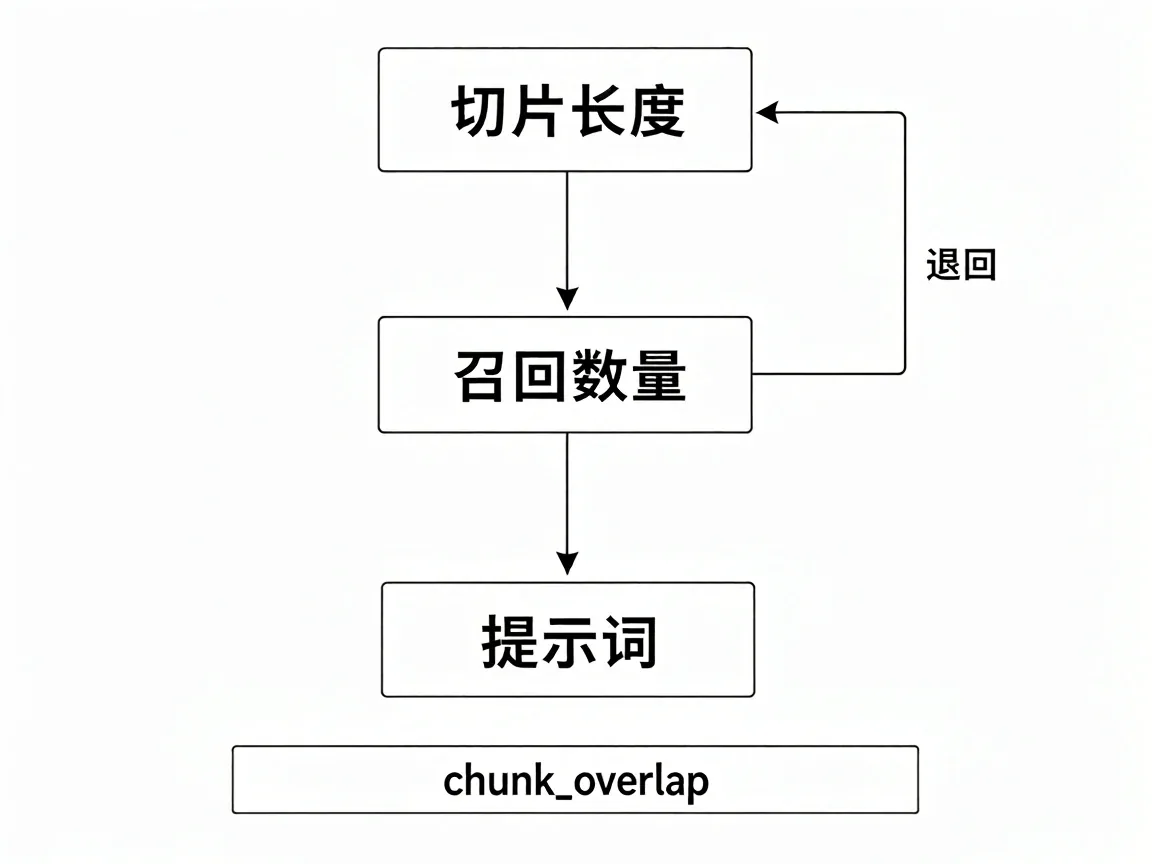
先查切片,再查召回,提示词放到最后。提示词只能重新组织已经进入上下文的内容,它变不出没被召回的材料;切片一旦把答案句拦腰切断,后面两步怎么调都补不回来。
判据可以压成一次实验,十分钟能做完:把这次命中的块原文完整贴进一个空白对话,只留一句「依据以下材料回答」。答对了,问题在拼接、截断或提示词;答错了,材料本身就没进来,往上退一步。这一步能过滤掉大半答非所问。
链路本身的形状是这样,故障只会从左边三个环节往右传导。
五段里只有切片和召回会造成「材料缺失」。向量库那一层除非索引没建全,否则很少是原因,索引重建、维度不一致这类故障会直接报错,不会表现成答非所问。生成这一步只负责组织语言,它拿到什么就写什么。
起点和落点定下来,接下来是逐环量参数。每次改动前把当前参数抄进 notes.md,后面才知道是哪一次改动起的作用;没有基线,改完只能凭感觉说好像好点了,说不清是哪一步起的作用。
第一步:切片长度与重叠先量后定
切片是唯一一处改错了、后面全白改的地方。手上有一份约 4 万字符的产品手册,chunk_size 给 500、chunk_overlap 给 50,切完先量一遍再谈调优。
import statistics

lens = [len(c) for c in chunks]
print(len(chunks), round(statistics.mean(lens)), max(lens))
输出是 96 471 500:96 块,平均 471 字符,最长顶到 500。三个数要一起看,平均值离上限只差 6%,说明切点基本按长度走;平均掉到 300 出头,那是被标题和空行切碎了,得回头检查段落是不是本来就短。
中文里字符数和 token 数不成正比,500 字符对应多少 token,得拿自己的 tokenizer 数一遍才算数,别照别人的估算表推。
把 chunk_overlap 从 50 提到 200,为了语义更连贯,同一份文档输出变成 135 498 500。块数多了 39 条,向量库里也就多出 39 条内容高度相似的记录。
200 字符在中文里常常跨两三个自然段,相邻块的结尾和开头直接重合。overlap 覆盖一个完整句子就够,给到整段长度是纯浪费。最后按 100 落地,后面的例子都用这一版量出来的数据。
切片的偏差不会自己暴露,这种不报错的偏移最难查:分数照样正常,答出来的东西就是差一点。
切片调平了问题还在,就按这个顺序继续,别跳过中间那环直接改提示词。
顺序的价值在于排除。每一步都有明确的出口条件,通过了才往下,没通过就退回上一步改参数,而不是在提示词里加限定词硬掰。
第二步:检索召回数量的调整配合上下文预算
top_k 是最容易被随手调大的参数。LangChain 的 similarity_search 默认给 k=4,我们那层封装压到 3,很多人一看材料少就随手加到 10。
先把召回的块打印出来,别只看分数。下面的循环要在切分时打开 add_start_index=True,否则 metadata 里没有那个键,直接 KeyError。
for doc, score in zip(docs, scores):
    print(round(score, 3), doc.metadata["start_index"], doc.page_content[:30])
每行开头是相似度,中间是这一块在原文里的字符偏移,后面是前 30 个字。分数分布比绝对值有用:前三名 0.82、0.79、0.61 这种断崖,说明只有前两块真相关,top_k 给 3 就够。
start_index 是用来回原文核对的。有一次一条命中块的 start_index 是 18420,块长 500,覆盖到 18920;回原文一搜,答案句在 18850,已经贴到块尾。下一块从 18820 起,又把它收了进去——重叠 100 的代价就在这,一句能写完的答案被切在两个块里,top_k=3 时上下文里出现两段重复文字。
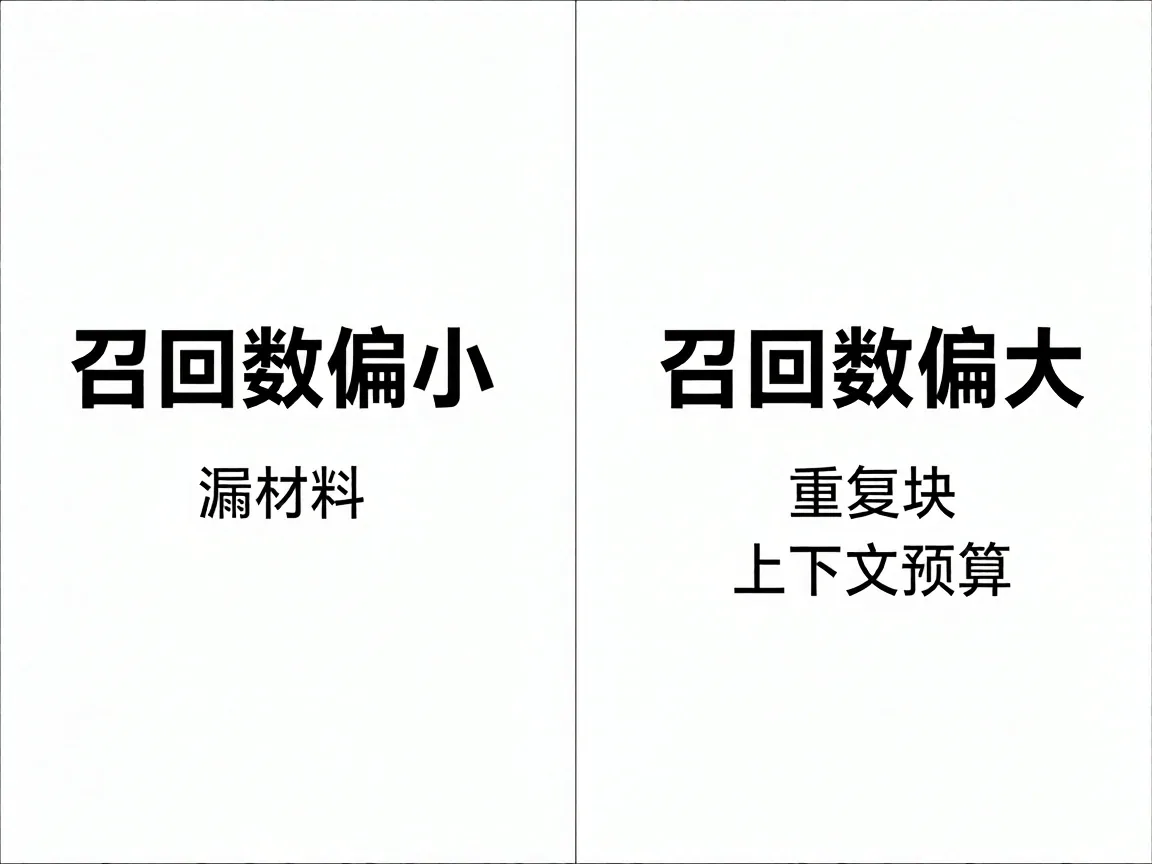
重复内容进上下文有两个代价:占掉预算,把真正需要的材料挤出窗口;也让模型把同一句话说两遍。
块数乘以每块长度就是上下文预算,rag知识库常见问题里这一项最容易被忽略。500 字符的块,top_k 给 10 就是 5000 字符打底,再加上系统提示和历史,留给答案的空间很薄。阈值按预算反推:先定能塞多少字符,再除以平均块长,得到的才是可用的 top_k。
召回数偏小会漏材料,召回数偏大时多出来的常常是重复块。判断边界不看数字:第 4 条之后如果只是同一段的不同切法,多给的那几条没有新信息,该退回去调切片,而不是继续加 top_k。
第三步:重排和提示词放在最后
切片和召回都过一遍,rag知识库常见问题通常已经定位到八成。走到这一步,前提是切片量过、召回里看得见答案句。两项都满足,答案还是散的,才轮到重排和提示词。
重排改的是顺序,不改材料集合。同一个 query,纯向量召回的前三条是概述段、术语表、第四章,加了重排之后第四章那条升到第一位,概述段掉到第五。判断它有没有用,看第一条是不是直接回答问题的段落,不看分数涨了多少。
提示词只该做两件事:约束输出格式,规定没找到材料时怎么答。「请仔细阅读以上内容」对召回没有任何影响,写得再多也补不上缺的那块。
到这一步还在反复改提示词,通常说明前面某一步的出口条件没验证过,rag知识库常见问题十有八九卡在这一步。
交付前的自查:两条命令加一步抽查
打印 len(chunks)、平均长度和最大长度,平均低于上限七成就把 chunk_size 往上调一档,最大长度贴住上限就去查文档里有没有超长段落。
同一个 query 分别用 top_k=3 和 top_k=8 跑一遍,两份上下文并排贴出来,第 4 条之后没有新信息就停在 3。
拿 start_index 回原文定位命中的块,答案句不在块里的比例超过三成,说明切片边界压到了答案,改 overlap 之后再看召回。这一条要人眼看,跑不出来。
两条命令加一步抽查做完,多数情况能落到具体某一环,改动也就有据可依。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- Windows11报错0xD1为什么花屏?先查驱动再查内存 2026-11-13
- PHP array_combine() 函数详解:用两个数组构造键值对 2026-07-02
- 抖音发布时间段流量增加,按粉丝在线时段排发布表 2026-11-14
- PHP in_array()、array_search()、array_key_exists() 查找函数对比 2026-07-02
- windows11命令提示符修复电脑怎么用?四步排查顺序 2026-11-16
- python语言学习:学习python第一天 2021-01-19