
正则表达式匹配字母怎么写?字符类与边界一次说清
- 2026年11月10日
- 14 次
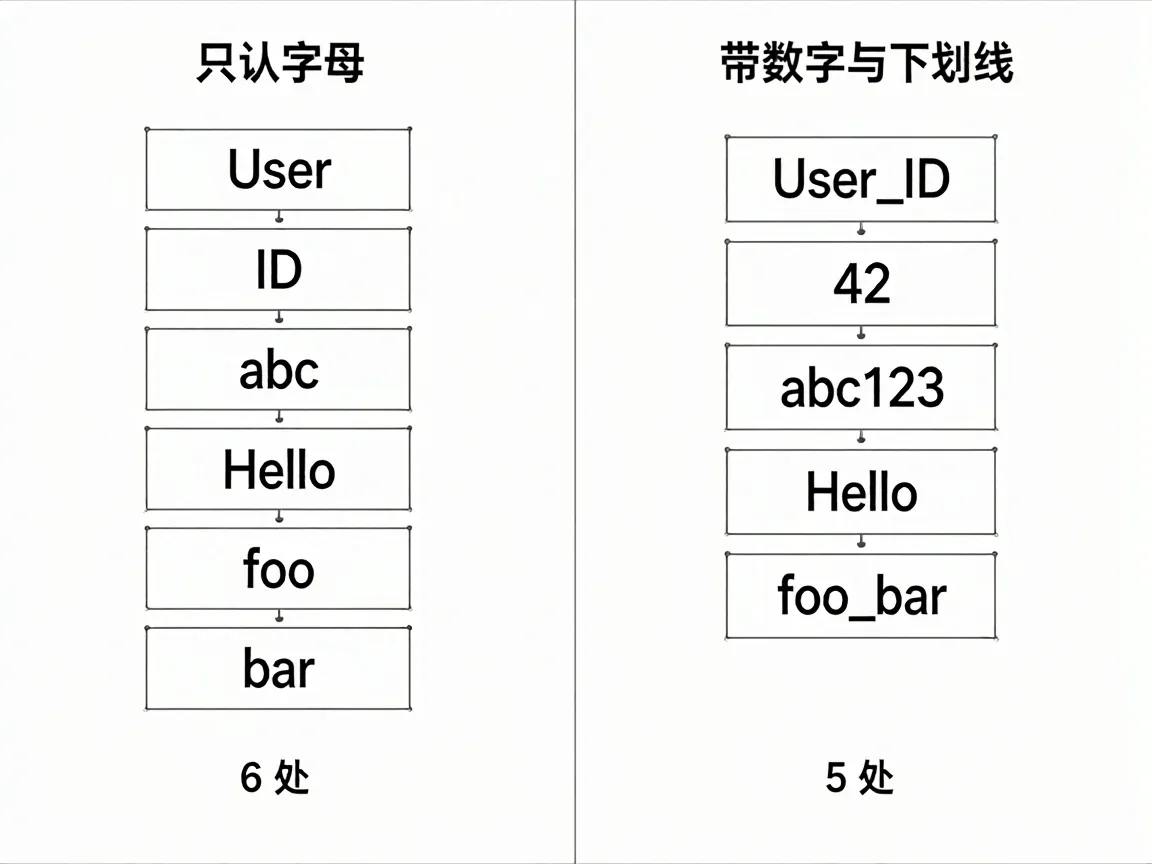
/[a-zA-Z]+/ 在一串 34 字符的文本上命中 6 处,/[a-zA-Z0-9_]+/ 只有 5 处。那串是 User_ID 42 abc123 Hello 中文 foo_bar,差的是 User_ID 被拆成 User、ID。真正的难点不在写,正则表达式匹配字母难在选:[a-zA-Z] 把标识符切成两段,[a-zA-Z0-9_] 保住整块。同一段文本,两种字符范围,6 和 5 的差距就从这里来,拿自己的数据跑一遍比背表管用。
先给能跑的答案
按用途分三种。整串校验只允许字母,用 /^[a-zA-Z]+$/;从文本里捞出一串字母,用 /[a-zA-Z]+/;口径是编程标识符,用 /[a-zA-Z0-9_]+/。第三种严格说不算「字母」,但 user_id、abc123 这类值,只有纯字母那版会从中间断开。
上机跑一遍比读字符类表快:
<?php
$text = 'User_ID 42 abc123 Hello 中文 foo_bar';

var_dump(preg_match('/^[a-zA-Z]+$/', $text));   // int(0)

preg_match_all('/[a-zA-Z]+/', $text, $words);
print_r($words[0]);   // User, ID, abc, Hello, foo, bar

preg_match_all('/[a-zA-Z0-9_]+/', $text, $ids);
print_r($ids[0]);     // User_ID, 42, abc123, Hello, foo_bar
var_dump 那行是 int(0) 而不是 false,意思是没匹配上,不是正则写错了。preg_match 里 0 和 false 是两件事,后者才代表模式本身有语法问题,判断时必须用 === false。
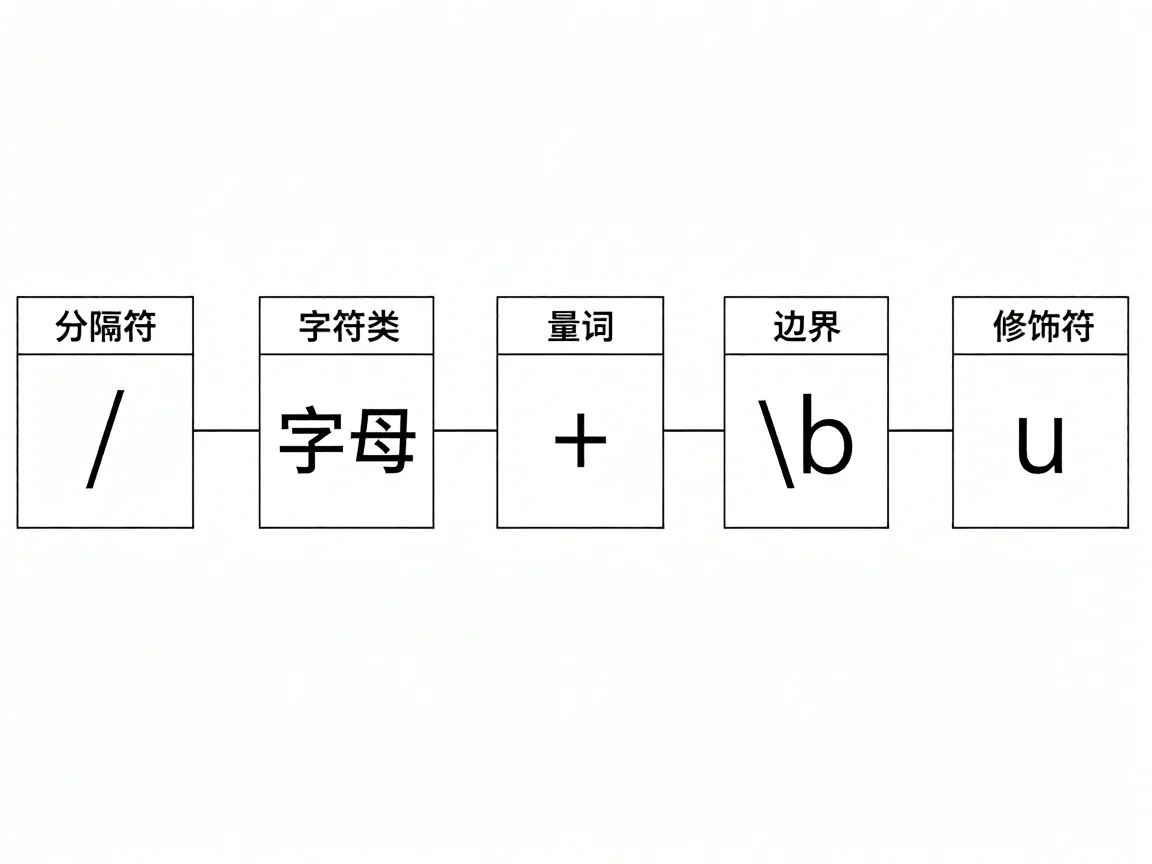
一条模式拆开只有五块:分隔符、字符类、量词、边界、修饰符。/^[a-zA-Z]+$/ 里两个 / 是分隔符,[a-zA-Z] 是字符类,+ 是量词,^ 和 $ 是边界,末尾还能挂 u、i 这类修饰符。出错时先定位是哪一块,比整条重写省时间。
分隔符也可以换。模式本来就要匹配 /,比如 URL 路径,用 ~^/api/[a-z]+$~ 就省掉一串转义,读起来清楚得多。
字符类里的 a-z 与 A-Z
字符类匹配的是「一个位置上的一个字符」,[a-z] 表示这个位置可以是 a 到 z 中任意一个,不是「a、减号、z 三个字符」,也不是一整段字符串。方括号里的 - 夹在两个字符中间才是范围,写在开头或结尾就是字面量的减号。
a-z 只覆盖 26 个小写 ASCII 字母,A-Z 再补 26 个大写。少了后一半,User 就躲过去了。写正则表达式匹配字母时最常见的失误就在这里:拿小写范围去扫混合大小写的数据,结果不是 0 处,而是错位的一处。
preg_match('/[a-z]+/', $text, $m) 返回 int(1),$m[0] 是 ser——它从 User 的第二个字符起步。有结果但结果不对,比返回 0 更难发现,因为没有报错。
字母范围写成 [a-zA-Z] 之后,和 \w 是两套口径。\w 等于 [A-Za-z0-9_],/\w+/ 在 user_id 42 abc 上给出 user_id、42、abc 三项,和 /[a-zA-Z0-9_]+/ 的结果一模一样。要纯字母用前者,要整段标识符直接用 \w 更短。
顺序也不能写反。[a-zA-Z] 和 [A-Za-z] 等价,但 [z-a] 直接编译失败,warning 原文是 range out of order in character class。遇到 false 先看这行 warning,它把出错类型写得很清楚。
边界符防止匹配到单词中间
\b 是零宽断言,不消费字符,只检查当前位置左侧和右侧是不是「一边单词字符、一边不是」。PCRE 默认的单词字符是 [A-Za-z0-9_],包含下划线和数字,这比多数人以为的范围要宽。
\b[a-z]+ 在 abc123 上的行为:\b 卡在 a 前面成立,[a-z]+ 吃掉 abc,匹配到此结束,末尾没有 \b,123 不影响结果。/[a-z]+/ 没有这个约束,可以从任意位置起步。边界符是正则表达式匹配字母时最容易被跳过的一步。
两端都加 \b 是另一种结果。/\b[a-z]+\b/ 扫 abc123 def,只拿到 def。abc123 整段被排除,因为字符类吃到 abc 就断了,后面还连着数字,末尾构不成边界。
带上 PREG_OFFSET_CAPTURE 就能看见位置:
$text = 'User_ID 42 abc123 Hello 中文 foo_bar';

preg_match('/[a-z]+/', $text, $m);
print_r($m);   // [0] => ser

preg_match('/\b[a-z]+/', $text, $m, PREG_OFFSET_CAPTURE);
print_r($m);   // [0] => abc, [1] => 11
11 是 abc 在原始串里的字节偏移:User_ID 加后面的空格占 8 个字节,42 加空格占 3 个,正好 11。
^ 和 $ 是另一种边界,管整串首尾;\b 管单词首尾。校验字段用前者,提取词组用后者。往提取用的模式里塞 ^,等于要求从整串第一个字符开始匹配,漏掉的比抓到的多。
用 preg_match 验证正则表达式匹配字母的结果
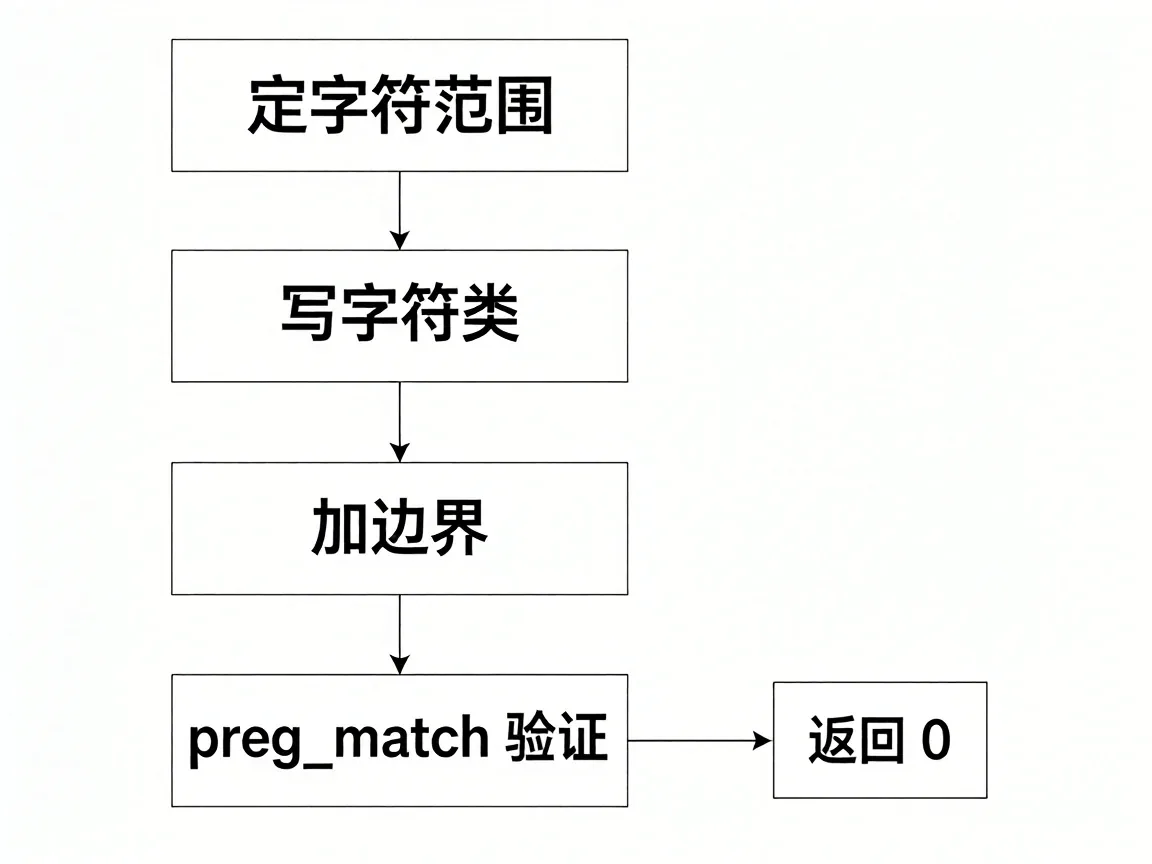
四步,顺序别换。
第一步 定字符范围。数据里有没有大写、数字、下划线、中文,每类各挑一行样本出来,别照字段名猜。
第二步 写字符类。纯字母 [a-zA-Z],标识符 [a-zA-Z0-9_] 或 \w,Unicode 字母 \p{L},后者要带 u。
第三步 加边界。整串校验套 ^...$,词组提取套 \b。
第四步 跑验证,先看返回值再看数组。1 有匹配,0 无匹配,false 是模式本身有问题。从日志里取请求方法这类活,/(GET|POST) / 跑一遍就知道有没有漏,不必逐行扫。
字符类管不到的地方
[a-zA-Z] 只认 ASCII。café 里的 é 不在范围内,扫出来会变成 caf、na、ve 三段,一个词被劈成两半。换成 \p{L} 并加 u,才能拿到完整的 café 和 naïve。
中文更彻底,[a-z] 完全不沾边,要汉字就写 \p{Han}:
preg_match_all('/\p{Han}+/u', '订单abc编号XYZ', $cn);
print_r($cn[0]);   // 订单, 编号
/u 不能省。省了以后按字节走,一个汉字被当成三个字节分别判断,匹配位置和长度都会乱。
\b 在中文上的结论得先看开没开修饰符,笼统说「失效」是不对的。
不带 u 时 PHP 按字节走,汉字的每个字节都算非单词字符,\b 只会落在 ASCII 与汉字的接缝上。/\b[a-z]+/ 扫「订单abc编号XYZ」,拿到的是 abc 和 XYZ,汉字一个都抓不到。带 u 但没启用 PCRE_UCP 时,汉字同样不算单词字符,「订单」两侧都算边界,加不加 \b 结果一样。真开了 UCP,汉字算单词字符,结论又反过来。
要汉字就别绕这一圈:\p{Han}+ 配 u,不要往上叠 \b。
大小写还有一条捷径:/[a-z]+/i 就能匹配 ABC,i 让整条模式忽略大小写。改 i 比把字符类补成 [a-zA-Z] 快,但两者不完全等价——i 会作用到模式里所有字母,包括你本来只想写小写的部分。
还有一层边界是代价。字符类本身没有回溯风险,但写成 ([a-zA-Z]+)*,或者让 .* 和 + 叠在长文本上,就会撞上 pcre.backtrack_limit,preg_match 返回 false。这个 false 和语法错的 false 长得一样,得靠 warning 和 preg_last_error() 分开。
字符类决定匹配什么,边界决定不匹配什么。我现在的习惯是把边界先钉死,再回头收敛字符类,改的轮次比反过来少很多。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- 正则表达式匹配纯数字 正则表达式如何匹配数字 2022-11-07
- wordpress古腾堡小工具切换成经典小工具 2022-09-25
- git命令提交代码add和commit有什么区别?分工与顺序 2026-11-10
- PHP中正则表达式修正符有哪些?PHP正则表达式修正符如何使用 2022-10-31
- PHP简单的内置日期函数有哪些?PHP年月日时分秒时间代码 2022-10-11
- PHP自定义回调函数简单实例 对PHP自定义回调函数的运用理解 2022-10-04