
python列表的最大值最小值怎么取?三个函数加一次遍历
- 2026年11月10日
- 13 次
报表那边催了两次,最高价和最低库存要跟明细一起出,不能再等人手工抄。旧脚本先给整个列表排序再取两端,明细从两万条涨到二十万条之后,这一步成了链路里最慢的一环。抽公共函数时,就把python列表的最大值最小值一起重写了一遍,最后只留三条规矩:能一次扫完的不排序,空列表要有默认值,按字段取极值交给 key。
第一步:取两端,max() 和 min() 各扫一遍
最大值用 max(lst),最小值用 min(lst)。两个函数都只遍历一次,碰到不能比较的元素当场抛异常,不会给你一个半对的结果。列表里是纯数字或者纯字符串,到这一步就结束了。
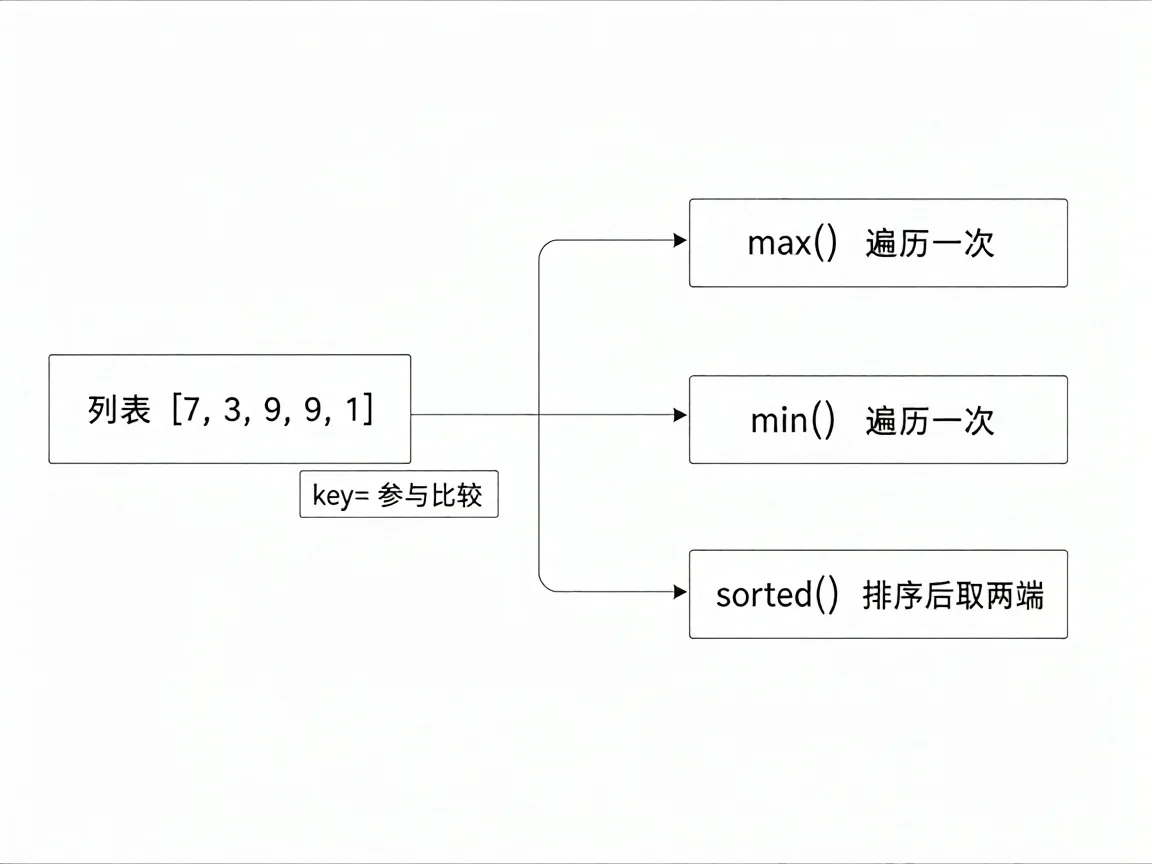
传参形式有两种,max(3, 7, 2) 和 max([3, 7, 2]) 都返回 7。写成多个位置参数时按参数比,传一个列表时按元素比,混着传,比如 max(1, 2, [3]),照样是 TypeError。
还有个更常见的误用:max("python") 返回的是 "y"。字符串自己就是可迭代对象,函数拿到七个字符,比的是码位,不是整个词。
prices = [12.5, 30, 8.75, 41, 19]
print(max(prices), min(prices))       # 41 8.75

words = ["pear", "apple", "zebra"]
print(max(words), min(words))         # zebra apple
输出是 zebra 和 apple:三个词首字母分别是 p、a、z,比完就定了,跟单词长短没关系。想按长度取,得写 max(words, key=len)。
如果元素是字典,第一步那两行会直接失败,报 TypeError: '>' not supported between instances of 'dict' and 'dict'。不是数据脏了,是函数不知道拿哪个字段来比,这时候才轮到 key 参数。
第二步:内置的 max() 与 min() 是两趟,能合并就合并
取python列表的最大值最小值,两个函数各自完整走一遍列表,同时要最高和最低就是两趟。数据在内存里、只在请求末尾算一次,两趟可以接受;写在 for 循环里对每一行都调一次,代价就翻倍了。合并的写法不复杂:一个循环维护两个变量,每来一个元素比两次,第一个元素同时赋给两边,不用另设哨兵值。
def both_ends(seq):
    it = iter(seq)
    try:
        first = next(it)
    except StopIteration:
        raise ValueError("both_ends() arg is an empty sequence")
    lo = hi = first
    for x in it:
        if x > hi:
            hi = x
        elif x < lo:
            lo = x
    return hi, lo

print(both_ends([7, 3, 9, 1]))   # (9, 1)
空序列在这里抛的是自己写的 ValueError,跟 max() 的报错类型一致,外面那层 except 不用改。注意 elif:一个元素不可能同时比 hi 大又比 lo 小,用 if 多比一次是白花。
在生成器上,这一点会直接变成错误。gen = (x for x in data) 走完 max(gen) 之后,再调 min(gen) 拿到的是空序列,抛 ValueError: min() arg is an empty sequence。生成器只能消费一次,两个端点必须在同一轮里取出来。
rows = [{"sku": "A1", "price": 12}, {"sku": "B2", "price": 30}]
top = max(rows, key=lambda r: r["price"])
print(top)            # {'sku': 'B2', 'price': 30}
print(top["price"])   # 30
key= 那个 lambda 的返回值只参与比较,max 返回的仍然是原始元素。第一行拿到的是整个 dict,要数字还得再取一层。sorted(rows, key=...) 同样如此,排完拿到的是 dict 列表,不是价格列表。
能这么取,靠的是每个 dict 都有 price 这个键。少一个键就在这里 KeyError,比大小之前先确认字段齐不齐,比事后回滚省时间。
第三步:要下标、要前三个,换另外两套写法
只想拿值,第一步那两行就够。要下标,别 lst.index(max(lst)) 这样串着写,那是三趟,而且并列最大值时只能拿到第一个的位置。真走到这一步,python列表的最大值最小值就不止两个函数了,得先看你想要的是值、位置,还是一批值。
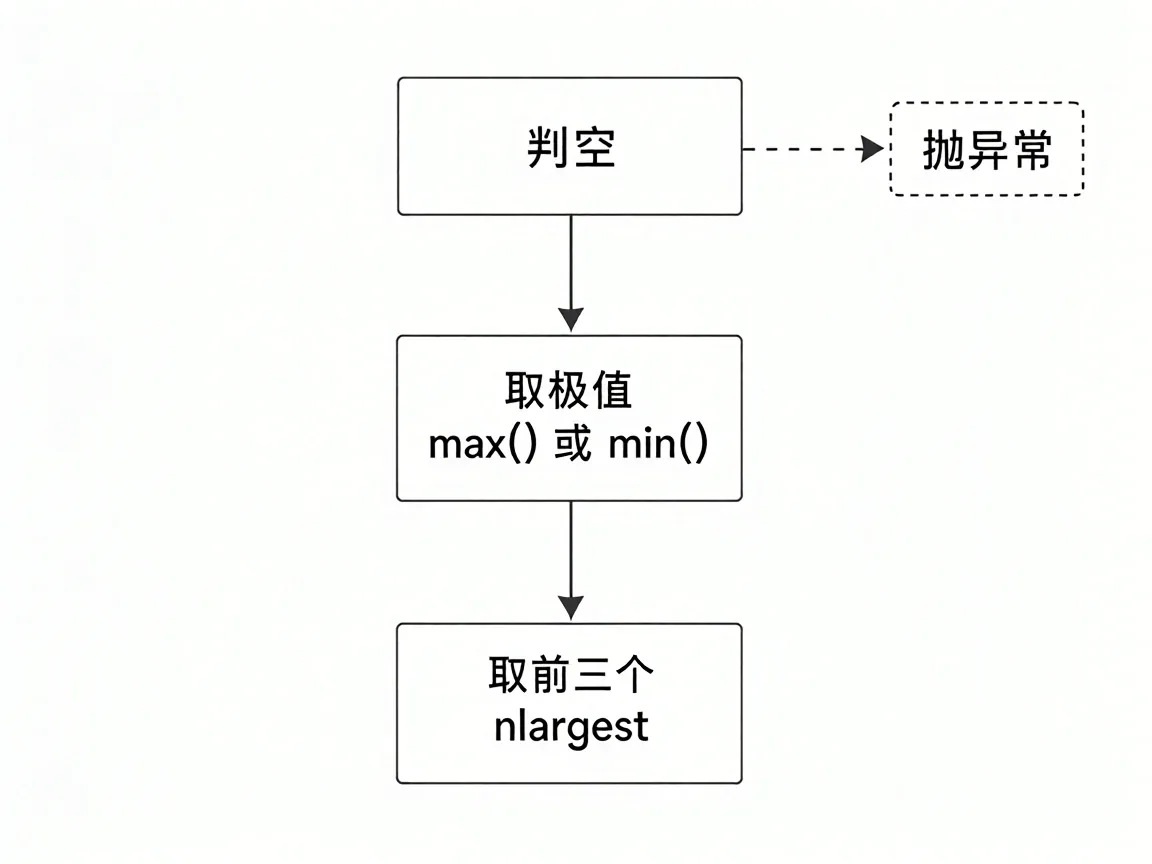
一步到位的写法,是把下标和值一起交给 max:
import heapq
nums = [7, 3, 9, 9, 1]
print(max(enumerate(nums), key=lambda p: p[1]))  # (2, 9)
print(heapq.nlargest(2, nums))                   # [9, 9]
print(sorted(nums)[-2:])                         # [9, 9]
输出里的 2 是第一个 9 的下标,第二个 9 在 3 号位。并列时函数返回先出现的那个,这条规则在 enumerate 写法里同样成立。
要前三个、前十个,sorted 切片和 heapq.nlargest 都能给,差别在代价:sorted() 先把整个列表排完再切,O(n log n);nlargest 维护一个大小为 k 的堆,k 远小于 n 时才占优。k 接近 n 的时候,直接排序更直接。
还有个容易被 max 绕过去的场景:取第二大。连着调两次 max 没用,两次都返回同一个 9。得先把重复值去掉,sorted(set(nums))[-2] 在 [7, 3, 9, 9, 1] 上给 7,heapq.nlargest(2, set(nums))[-1] 同理。少了 set 这一步,nlargest(2)[-1] 拿到的还是 9,等于没改。列表只有几十个元素,挑哪个写法都行,纠结的时间比跑一次还长。
空列表和字符串混排的边界
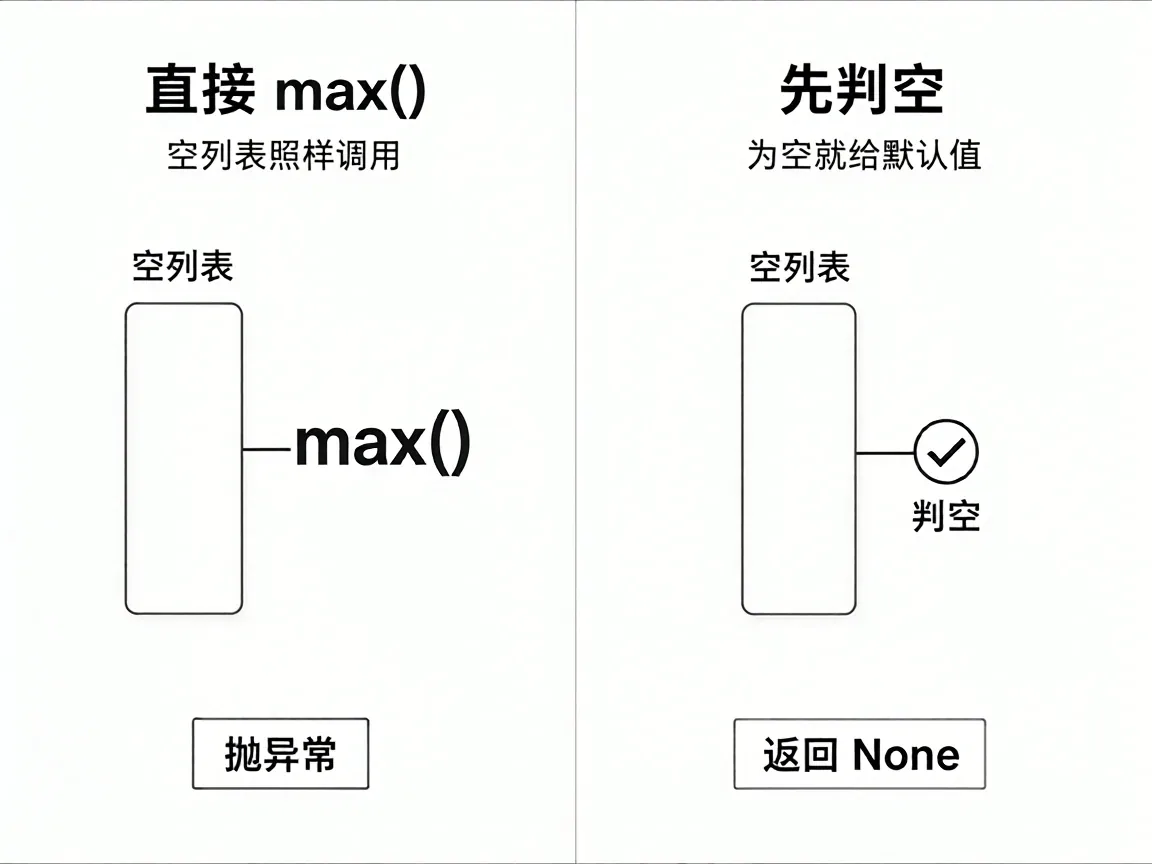
空列表是第一个容易漏的地方,报错原文是 ValueError: max() arg is an empty sequence。注意是 ValueError,不是 IndexError,except 里写错类型就接不住。
三种处理各有适用面。接口返回可能为空、上层要区分"没有数据"和"最小值是 0",用 max(lst, default=None),返回 None;确认是数字列表、0 可以当兜底,用 default=0;逻辑里本来就要判空,if not lst 提前 return,比 default 更清楚。
default 只在序列为空时生效。max([3, 1], default=None) 还是 3,不会因为写了 default 就改变非空时的结果。生成器也一样,max((x for x in []), default=0) 给 0,去掉 default 同样抛那句 ValueError。
类型这一层才是python列表的最大值最小值最容易出错的地方。max(["a", 1]) 直接 TypeError: '>' not supported between instances of 'str' and 'int',两个类型之间没有大小关系,函数不会替你转换。
更隐蔽的是全是字符串的情况,它不报错,只给错答案。从 CSV 读出来的列是 str,max(["10", "9", "100"]) 返回 "9",因为逐位比的时候 9 大于 1。要么读入时 float() 转掉,要么在 key 里转,别让字符串参与比较。
浮点列里混进 nan 也不会报错,结果取决于它落在哪个位置。nan 在第一个,max([float("nan"), 1, 2]) 返回 nan;nan 在后面,max([1, float("nan"), 2]) 返回 2。跟 nan 做的比较全是 False,指针就停在原位。清洗时 dropna 或者先过滤,比在 max 上打补丁稳。
交之前跑这三行
data = [] 先跑一次 max(data),确认抛的是 ValueError 而不是别的,异常类型对不上说明外层包错了层。
再跑 max(data, default=None),返回值应该是 None。拿到 0 或者空字符串,说明 default 写成了别的值。
最后用 type(max(rows, key=lambda r: r["price"])) 看一眼,是 dict 就对了,key 只参与比较,没有替换返回值。
三行都过,这段逻辑可以合进去;python列表的最大值最小值剩下没覆盖的,只有 nan 那种跟位置有关的怪情况。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- 备案域名如何注销?腾讯云取消备案流程 2022-10-17
- PHP cURL 实战教程:从入门到 REST API 调用 2026-06-30
- Python循环中continue和break的用法和区别 2021-08-02
- Python进入help(str)帮助文档后如何回到原有代码段? 2021-07-28
- git命令提交代码add和commit有什么区别?分工与顺序 2026-11-10
- Python列表推导式生成100以内的偶数实例 2021-11-22