
两条路跑本地模型,llama.cpp和ollama区别在参数
- 2026年11月10日
- 13 次
我现在跑本地模型用两套配置:调参压测走 llama-server,把模型分给同事用 ollama。用下来我的判断很直接:llama.cpp和ollama区别不在支持多少模型格式,而在参数由谁填——一边我自己写在命令行上,一边中间层先补一遍默认值,再转手交给同一个推理引擎。我自己的脚本里这两样都写死了,但同事直接用 ollama run 时,出问题的全是默认值。
这个说法有边界。只挂一个模型、只发短问题的时候,两边的默认值都够用,差别体感不到;一旦上下文过万、显存装不下整个模型、或者几个客户端同时打进来,封装层替你做的那些决定就开始变成故障源。
按症状走:回答开始漏内容看第一支,吐字变慢看第二支,接口连不上看第三支,单人正常而多人一起用才变慢看第四支。
两层的分工:ollama的封装层下面还是 llama.cpp
ollama 起服务时拉一个 runner 进程,这个 runner 就是 llama.cpp 编出来的可执行文件。日志里那些 llm_load_tensors、llama_new_context_with_model 全是它打的,跟在自己机器上跑 llama-server 看到的一模一样。Modelfile 里的 PARAMETER 行只是换了名字:num_ctx 对应 -c,num_gpu 对应 -ngl,num_thread 对应 -t,num_batch 对应 -b。llama-server 那边没有这层翻译,你写什么它收什么。
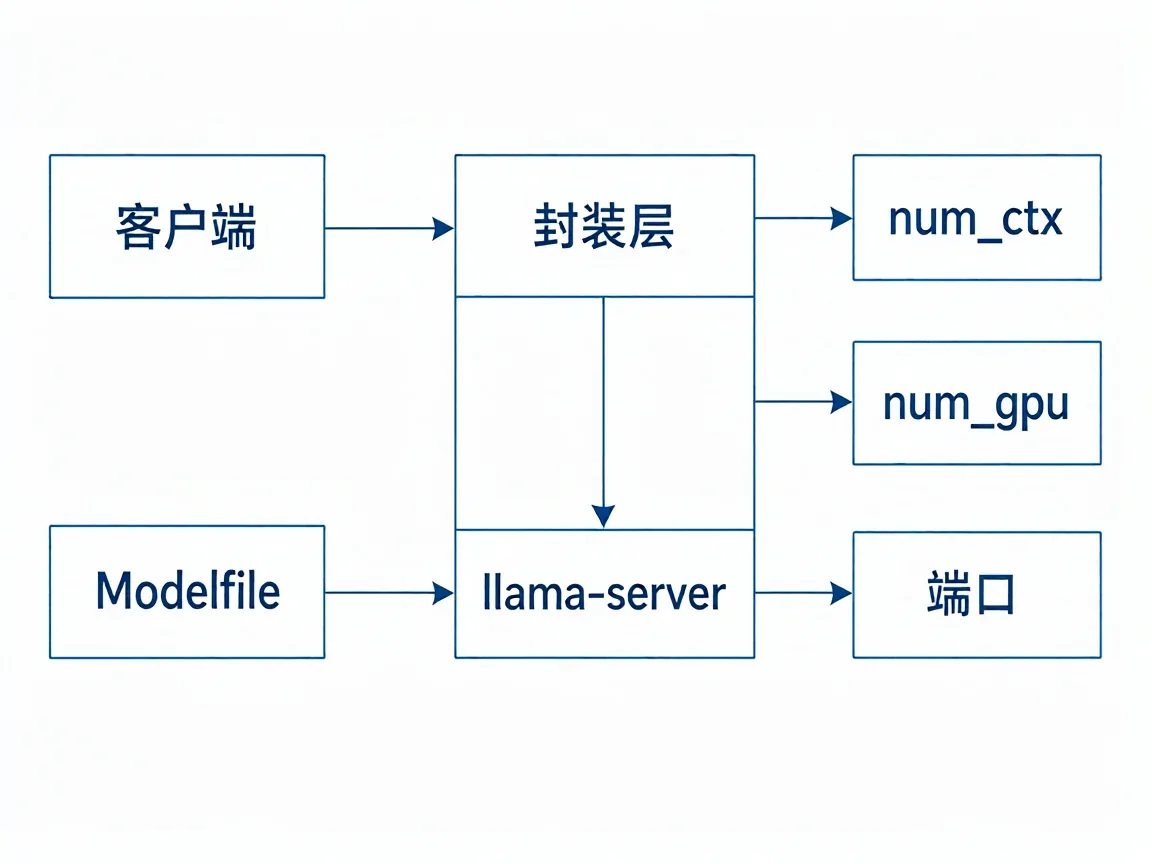
说是两套引擎并不对,llama.cpp和ollama区别其实只有一层封装的距离。
参数名对不上,是这条路上最先撞到的一堵墙。某个参数你在 Modelfile 里写了、跑起来却没变化,问题多半不在引擎,在它有没有真的落到 runner 的启动命令行上。
反过来也有需要甩开中间层的时候:要自己控采样、要按核绑线程、要把服务挂到自己的反向代理后面,直接起 llama-server 就少一层变量。
症状一:长文答非所问,先量 num_ctx
封装层默认给的 num_ctx 是 2048,这个数字改过几版,以官方文档为准。2048 个 token 够一段日常对话,塞一份带表格的说明书进去,前半截会被静默截掉——不报错,模型只是像没看见你的 system prompt。
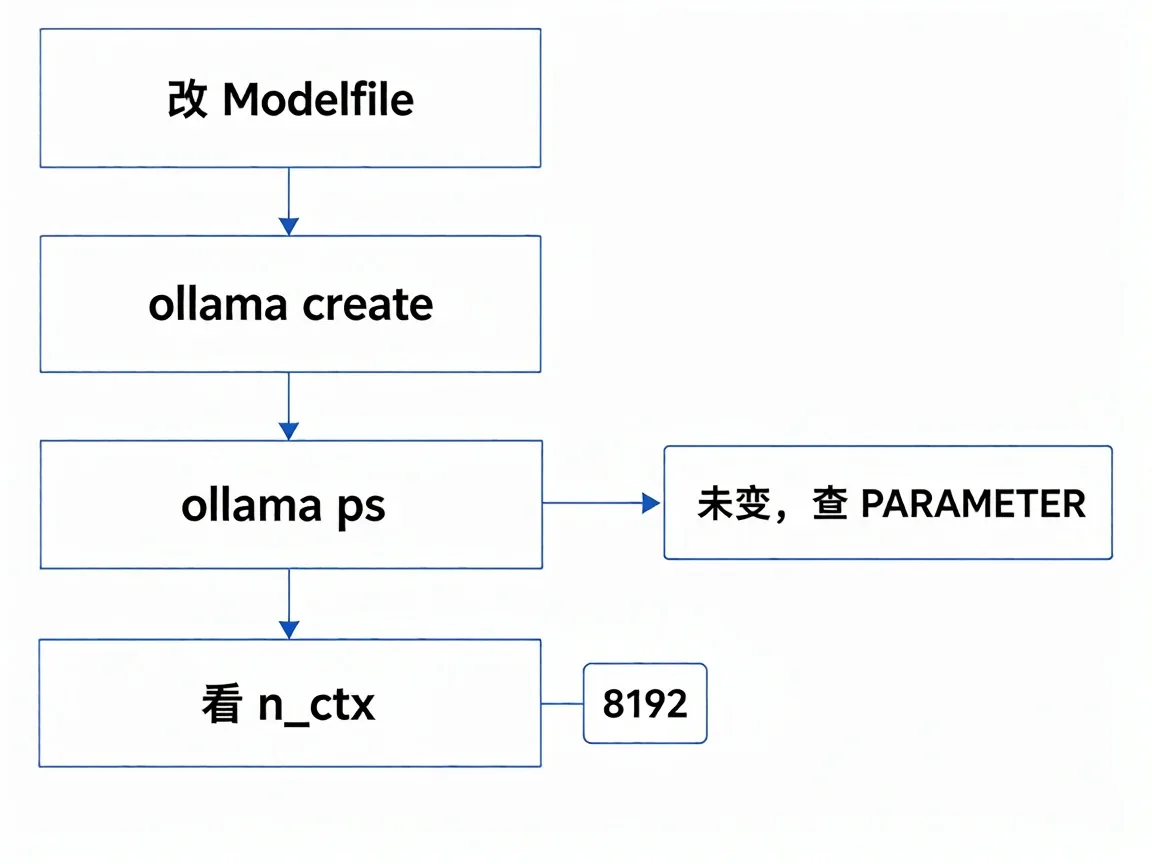
要量的是 runner 真实拿到的值,不是你在 Modelfile 里写的值:
ollama ps
journalctl -u ollama -n 80 --no-pager | grep -E "n_ctx|offloaded"
第一行列出已加载的模型、占的显存和 PROCESSOR 列;第二行里 n_ctx = 2048 出自 llama_new_context_with_model,那个才是生效值。
这条命令有个前提:ollama 得是 systemd 服务装出来的 Linux。macOS 装的是 App 或 brew 包,Windows 用安装程序,docker 起的在容器里,三种都没有这个 unit,执行会直接 command not found。换成前台 ollama serve 看 stderr,或者 docker logs <容器名> | grep n_ctx,打出来的是同一行。
改法写进 Modelfile,别直接覆盖已经建好的模型名:
cat > Modelfile <<'EOF'
FROM qwen2.5:7b
PARAMETER num_ctx 8192
PARAMETER num_gpu 99
EOF
ollama create qwen8k -f Modelfile
ollama create 之后用 ollama run qwen8k 起来,再看日志那一行应该变成 8192。改 num_ctx 会触发 runner 重载,ollama ps 的 UNTIL 列会重置,第一条请求多等几秒是加载,不是推理变慢。把这两个数字对齐,默认值就从一件说不清的事变成一行可以改的配置。
改完要回验:同一份带表格的说明书再喂一次,让它引用开头那段里的字段。能引出来,说明上下文真的放大生效了;还是答不上,那就是 8192 根本没进 runner。
症状二:吐字慢、显存没吃满,查层数
ollama ps 的 PROCESSOR 列有三种值:100% GPU、100% CPU,还有 48%/52% 这种拆开写的。拆开就是部分下沉,剩下的层留在内存里跑,速度被内存带宽拖住。
llama.cpp 侧看同一件事更直接,日志里 llm_load_tensors: offloaded 33/33 layers to GPU 斜杠两边相等才算全下。写成 20/33,差的那 13 层就在 CPU 上,这不是配置写错,是显存确实不够。
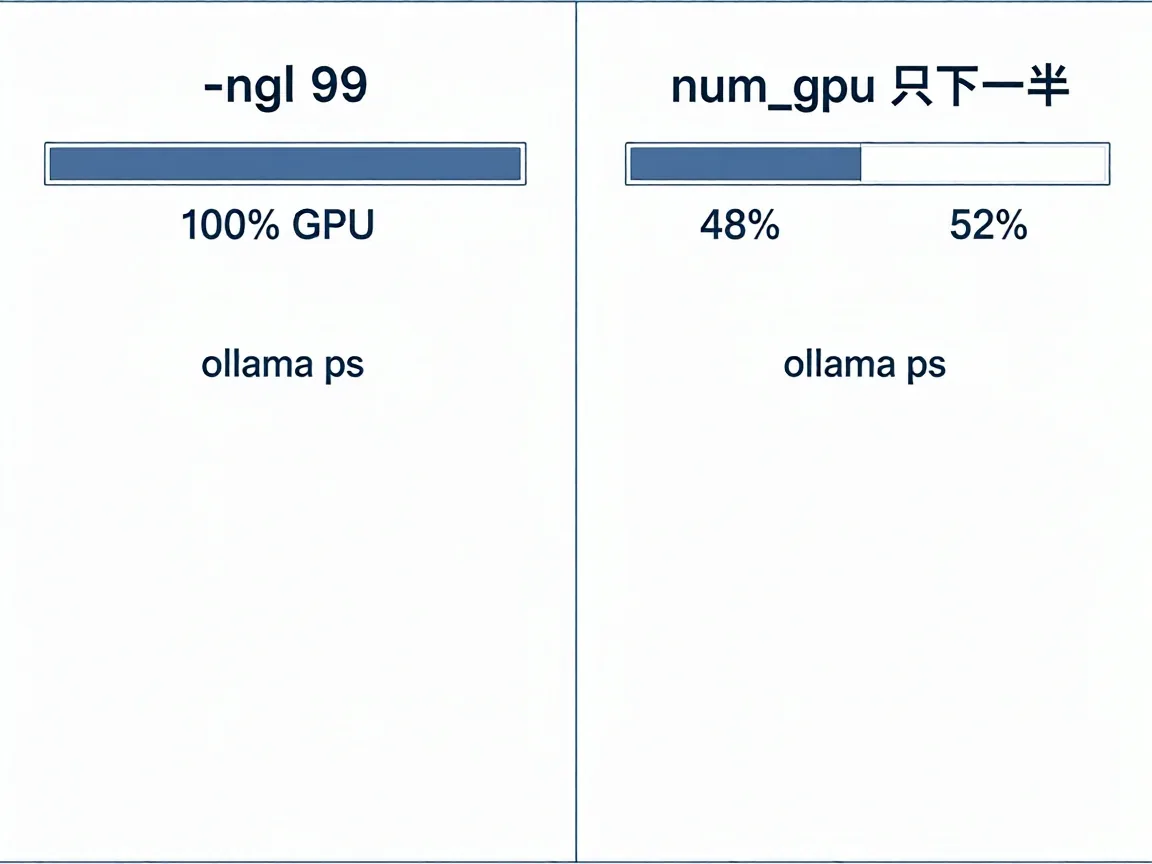
-ngl 和 num_gpu 说的是同一件事:下沉多少层,不是分配多少显存。我一般先给 -ngl 99 让它尽量全下,卡在显存边界上时,先把上下文从 8192 降到 4096 比降层数见效快——KV cache 按 n_ctx 线性涨,降层数省下的是权重那部分。层数够不够只有日志说得清,这也让它成了llama.cpp和ollama区别里最容易被忽略的一层。
症状三:连不上或 404,先分清端口
ollama 默认听 11434,llama-server 默认听 8080,两个都不是 80。路由也不一样:ollama 自己的接口在 /api/chat、/api/generate,OpenAI 兼容那套挂在 /v1/chat/completions;llama-server 的原生接口是 /completion,健康检查 /health,查当前生效参数是 /props。
一条命令同时试端口、路由和参数:
curl -s http://127.0.0.1:8080/props | python3 -m json.tool | grep n_ctx吐出 "n_ctx": 8192 说明三样都对。返回 404 是路由写错,Connection refused 是服务没起或者换了端口,这时候先 ss -lntp | grep 808 看进程有没有在监听,再回头检查启动参数。接口这一层最能体现llama.cpp和ollama区别:一个把兼容层做进产品,一个只给你原生路由,两边的错误码含义不同,别拿一套排查经验去套另一边。
还有一点容易绕:ollama 的 /v1 兼容层和 /api 原生接口共用同一个 daemon,端口始终是 11434,换成 OpenAI 格式只是路由变了,客户端里填的 base_url 不用改端口。
症状四:单人好用、多人就变慢,查并行数
前三支都排除干净还是慢,就看并发。num_ctx 是整份上下文,OLLAMA_NUM_PARALLEL 大于 1 时它要摊给每个并行请求,四个人同时提问,每人分到的窗口就只有四分之一。表现像模型变笨,问题在上下文被摊薄。
验证办法很土:把并行数设回 1 重启,用同一个问题再问一遍,回答质量回到单人水平就说明是这一支。临时改可以 OLLAMA_NUM_PARALLEL=1 ollama serve 起一个干净实例,别在正在服务的那个进程上试。
今天先做一件事:把参数从默认值里抢回来
打开正在用的那份 Modelfile,把 num_ctx 显式写成一个你算得过来的数字,别让它走默认;用 llama-server 的话就写 -c。发一条超过两千 token 的输入,看回答有没有漏掉开头的内容,再对着 ollama ps 或 /props 核一遍实际生效值。
回答完整、日志里的 n_ctx 也跟你写的一致,这条链路就通了。之后换模型、换卡、加并发,排查都从这一个数开始。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- PHP array_filter() 函数详解:按条件过滤数组元素 2026-07-02
- html文本框的基本语法 Html文本框如何使用? 2022-06-22
- Phpcms栏目如何添加自定义字段 Phpcms栏目添加自定义字段的方法 2022-02-19
- python中字典怎么单独加键,几种写法和踩坑记录 2026-11-09
- PHP对象类型如何检测?PHP如何检测对象属于那个类? 2022-12-12
- PHP 数组查找函数 in_array()、array_search()、array_keys() 实战对比 2026-07-02