
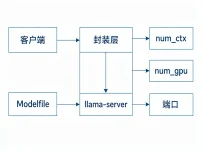
两条路跑本地模型,llama.cpp和ollama区别在参数
我现在跑本地模型用两套配置:调参压测走 llama-server,把模型分给同事用 ollama。用下来我的判断很直接:llama.cpp和ollama区别不在支持多少模型格式,而在参数由谁填——一边我自己写在命令行上,一边中间层先补一遍默认值,再转手交给同一个推理引擎。我自己的脚本里这两样都写死了…
- 2026年11月10日
- 13 次
ollama配置国内源怎么弄,下载慢到超时的问题终于解决
很多人第一次处理ollama配置国内源时会卡在细节上,昨天夜里十一点,我在一台刚装好的 Ubuntu 机器上执行 ollama pull qwen2.5:7b,进度条卡在 12% 一动不动,等了二十分钟直接超时。第一反应是网络断了,ping 出去却通,浏览器也能开网页。 索性翻日志,才发现是拉模型时…
- 2026年11月8日
- 18 次