
php框架性能对比怎么选?并发与生态两个维度
- 2026年11月11日
- 3 次
上周四下午,一台跑着两个 Laravel 站点的 4 核 8G 机器开始零星返 502,监控上 CPU 只到 40%,php-fpm 的进程数却顶在 32 不动。运维把截图发过来时我正在改一个导出脚本。那天的处理是把 pm.max_children 从 32 提到 64 先压住,然后回头把手上几个项目的php框架性能对比重新核了一遍,不比跑分,只比两件决定后面两年维护成本的事。
并发模型决定上限
先给答案:同样 4 核 8G 的机器能挂住多少并发连接,由并发模型决定,跟谁家框架的 benchmark 排名关系不大。
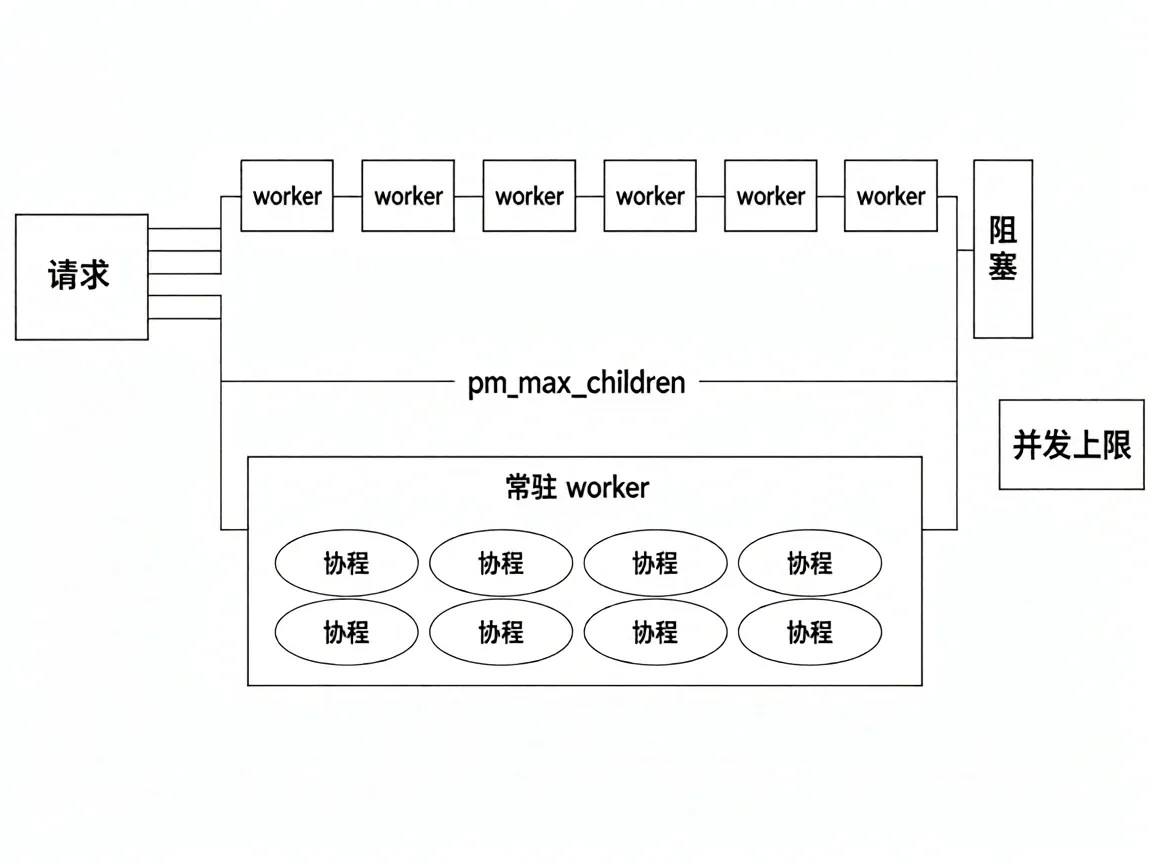
php-fpm 是进程模型。请求进来占一个 worker,这个 worker 在等 MySQL、等 Redis、等第三方接口返回的整段时间里,既不释放内存也不腾出位置,就那么阻塞着。所以并发上限约等于能同时起多少个 worker,而这个数由内存除出来,不由 CPU 除出来。CPU 40% 却返 502,原因就在这里:32 个 worker 全卡在等上游,队列排满,nginx 分不出可用的 upstream。
那天先把单个 worker 的内存量了出来。
ps -o rss= -p $(pgrep -f 'php-fpm: pool www' | head -1) \
  | awk '{printf "%.0f MB\n", $1/1024}'
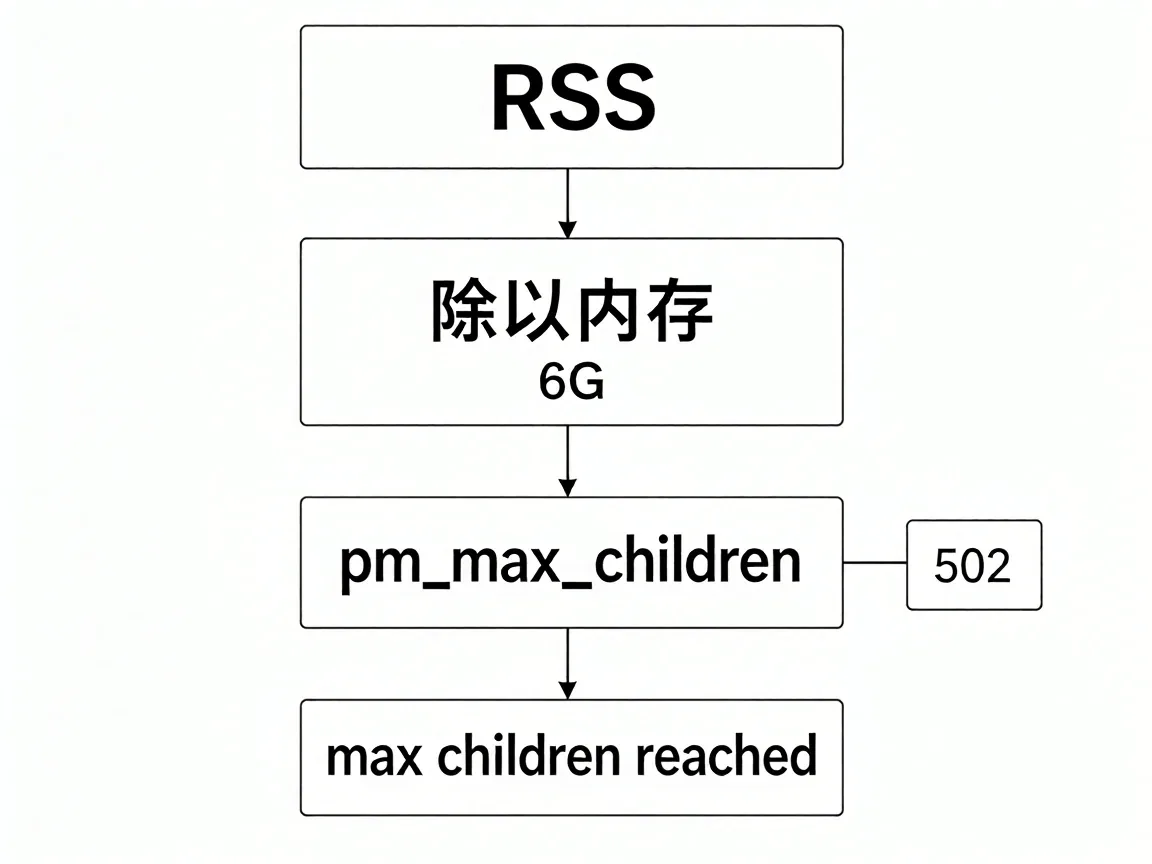
输出一行 47 MB。8G 机器扣掉 MySQL、Redis 和系统占用,剩 6G 出头,除下来能开一百三十个上下。所以 64 这个值离内存天花板还远,它只是把排队长度翻了一倍;可单请求里有两秒多在等第三方接口,64 个 worker 的吞吐上限也就三十几 rps,再加还是不够。
常驻 worker 模型动的就是这一段,但它不是一个东西,要分两类看。Swoole 这类是进程内调度:一个进程挂很多协程,等 I/O 时协程让出执行权,进程不空转,同样 64 个进程能挂住的连接数是另一个量级。RoadRunner 和 FrankenPHP 走的是另一条路——省掉每个请求重新启动框架、重新装配容器的那部分开销,可一个 worker 一次仍然只处理一个请求,等 MySQL 的整段时间照旧占着进程,并发上限还是等于 worker 数(FrankenPHP 另外能开 thread,上限变成 worker 数乘 thread 数)。把这两类混成一句「都上协程」,换过去会发现等 I/O 的并发一点没涨。
Swoole 这条路代价是前提变硬,所有 I/O 必须走协程客户端。这里要分清两种情况:在协程里直接调 PDO 不会报错,它会把整个 worker 阻塞住,压测时只表现为并发上不去、耗时随并发线性涨;反倒是在非协程上下文里调协程客户端,才会拿到一条明确的错误:
PHP Fatal error: Uncaught Swoole\Error: API must be called in the coroutine
不报错的那种更难查。所以这场对比真正要比的,是单请求里有多少时间花在等上,而不是压测机上的 QPS 排名。
做法:先量再调
这场php框架性能对比落到操作上只有三步,每步都要一个能横向比的数。
第一步,量单进程的常驻内存。上面那条命令就够,取三个 worker 的中位数,别取最大值,刚处理完大图的进程会虚高。
第二步,量单请求的占用时长,看它花在计算上还是花在等上。开 fpm 的 status 页,pm.status_path = /status,同时得在 nginx 里补一条 location 把这个路径转给 fpm,只配 fpm 一侧,curl 回来是 404——nginx 不知道 /status 该交给谁。补的这条是 location = /status { fastcgi_param SCRIPT_NAME /status; fastcgi_pass unix:/run/php-fpm.sock; },sock 路径按自己的 pool 配置填;不想动 nginx 的话,pm.status_listen 可以单独开一个端口,只给本机查。然后请求一次:
curl -s 'http://127.0.0.1/status?full' \
  | grep -E 'active processes|max children reached'
max children reached 不是 0 就说明 worker 被打满过。它记的是「触达上限的次数」,一次触达期间排着的请求可能有几十上百个,所以这个数不能直接当成被拒请求数——真正的影响要看 nginx error log 里的 502 条数和 fpm 的 listen queue。那台机器上这个值是 1482,半年里触达上千次,502 的条数与它对不上,比例大概就是一比十几。
第三步,按结果分岔。等 I/O 占大头、机器又加不动,才值得动并发模型;计算占大头,先把 opcache 调对。
opcache 有一处常见错位:opcache.jit 设成 1255,opcache.jit_buffer_size 还留着默认的 0,JIT 根本不生效,也不给任何警告。
php -i | grep -E 'opcache.(jit|jit_buffer_size|validate_timestamps)'前两行是一对,第二行是 0,第一行写什么都白搭。要开就给 opcache.jit_buffer_size=64M,生产环境再把 validate_timestamps 关掉、发版时 reload。另外 php -i 读的是 CLI 的 ini,FPM 的实际值要在 pool 配置或 phpinfo 页面上核,两者不是同一个文件。
生态与扩展成本
生态这一栏最难量化,因为它不是数字,是一张清单。
常驻模型下,凡是依赖「请求结束就重置」的东西都要重过一遍:容器单例、static 缓存、$_GET、$_SERVER、register_shutdown_function、全局错误处理器。Swoole 和 RoadRunner 都不会替你重置,Octane 给了一些 flush 钩子,也只覆盖它自己管的部分。一个 worker 的 RSS 从 47MB 涨到 300MB 用了六个小时,最后定位到一个第三方 SDK 把请求参数塞进了静态数组。
xdebug 也算在内。开着的 xdebug 在协程里会改掉 hook 的行为,压测前必须关,不然测出来的数没有参考价值。
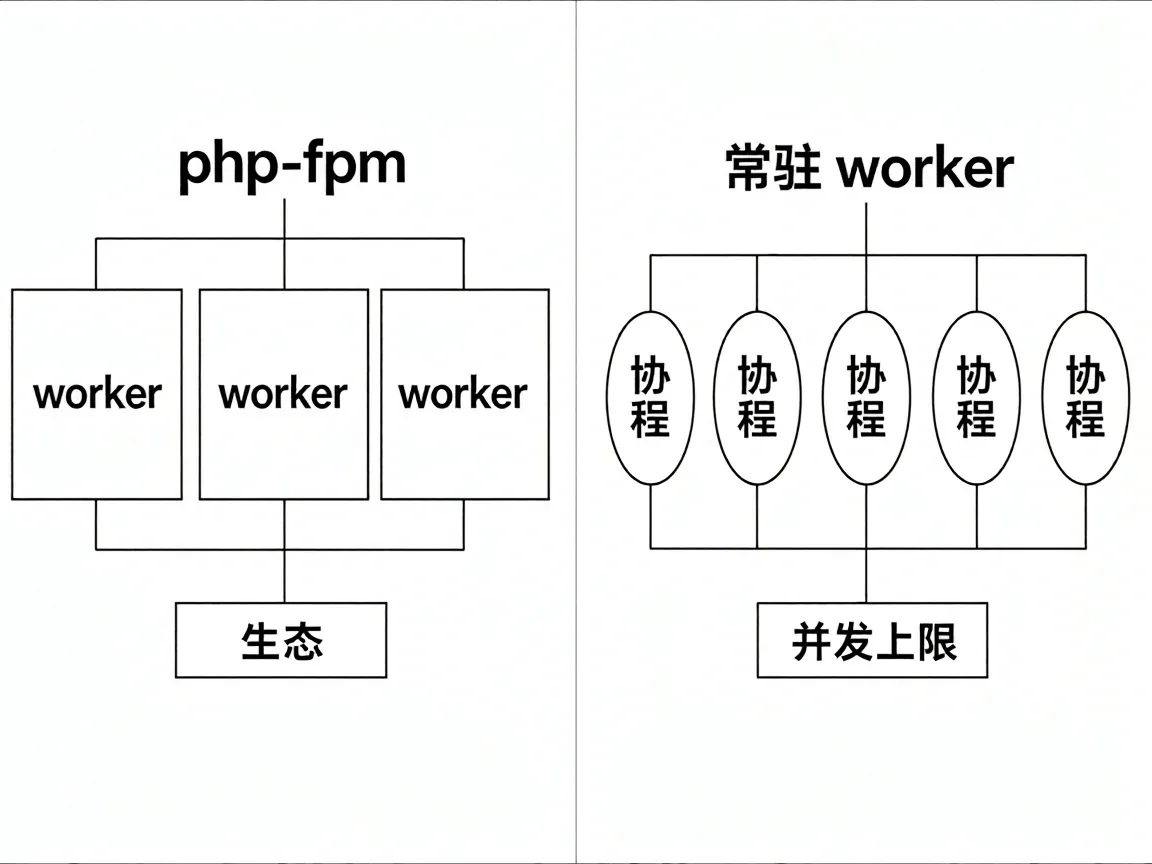
反过来,php-fpm 的生态成本接近零。2015 年的老包扔进去照样跑。这就是它的价值:上线快、招人容易、出问题有十年份的问答可查。
做到这一步,php框架性能对比就变成一道数包数的题:数一下 vendor 里有多少包依赖「请求级生命周期」。三个以内,换常驻模型划算;四十个,改造成本大概率超过省下的机器钱。
什么情况下不值得换
日请求量几千、峰值几十并发,做php框架性能对比没有意义,加一台机器比改架构便宜,这道题不用做。
团队只有一个人维护,常驻模型的内存泄漏排查会很贵,它不出现在请求日志里,只出现在 RSS 曲线上。
真要换,顺序是先做无状态改造(session 外置、上传直传对象存储、日志走 stdout),再换 runtime,不要倒过来。倒过来做的结果是每修一个 bug 都得重读一遍框架源码。
还有一条硬边界:pm.max_children 不要贴着内存上限设。越过去不是变慢,是 OOM killer 直接杀进程,现象是 502 加 dmesg 里的 Out of memory: Killed process,重启就好,几小时后再来一次。
这轮php框架性能对比做完,我给自己定的顺序是先算内存和占用时长,再数生态包袱。这笔账算下来是这样的:并发上限买的是机器,机器按月付;生态成本买的是人,人按年付。所以只有当等 I/O 的时长明显压过计算时长,我才换模型,其余情况把 pm.max_children 和 opcache 调对就收手。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- PHP比较运算符==号和===号的用法和区别 2022-06-14
- Html表单是什么?Html表单的用法解析 2022-06-23
- PHP数组键值对是什么?echo输出数组中的值 2022-10-21
- PHP array_walk() 函数详解:给数组每个元素套上自定义逻辑 2026-07-02
- PHP数据类型转换:字符串数据类型强制转换为整数数据类型 2022-06-10
- PHP替换字符串函数str_replace()用法及实例 2022-11-12