
python列表解包怎么用?4个场景各给一段代码
- 2026年11月11日
- 3 次
手上这套采集脚本从 Python 2.7 起家,跑了六年多,中途整批迁到 3.9,字段从 12 个涨到 26 个。三种取值方式混在同一个文件里:row[0] 一列一列抠,payload.get("ip") 兜底,还有几行直接写成python列表解包。前两种占了九成,改一个字段要来回数下标,数错一次就取到隔壁的时间戳。机器早换成 4 核 8G 的独服,代码没跟着换。现在要做的事只有一件:把前两种统一成第三种。
基础解包与星号收集
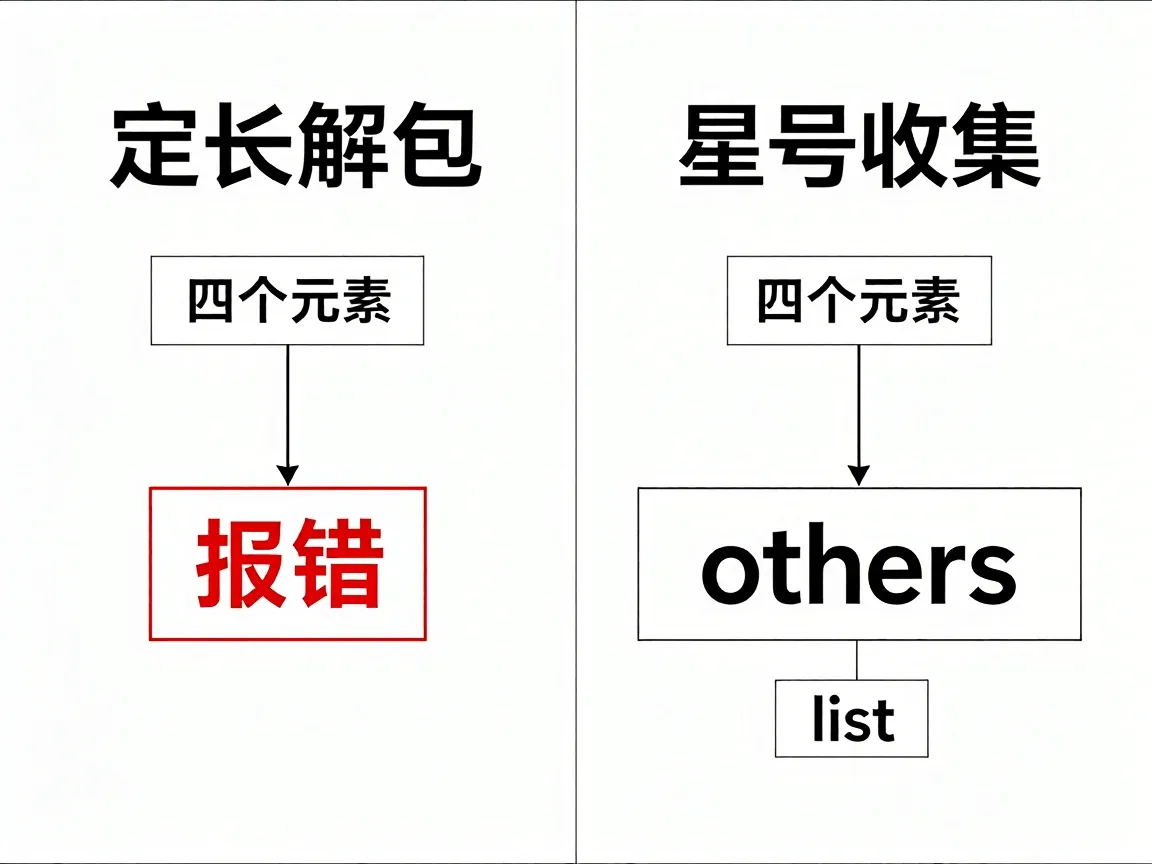
第一步先把规则定死:等号左边有几个位置,右边就得给几个元素;多出来的用星号接,星号变量拿到的永远是 list。list、tuple、字符串、生成器都按这条走,不看类型看长度。
row = ["2026-11-01", "10.2.3.4", 200, 0.031]

day, ip, status, cost = row
print(status)                # 200

day, ip, *others = row
print(others)                # [200, 0.031]

first, *rest = [1]
print(rest)                  # []

day, ip = row
day, ip, *others = row 是现在最常写的一行:位置固定的字段给名字,长度不定的尾巴整段交给 others。最后那条报错是故意留的,右边四个元素只给两个名字,解释器在赋值前就检查形状,后面那几行根本不会执行,数据也没被截断一半。
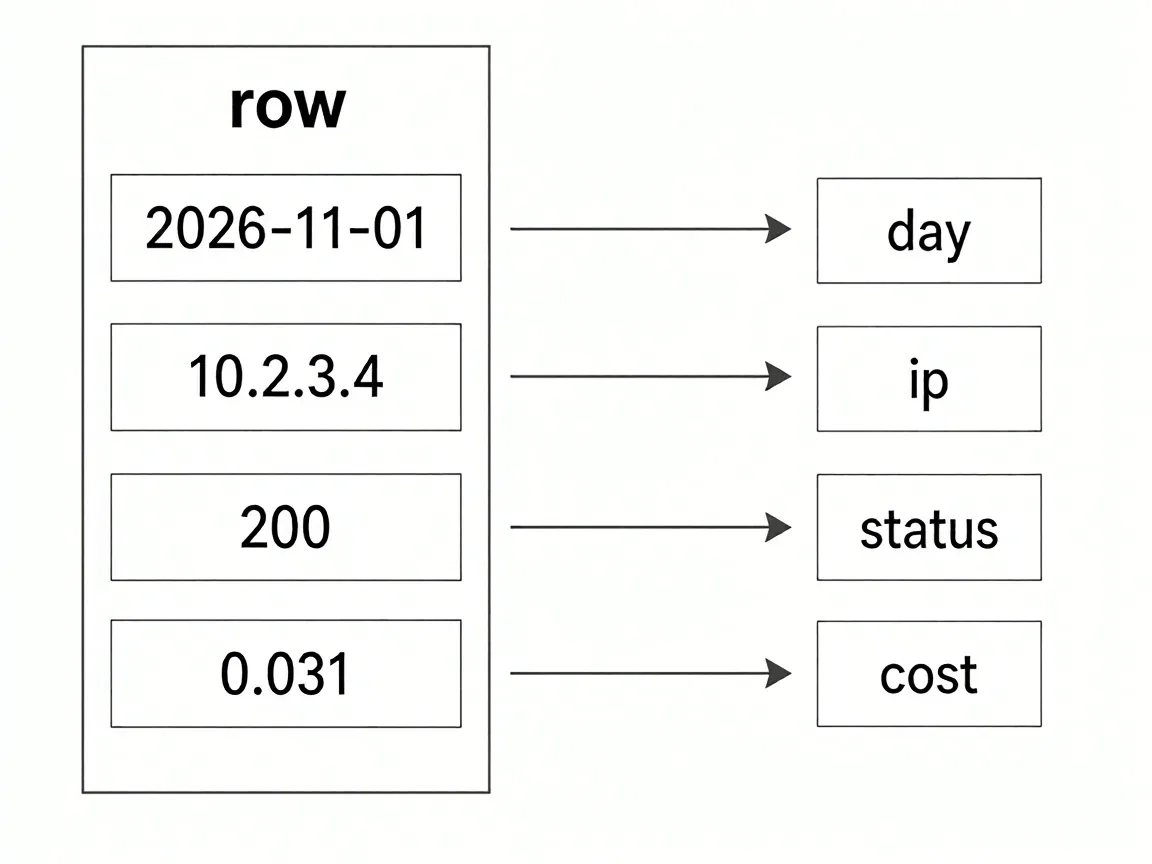
first, *rest = [1] 是边界。星号那一侧拿到空 list,不是 None,后面直接 for 循环也不用判空。这一条决定了 others 可以放心往下传。
反过来的错更常见。左边比右边多,报 ValueError: not enough values to unpack (expected 3, got 2);右边多而左边没有星号,报 ValueError: too many values to unpack (expected 2)。两条说的是一件事:形状对不上。
换成人能读的名字之后,python列表解包的好处才显出来:字段名就是文档,加一个字段只动等号左边一处。
这套写法在 2.7 上不成立。PEP 3132 是 3.0 才进的语言特性,a, *b = row 在 2.7 解释器里直接 SyntaxError: invalid syntax,报的位置指向星号前面那个逗号,光看报错根本看不出是语法版本问题。迁移时我的做法是保留全部星号,先用 3.9 跑一遍 py_compile,再回头处理 2.7 的兼容分支。
星号在赋值左边只能出现一个。a, *b, c = row 这种中间放星号也合法,b 拿到掐头去尾的中间段;写两个星号直接 SyntaxError。
右边不一定是字面量。a, b = (x for x in [1, 2]) 也能过,生成器被完整消费一次;换成 a, b = iter([1, 2, 3]) 一样报 too many values,迭代器不报长度,只认取到第几个为止。
函数参数里的解包
第二步看调用侧。函数签名里写 *args,是把散着的实参收成一个 tuple;调用时写 *args,是把一个序列摊开成位置参数。两个星号方向相反,第一次读签名容易绕进去。
def report(day, ip, status):
    return f"{day} {ip} {status}"

args = ["2026-11-01", "10.2.3.4", 200]
print(report(*args))         # 2026-11-01 10.2.3.4 200

report(*args, 0.031)
report(*args) 和 report("2026-11-01", "10.2.3.4", 200) 完全等价,参数按位置一个个对上。多摊一个就是上面那条 TypeError,措辞是 takes 3 而不是 missing,说明拆包发生在参数绑定之前,函数体一行都没执行。
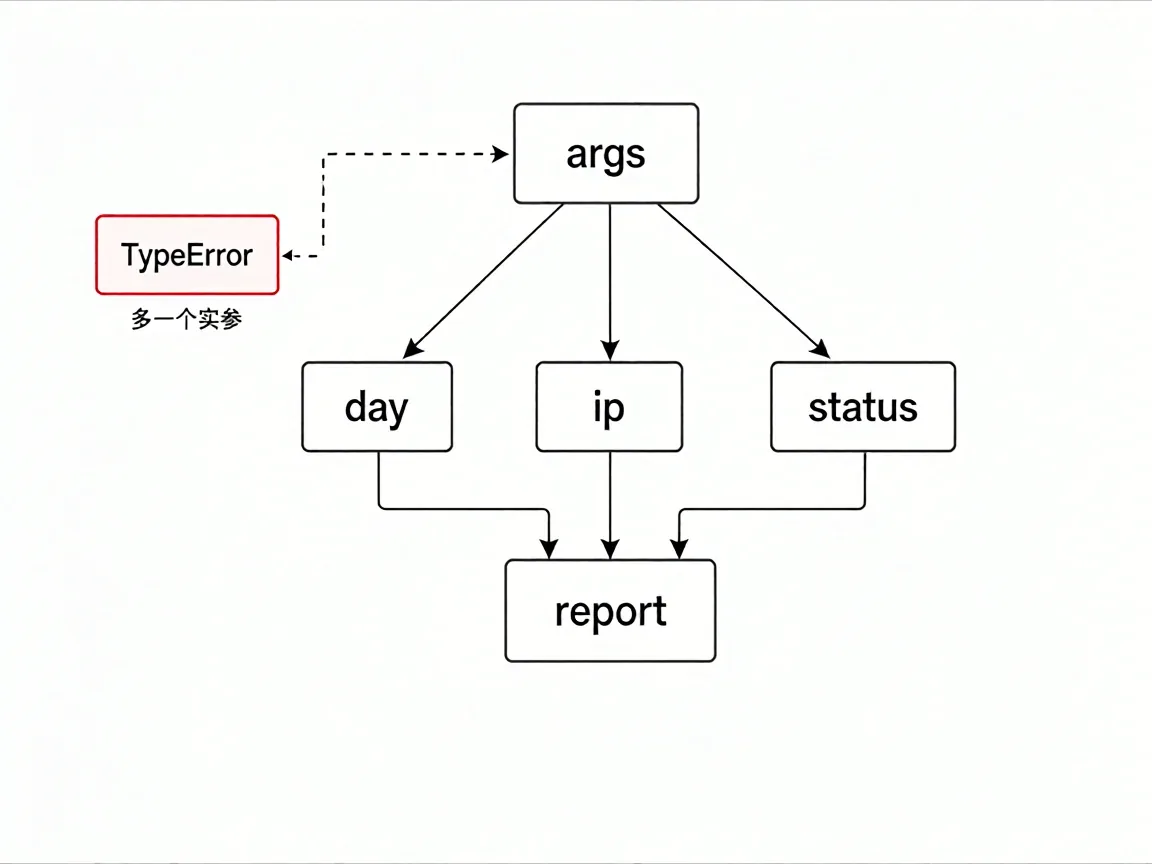
把序列摊开传参,是python列表解包在调用侧最直接的用法。
关键字参数走 **。report(**payload) 要求字典的键和形参名逐字一致,键写成 dt 而不是 day,报 TypeError: report() got an unexpected keyword argument 'dt'。这类错跟值无关,纯粹是名字对不上,配置改名的时候最容易带出来。
print(*rows, sep="\n") 是同一套机制的日常用法,把一批行摊成独立参数,少一次 "\n".join(rows) 的拼接。
签名里同时有 *args 和 **kwargs 时,位置参数先绑定,再绑关键字,剩下的才进两个收集变量。顺序写反,**kwargs 摆在 *args 前面,是 SyntaxError,不会等到调用才报。
嵌套列表与占位符
第三步往里走一层。右边元素本身还是序列时,左边的括号要把形状写出来:(x, y), z = pair 表示第一个元素再拆一层,第二个直接给 z。
pair = [[1, 2], 3]
(x, y), z = pair
print(x, y, z)               # 1 2 3

point = (0, 5)
_, y = point
print(y)                     # 5

_, _, third = [10, 20, 30]
print(third)                 # 30
层数写错还是 ValueError,报 expected 2, got 1 之类,位置指向最里面那一层,不是整行。调试时先把右边 print 出来看形状,比盯着报错猜快。
_ 只是个约定俗成的名字,赋值照常发生,_, y = point 里第一个值确实被写进了 _。它在 REPL 里还有第二重身份:上一次表达式的结果也挂在 _ 上,交互式里连着敲两行,第二行读到的可能是上一个结果,不是刚解出来的那个。脚本里没有这个问题。
整段丢掉用 *_,head, *_ = row 只留第一个。_ 用几次都行,后赋值的覆盖前面的。
交换、拼接与字典合并
第四步是几个能直接用上的地方。交换不用临时变量,右边先打包成 tuple 再按位置拆回左边,中间那一步由解释器完成:
a, b = 1, 2
a, b = b, a
print(a, b)                  # 2 1

xs = [3, 4]
print([*xs, *xs])            # [3, 4, 3, 4]

d1, d2 = {"a": 1}, {"a": 2, "b": 3}
print({**d1, **d2})          # {'a': 2, 'b': 3}
同一个 a 键,左边字典先摊开、右边后摊开,最后留下的是右边的值,和 dict.update 一个顺序。
拼接序列写 [*a, *b],合并字典写 {**d1, **d2}。后者要 3.5 以上(PEP 448),同键时右边覆盖左边,和 dict.update 的行为一致。遍历用 for k, v in d.items(),需要下标就 for i, (k, v) in enumerate(d.items()),两层括号不能省。
这几个写法用的都是同一套机制,python列表解包只是把它摆到了等号左边和括号里面。
共同的前提是右边长度确定。for k, v in rows 里只要有一行是三个元素,整个循环当场 ValueError 退出,前面处理过的数据不会回滚。批量任务里我先跑一遍长度校验再进循环,校验就一行 all(len(r) == 2 for r in rows),代价是一次遍历,比跑到第两万行才崩划算。
三行命令验一遍
改完照这三行过一遍,每行的通过标准都不一样。
grep -nE "\[[0-9]+\]" collect.py | wc -l 数的是还在按下标取值的地方,理想值是 0,或者只剩确实只要单列的那几处。
python -c "a, *b = [1]; print(b)" 必须打印 []。这里如果直接 SyntaxError,说明跑这条命令的解释器不是 3.x——2.7 不认 PEP 3132,先 python -V 确认版本再往里查。
python -m py_compile collect.py 没有输出才算过。蹦出 SyntaxError,就去看星号是不是落在了两个变量名中间以外的位置。
三行全过,字段名就算固定下来了,后面加字段只动等号左边一处。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- hermes接入agnes-ai API实现免费文本生成、文生图、图生图、图生视频 2026-07-20
- typora左侧目录怎样生成 typora树形目录使用方法 2022-10-04
- 用Python查找txt文本某个关键词并保存到另一个文本中 2021-08-27
- 用Python条件判断简单制作一个12星座速配工具 2021-01-20
- ZblogPhp首页、列表页、文章页、tag页面调用面包屑导航代码 2022-10-11
- 安装Python解释器及测试是否安装成功 2021-07-28