
pandas和python的区别在哪?先看数据量再选工具
- 2026年11月14日
- 48 次
报表脚本要跟着业务库搬到新机器,旧的那套拿标准库的csv模块堆出来,四百多行,加一个维度得改三处。同事要按门店分组、再按周汇总,改到第二遍直接问,为什么不换成pandas。要定的是pandas和python的区别:多一个依赖,换来什么。答案落在数据量上,往下按动手顺序走。
答案先给:pandas是什么,两者差在层次
pandas是一个第三方数据处理库,跑在python之上,底层靠numpy,对外主要给两样东西:Series是一列,DataFrame是带列名的二维表。python本身是语言,自带一套标准库,csv、json、sqlite3都在里头。
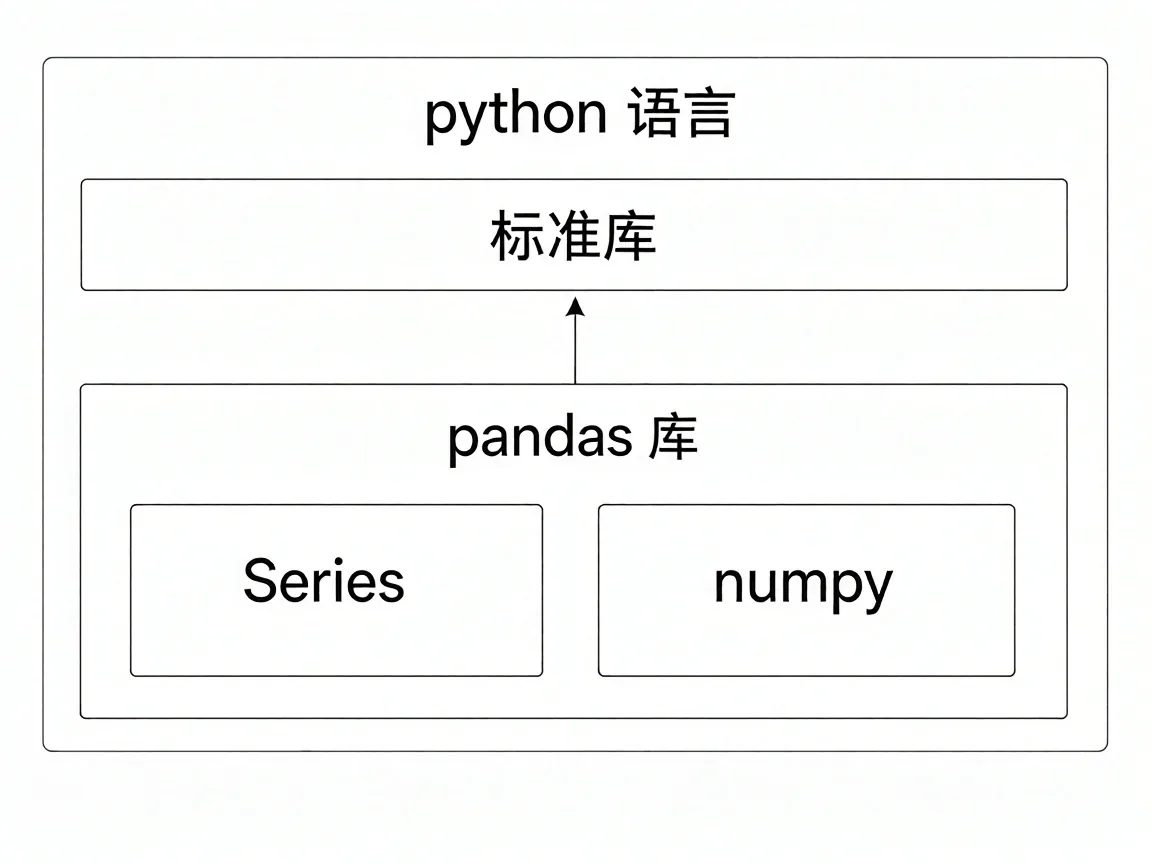
所以两者的区别不是谁更强,而是层次不同。一个是语言,一个是这个语言里的一件工具,拿工具跟语言比,比不出高下,只能比场景。
结论先落在一句话上:行数几万以内、只算一次,标准库够用;行数上到几十万还要反复切、反复分组,DataFrame省下的代码量比它占的内存值钱。
真正要比的也就三件事:装不装,多一层依赖;跑多快,三十万行以上才看得出差别;写多少行,一次性汇总和按条件反复筛是两种工作量。先看数据量,说的就是这个意思。
第一步:量三个数,DataFrame的门槛就在这儿
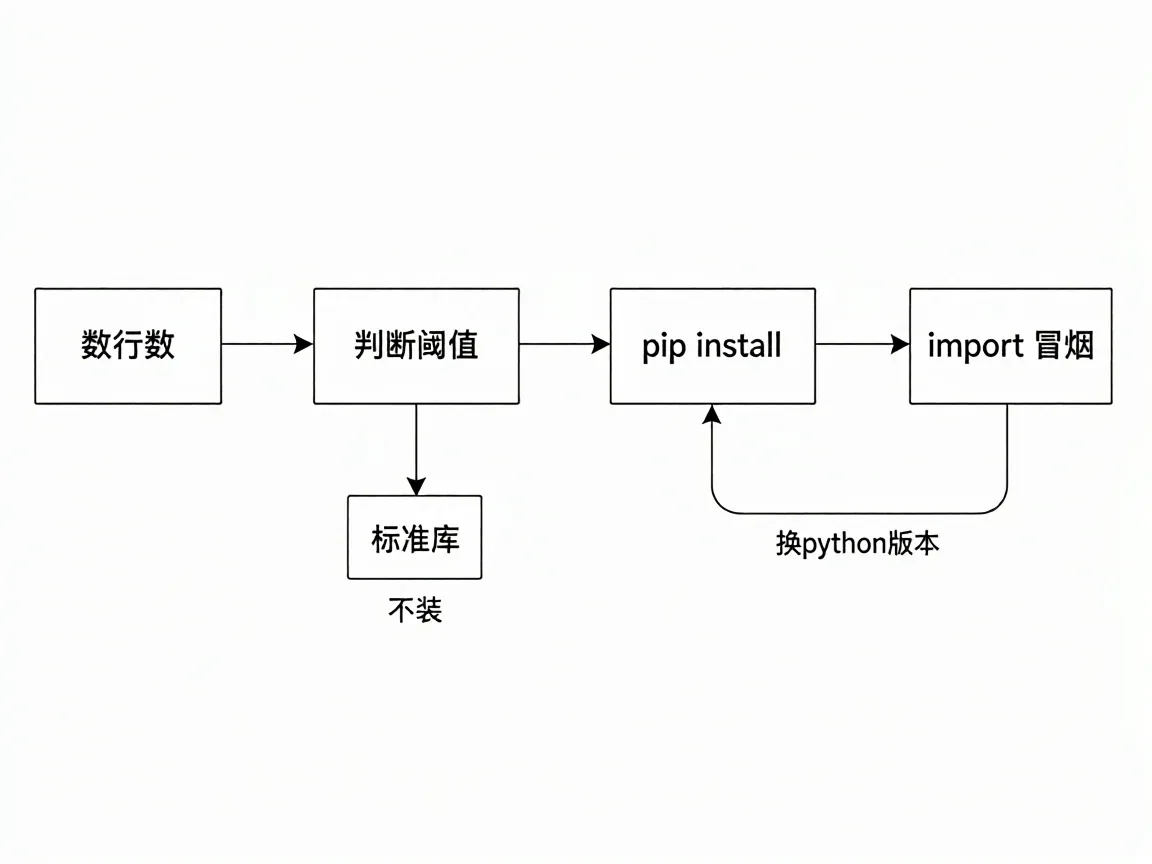
动手前先在旧脚本上加个临时统计,把行数、内存占用、运行频次打出来。行数用系统自带的wc -l就能数:打开终端 → 进到 csv 所在目录 → 执行wc -l 订单表.csv → 看第一列的数字,扣掉表头那一行。这一步不装任何东西,两分钟出结果。
内存这一项最容易被略过。六十兆的csv读进DataFrame,进程占用涨到两三百兆是常事,字符串列尤其吃内存;同一列里重复值多,转成category能压下去一截。机器只有两G内存、还要同时跑别的服务,这一步不先算,读到一半就被系统杀掉,报的是内存不足,跟代码写法没关系。
第三个数是频次:这份数据一周跑一次,还是每小时被不同人筛不同条件。跑一次,脚本写完就扔;反复筛,才值得上DataFrame。
顺带看一眼列数也行。十几列的宽表,人眼扫一遍就知道哪些列要参与计算;列数超过二十,还要按不同列组合条件反复筛,手写字典的键名容易拼错,按列名取值的地方就显出好处。它不单独算一个数,只是把「反复筛」这件事的量级说清楚。
三个数摆齐,pandas和python的区别就落在具体数字上,不用争。
第二步:装之前看依赖,装完先冒烟
pandas不是单个包,装它会把numpy、python-dateutil、tzdata一起拉下来。网络顺畅的机器一条pip install pandas就完事。内网要走代理,或者python版本太新还没有对应的预编译轮子,pip会退回去本地编译numpy,报错里出现Microsoft Visual C++ 14.0 is required,看着像缺编译器,其实是没拿到预编译包。先查这个python版本有没有现成的轮子,再决定是换版本还是先单独装numpy,支持范围以官方文档为准。
装完先别改业务脚本,冒烟两分钟:打开终端 → 进python交互环境 → 执行import pandas → 打印版本号,不报错;再读一个十行的小csv,用head看前几行有没有对齐。挡掉的是后面那类"明明装上了却读不出来"的排查,多数出在编码和分隔符上。
还有一处容易漏:机器上常有两三个python,pip装进了A,脚本用B在跑,import pandas照样报找不到模块。冒烟要在业务脚本用的那个解释器里做,先用python -V确认版本再装。
依赖这一步直接决定成本。环境干净、版本对得上,多装一个库就是一条命令的事;环境乱,光让numpy编出来就要大半天,pandas和python的区别也就从"多一个库"变成"多一堆事"。
第三步:同一份数据,两种写法的差别
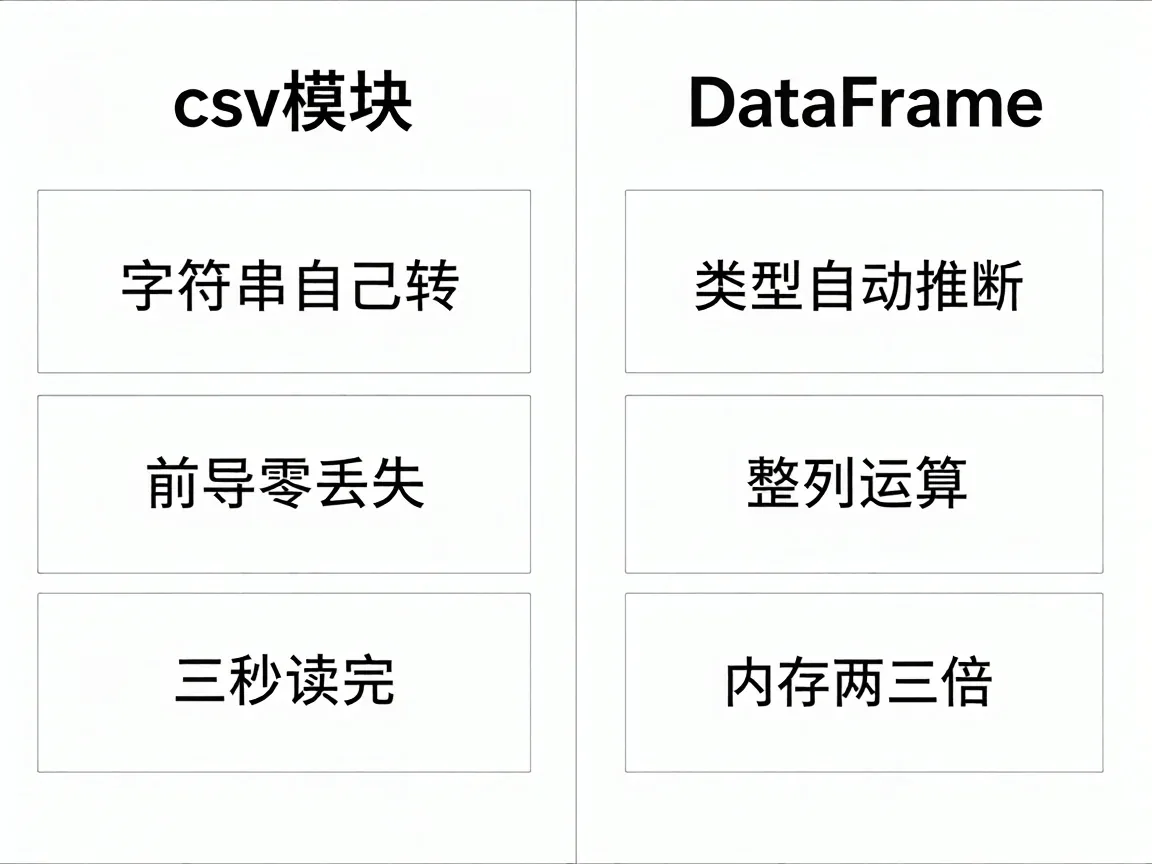
拿手上那张三十万行的订单表试了一遍。走csv模块,读进来每列都是字符串,得自己转int、转float,空串要单独判,金额带千分位逗号还得先消掉;订单号是纯数字但带前导零,转int之后007变7,对账对不上。这套搬运用了半天,跑完一遍三秒多。
换成read_csv,读进来就是带类型的表,求和、按门店分组、按周汇总各一行。代价是前导零照样会丢,得在读的时候把订单号那列指定成字符串,这一点不问清楚,数据洗干净了也是错的。另外别用iterrows逐行遍历三十万行,那比csv模块的for循环还慢,几十秒起步;它的快来自整列运算,跟名字无关。
分组这一段差距最明显。csv模块要先建一个字典,边循环边判断键在不在,累加完再排序、再拼输出,三四十行;DataFrame把列名交给分组,一行出结果,多一个维度就多传一个列名。多层分组之后索引会变成嵌套的,取值方式跟平表不一样,第一次用基本都要在那里绕一圈。
所以落到具体工作上,pandas和python的区别是几秒和几十秒、四行和四十行、一个依赖和零个依赖的取舍,不是哪个更高级。
换机器前照着跑这三行
数行数。旧机器上跑一遍只做行数统计的脚本,把总数记下来,超三十万行再考虑pandas。
跑冒烟。新机器上import pandas不报错,read_csv读十行能出结果,两样都过再动业务脚本。
对账。同一份数据,新旧两套写法各算一次总额和分组数,数字对不上先查类型,前导零和空值排在最前。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- 不小心删除了pip怎么办?Python如何重装pip? 2022-07-05
- PHP替换字符串函数str_replace()用法及实例 2022-11-12
- php对象和数组的区别在哪?存取方式与使用场景对照 2026-11-15
- PHP文件操作常用函数介绍 PHP文件操作常用函数实例代码 2022-11-12
- Python循环中continue和break的用法和区别 2021-08-02
- python虚拟环境和主环境有什么区别,装包前我踩过的坑 2026-11-08