
robots文件存在限制指令,Disallow写错会挡掉全站
- 2026年11月11日
- 49 次
Disallow 写错一个字符,真能把整站从搜索结果里清掉吗?答案不是一个「会」或「不会」,得先把三件事定下来:错在哪一行、文件有没有真的从根目录取到、服务器回的是 200 还是 404。后台提示robots文件存在限制指令的时候,这三件事没对齐,改哪一行都是赌。
Disallow 规则里,常见的三种写法只有一种真挡站
下面三种写法常被当成「封站」,其中只有第一种真能挡死全站,后两种方向刚好相反——看着像封禁,实际在放行。
Disallow: / 后面一个斜杠,意思是整站不许抓。这是最常见的一类事故:从测试环境同步配置、临时挂维护页、改版期间先封两周,事做完了那行没删。
Disallow: 冒号后面留空,语义整个翻过来,是全部放行。有人抱着「封站」的目的写了这一行,隔天看收录一条没少,才发现空值和斜杠差一个字符。
Disallow: admin 缺了前导斜杠。按 Google 的规范,这个值必须以 / 或 * 开头,不以这两个字符开头的行会被当成无效行整行忽略。写完以为封住了,实际一个字都没生效。
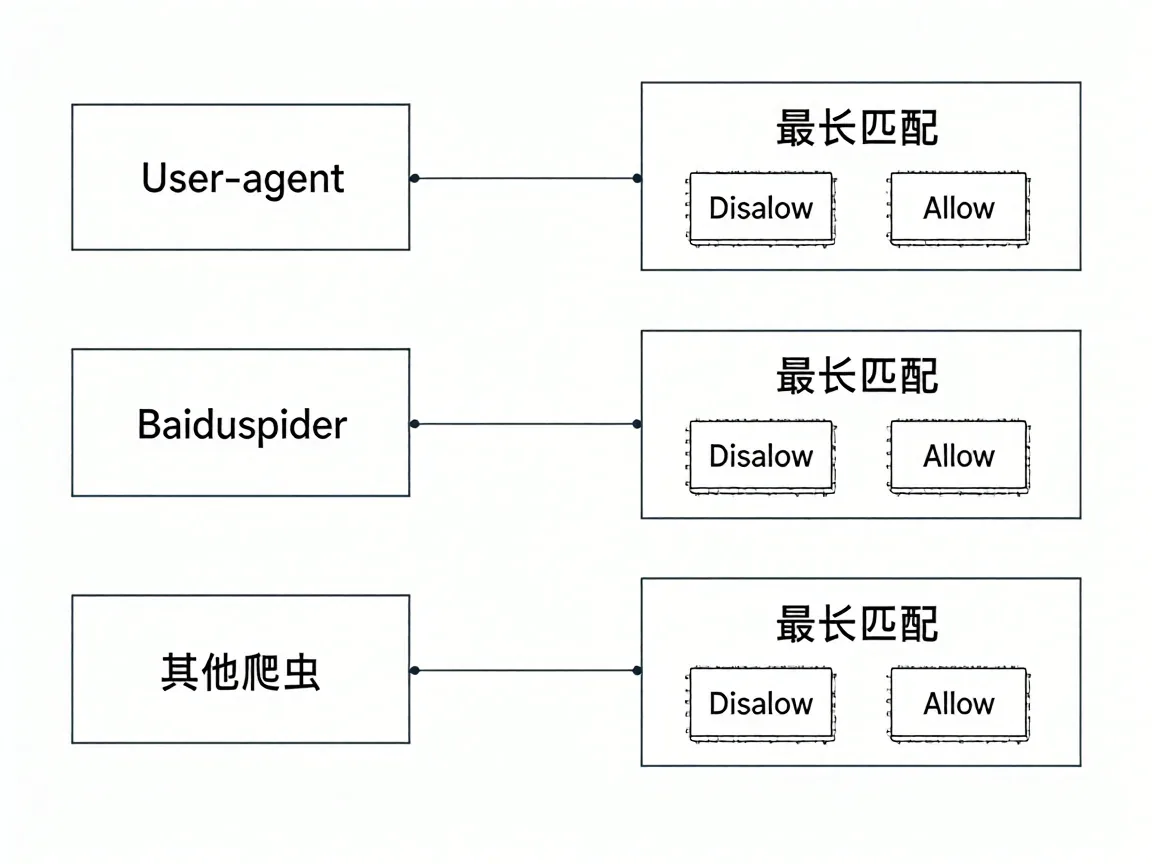
还有一种半对半错:Allow 和 Disallow 同时命中一条 URL 时按最长匹配判定,长度相等才轮到 Allow 优先,这是 Google 的规则。所以 Disallow: /admin 配 Allow: /admin/login,登录页确实放行;可写成 Allow: /admin/login.html、地址却是 /admin/login,那条规则永远匹配不上。
下面这几行是从一个改版中的站点上原样摘下来的:
User-agent: *
Disallow: /
Allow: /$
$ 是结尾锚点,只匹配根路径,所以整体效果是首页留着、其余全挡。当作临时兜底没问题,麻烦在于它是手写进仓库的,改版结束没人清,半年后新同事照着这份文件搭环境,整站又挡一次。
逐行核对的清单
拿到一个疑似被限制的站,后台那句robots文件存在限制指令只是一条提示,按下面几条走一遍,比反复调正则省时间。
- 位置:只能是
https://域名/robots.txt,放子目录不生效,文件名大小写也要对。 - 协议与主机:
http和https、带www和不带,各算一份文件,常见情况是改了一份、另一份还是旧的。 - 分组:连续的多个
User-agent行共享下面同一组规则,空行开新组。把User-agent: *的规则写在Baiduspider那组底下,等于没写。 - 大小写:路径区分大小写,
/Admin挡不住/admin。 - 行尾注释:
#开头的整行是注释,但行尾追加一段说明,有解析器会把后面内容一起当成路径,注释单独起一行。 - 编码:UTF-8、不带 BOM。用记事本另存成带 BOM 的,第一行
User-agent前面多出三个字节,这一组可能整组挂不上去。 - 体积:Google 只解析前 500 KiB,超出的部分截断,不报错。
分组这一条值得多看一眼,规则不是从上往下依次套用,而是先归组、再在组内匹配。
清单核完仍然看到robots文件存在限制指令,问题基本落在 Allow 与通配符的匹配顺序上。这时候别继续改文件,先把当前生效的匹配结果抓出来看。
用 robots 抓取测试确认真实生效范围
改完文件要验证,验证的第一步不是打开后台工具,是把文件真抓一遍。
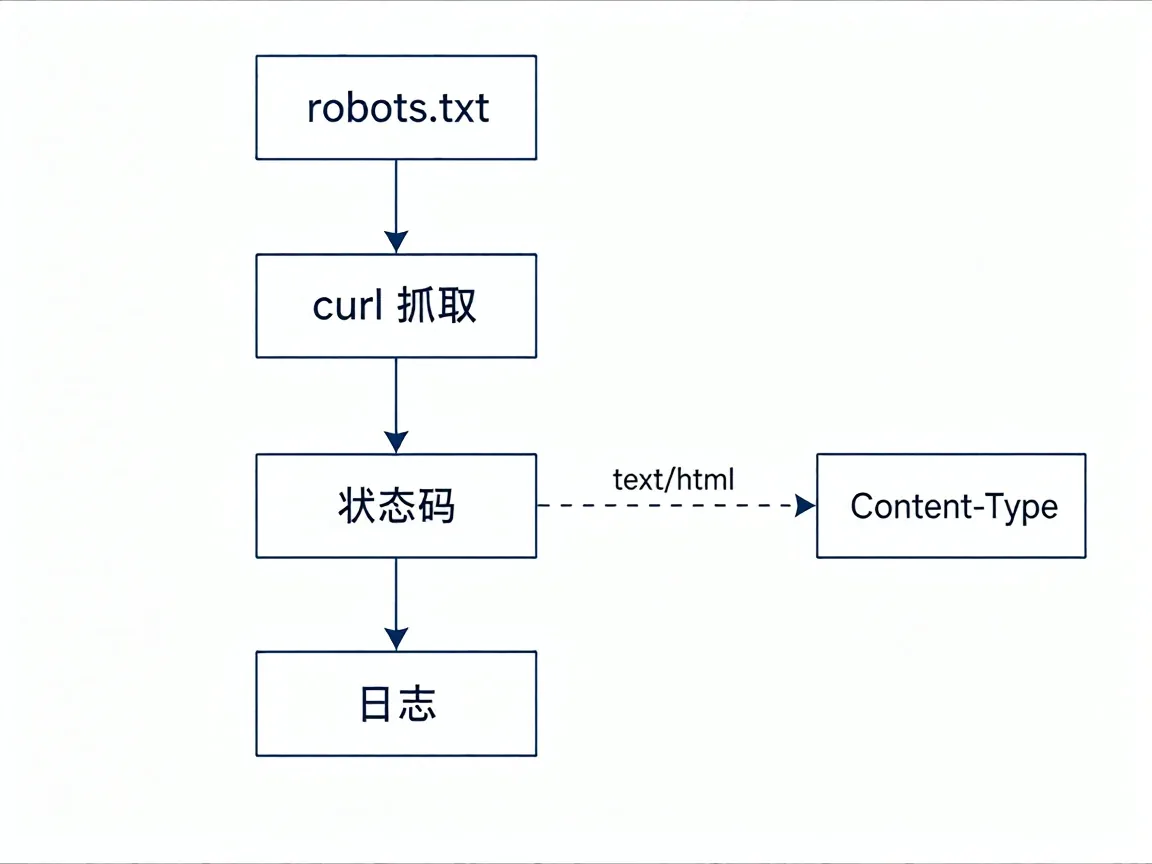
curl -sS -D - -o robots_local.txt https://leetao.cc/robots.txt-D - 把响应头直接打到终端,-o 把正文另存一份。只看两行就够:状态码和 Content-Type。正常应当返回 HTTP/1.1 200 OK 和 text/plain。
如果 Content-Type 是 text/html,说明请求被前端路由或者 404 兜底页接走了,吐回来的是首页 HTML。解析器读到的不是指令,这份文件等于不存在——写了但没生效,和根本没写,结果一样。
Nginx 上加一段能把这条路堵死:
location = /robots.txt {
    default_type text/plain;
    try_files $uri =404;
}
=404 的意思是文件不在就直接回 404,不许回落到 index.html。
还有一个只有翻自己日志才看得出来的现象:封禁真正生效之后,那条 URL 的请求不是变成 403,而是从日志里消失。留下来的只有 /robots.txt 本身的 200 记录,UA 是 Baiduspider 或 Googlebot。拿「日志里没有 403」当作没被封的证据,方向从头就是错的。
工具这边,Google Search Console 的 robots.txt 报告会给出抓取时间和最终生效的规则,百度搜索资源平台也有对应入口,填一条 URL 看匹配结果。工具说允许,只代表语法层面通过,robots 抓取测试还得配一眼日志,确认那条 URL 真的被请求过一次。
状态码和编码比语法更容易出错
爬虫取不到文件时,回什么状态码,结论完全不一样。
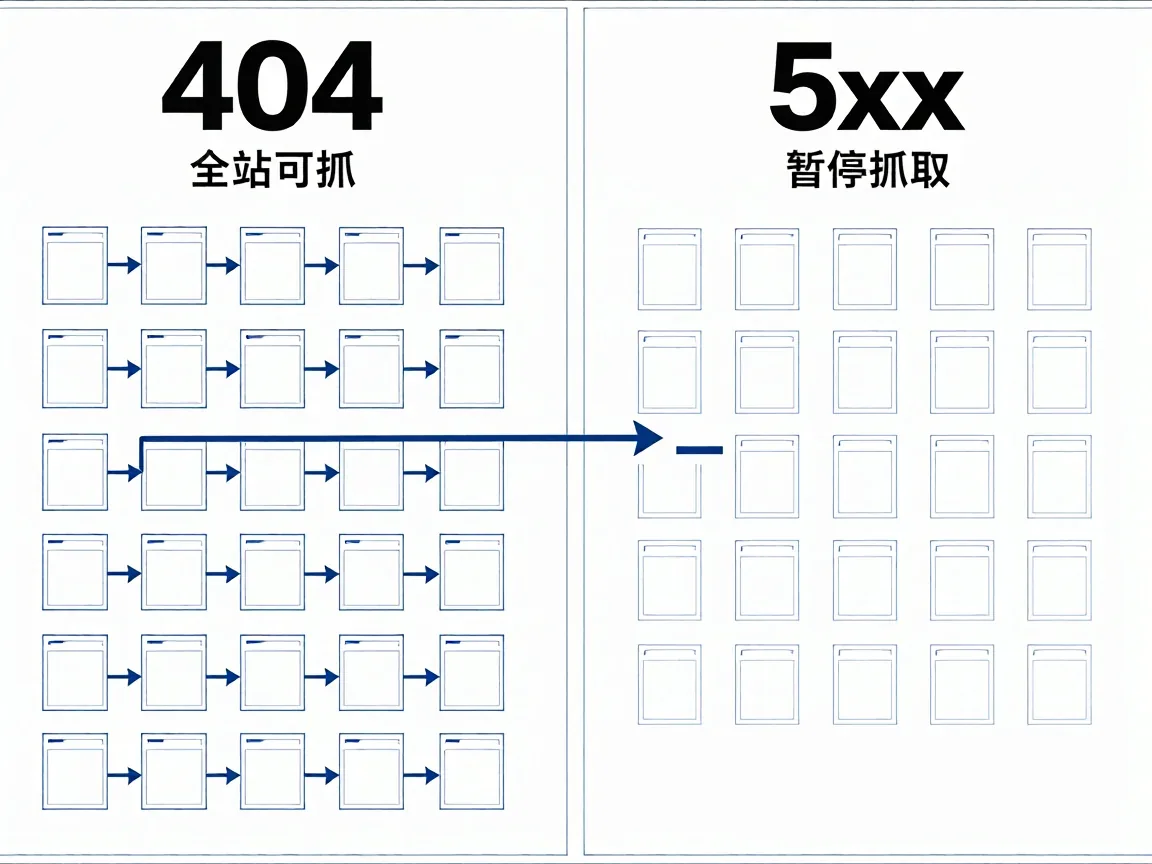
404 以及其余 4xx,Google 视为没有限制,全站可抓。robots.txt 被误删、被改名、被 CDN 规则拦掉,走的都是这条路——这一次是全放开,不是全挡死。
5xx 是另一种处理,抓取会先停下来,不会把这次当成放行。源站在打补丁、维护窗口里回 502,都可能触发一段时间的暂停抓取。
301 和 302 会被跟随,跨主机跳过去时各家引擎处理不一致,www 与非 www 互跳最容易出岔子。
语法没错、状态码也对,robots文件存在限制指令却还挂着,那问题多半在别的层:编码对不上、注释吃掉了路径,或者这个主机名根本没取到那份文件。
恢复要等多久,给不了准数
文件改回来只是必要条件。爬虫要重新取一次 robots.txt,才会按新规则抓;中间隔多久,取决于这个站平时多久被回访一次、抓取频次多少。回访密的站快,抓取预算低的站慢,我没法从一个站推另一个站。
能主动做的只有两件:控制台里请求重新抓取,确认那份文件在 CDN 边缘节点也更新了。只刷源站、边缘还挂着旧版本,改十遍也一样。
至于百度对 Allow 与 Disallow 等长冲突的处理,官方文档写得不如 Google 细,不同年份的说明还有出入,多引擎的站我一般每个引擎各测一条 URL,再以官方文档为准下结论。
多语言站按子目录拆的那种更绕:主域那份文件把限制写到了全站,子目录站点又各自有一份,robots文件存在限制指令究竟由哪一份生效,只能按引擎分别去验,验完才知道该动哪个文件。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- VPS服务器LINUX系统下如何屏蔽指定的IP和IP段 2022-08-23
- 小破站指的是b站还是a站?小破站叫法的由来与两个站点的对照 2026-11-21
- ICP备案需要钱么?ICP备案怎么查询? 2022-10-07
- windows服务器和linux服务器有什么不同?windows服务器和linux服务器的详细对比 2023-02-11
- PhpStudy小皮面板提示80端口被系统占用该怎么办呢? 2022-09-30
- Linux df -h 磁盘空间满了怎么办?5分钟定位大文件并清理 2026-07-02