
谷歌浏览器爬虫插件webscraper如何爬取多页面内容?
- 2021年12月31日
- 2,063 次
昨天简单介绍了谷歌浏览器爬虫插件webscraper的简单使用方法,可以使用爬虫插件webscraper爬取网站一些简单的基础数据,那么如果我们要爬取网站多页面的内容,也就是我们通常遇到的列表页或者是网站频道页面带有分页的内容该如何爬取内容呢?其实只需要在创建爬虫时对爬取的页面进行设置就可以爬取到多页面内容了。
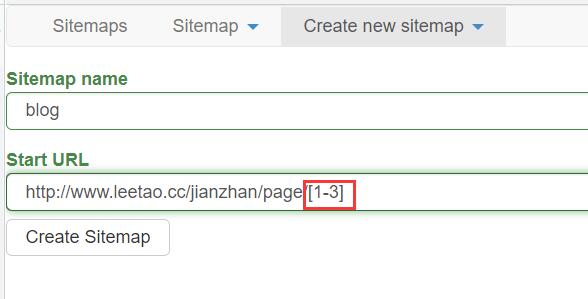
在我们打开谷歌浏览器的开发者工具启动webscraper插件,点击Create new sitemap创建爬虫后,填写Start URL开始Url的时候,这个时候我们首先要分析所要爬取的网址链接的分页特点,例如以本站为例:建站栏目的Url是https://www.leetao.cc/jianzhan/page/2 这样的结构,这是建站栏目下的第二页,那么第三页就是https://www.leetao.cc/jianzhan/page/3 ,这个时候我们基本上已经确定了是最后的数字呈每一页数字递增1。分页语法表达格式就是[1-3],这个时候我们在Start URL处填写https://www.leetao.cc/jianzhan/page/[1-3] 就可以爬取到建站栏目下第一页到第三页的多页面内容了。
爬虫插件webscraper爬取多页面内容需要注意的地方:
Start URL的地方,[]的括号是输入法英文半角格式下的括号,必须用英文半角格式下输入左右两个括号,不可用汉字格式下输入括号,否则将在后续爬取内容的时候报错,导致无法爬取内容。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- 抖音账号权重报错怎么解决?从数据到违规记录的排查 2026-11-20
- PHP array_flip() 和 array_key_exists() 详解:反转键值与键名判断 2026-07-02
- nginx配置负载均衡的几种写法与生产环境踩坑记录 2026-11-09
- 抖音封面图哪个尺寸更合适?横版与竖版的场景对照 2026-11-16
- ZblogPhp首页、列表页、文章页、tag页面调用面包屑导航代码 2022-10-11
- Python如何将两个列表的元素合并为字典? 2021-11-15