
robots协议禁止网络爬虫访问怎么排查?从日志到配置的顺序
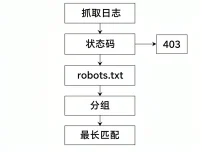
两份 robots.txt 放在两个站上,文本逐字相同,一份收录量稳步上涨,另一份同一批 URL 里有六成掉出了索引。很多人第一反应是改规则,可真正决定robots协议禁止网络爬虫访问能不能生效的,是文件落在哪个主机名根上,以及取文件时前面挡了什么。顺序是从抓取日志往回推:先看爬虫取文件的那一条,再…
- 2026年11月21日
- 24 次
robots协议怎么读?allow与disallow取舍
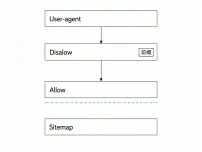
访问日志里这一行我盯了很久:66.249.66.1 - - "GET /robots.txt HTTP/1.1" 200 312。312 字节,一天被请求的次数比首页还多。要看懂robots协议怎么读,先回答两个问题:这 312 字节被谁读走,读完又怎么套到某个具体 URL 上。它不是开关,是一组按…
- 2026年11月20日
- 21 次
python虚拟环境和主环境有什么区别,装包前我踩过的坑
上周三下午,我在那台跑了三年的 Ubuntu 小机器上给爬虫项目装 pdfplumber,pip 一敲下去就提示权限不足。python虚拟环境和主环境有什么区别,这个问题我当时真没往深里想,顺手加了 sudo,结果装完系统自带的 python 直接报错起不来,代价是重装了一遍,连另一个项目的依赖也一…
- 2026年11月8日
- 47 次
宝塔及robots禁止BLEXBot垃圾蜘蛛爬虫爬行
今天查看一台Vps服务器的网站日志的时候,发现了一个爬行频率超高的蜘蛛爬虫BLEXBot,初一看这个蜘蛛爬虫觉得爬行频率那叫一个高,快的时候几秒钟爬一次,慢的时候几十秒钟爬行一次,这样的爬行频率,小小的Vps再会受得了,所以决定先看看这个BLEXBot是个啥玩意爬虫,然后再对这个垃圾爬虫进行禁止,所…
- 2022年9月19日
- 2,031 次
谷歌浏览器爬虫插件webscraper如何爬取多页面内容?
昨天简单介绍了谷歌浏览器爬虫插件webscraper的简单使用方法,可以使用爬虫插件webscraper爬取网站一些简单的基础数据,那么如果我们要爬取网站多页面的内容,也就是我们通常遇到的列表页或者是网站频道页面带有分页的内容该如何爬取内容呢?其实只需要在创建爬虫时对爬取的页面进行设置就可以爬取到多…
- 2021年12月31日
- 2,063 次
不用写代码适合0编程基础的谷歌浏览器爬虫插件:webscraper
最近看到了一个很牛逼的谷歌浏览器爬虫插件:webscraper。这款爬虫插件非常适合0编程基础的人使用,不用写任何编程代码,很快就能爬取到自己所需要的数据,当然笔者也只是偶尔看到这款插件,这几日也是简单的使用这款插件简单的爬取了一些网站数据,至于能否向Python一样爬取更多复杂的数据,目前还没有研…
- 2021年12月31日
- 1,098 次