
robots协议怎么读?allow与disallow取舍
- 2026年11月20日
- 21 次
访问日志里这一行我盯了很久:66.249.66.1 - - "GET /robots.txt HTTP/1.1" 200 312。312 字节,一天被请求的次数比首页还多。要看懂robots协议怎么读,先回答两个问题:这 312 字节被谁读走,读完又怎么套到某个具体 URL 上。它不是开关,是一组按 UA 分组、按路径长度排序的规则,谁长谁赢,长度一样时 Allow 优先。
一个 URL 是怎么被判定的
抓取器拿到文件后只做三步。先找自己 UA 对应的组,没有匹配就退回 * 那一组;再把这个组里所有 Allow 和 Disallow 的路径前缀,和当前 URL 逐个比对;最后取最长匹配的一条,长度相同时 Allow 赢。RFC 9309 是这么定的,Google 和 Bing 的实现照着来,百度搜索资源平台对 Allow 的说明也把优先级放在 Disallow 之前。
三步走完,一个 URL 的结果只有两种,抓或者不抓,没有“部分抓”。
所以 Disallow: / 后面跟一条 Allow: /about 不矛盾,意思是整站都别读,只放 /about 进去。
前缀匹配不是正则。Disallow: /tag 会连 /tags、/tag-cloud 一起封掉,只封目录本身要靠 $ 收尾写成 /tag/$。路径区分大小写,/Tag/ 和 /tag/ 是两个不同地址;字段名不区分,disallow: 和 Disallow: 一样认。
搜索资源平台的 robots 检测里输一个 tag 页地址,返回的是“禁止抓取”,改成带 Allow 例外的版本再测,变成“允许抓取”。它和本地手算的结果一致,这一步能在动线上文件之前先验一遍。
allow与disallow的写法
一个 User-agent 行开启一个组,组里的规则只对这一组生效。容易出错的地方在于“追加”:想在原组里多加一个 UA,于是在中间又写一行 User-agent,前面那几条规则就被切到上一个组,新组一条不剩。
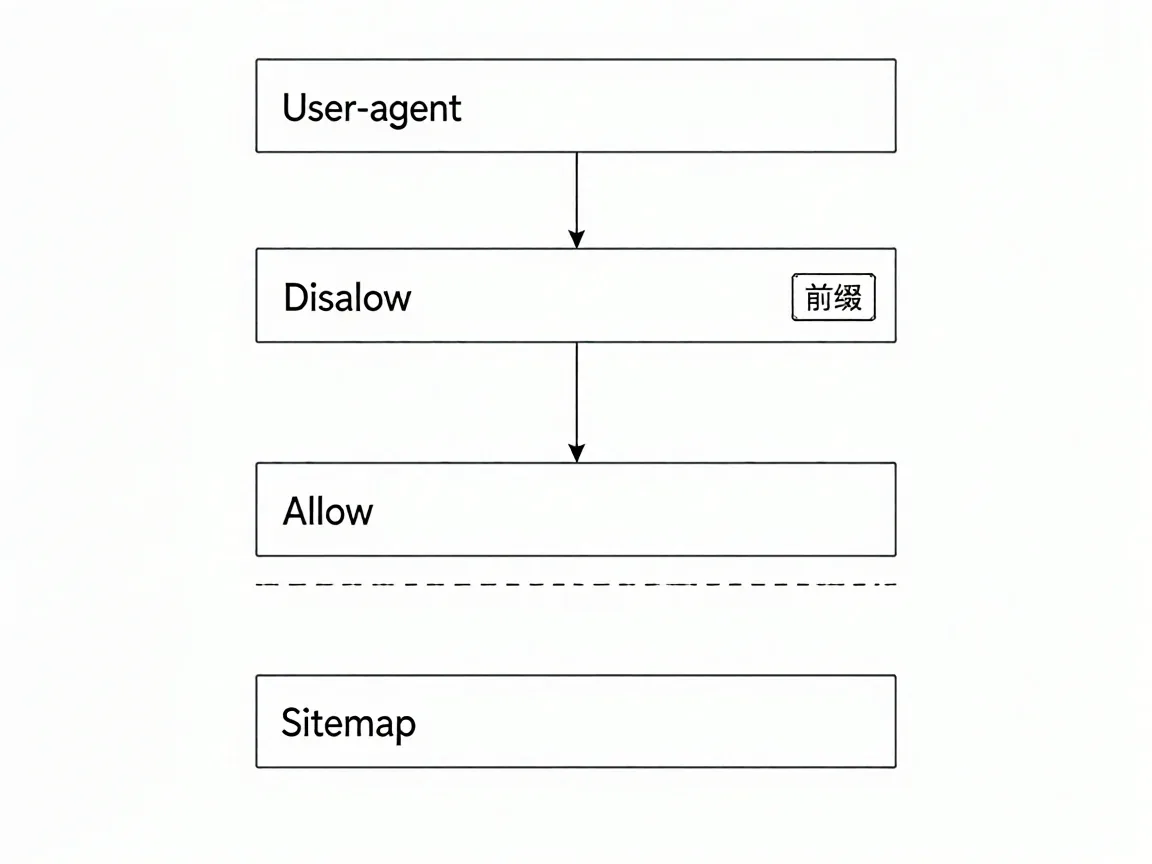
Disallow: 后面留空等于全放行,不是全封。这条语义反直觉,核对别人站点时见得最多。要全封得写 Disallow: /。
一行只放一条规则,Disallow: /a /b 不会被解析成两条,第二个路径被当成第一个路径的一部分吞掉。* 匹配任意串,Google 和百度都写在文档里;Disallow: /*? 一次封掉所有带查询参数的地址,百度对这种写法我还没在同一份文档里找到对应例子,上线前拿一批 URL 验。
Sitemap 行不归属任何一组,放在文件哪个位置都是整站声明,塞进组里也不会只对那个 UA 生效。
# 开头的是行注释,RFC 9309 把它写进语法里,Google 和百度都按注释处理,字符表里也标着「# 表示一行注释」。但注释只对人有用,别把规则藏在注释后面,也别指望每个老爬虫都按同一套规则切行。
路径大小写、空值语义、单行单规则,这三条错任何一条,规则都会静默失效,页面照样被抓。这层写法最容易被跳过,robots协议怎么读有一半功夫花在核对它上面。
robots文件的抓取顺序
爬虫只认根目录那一份,https://leetao.cc/robots.txt。协议、主机、端口要和页面完全一致,放一份到 /blog/robots.txt 等于没放。
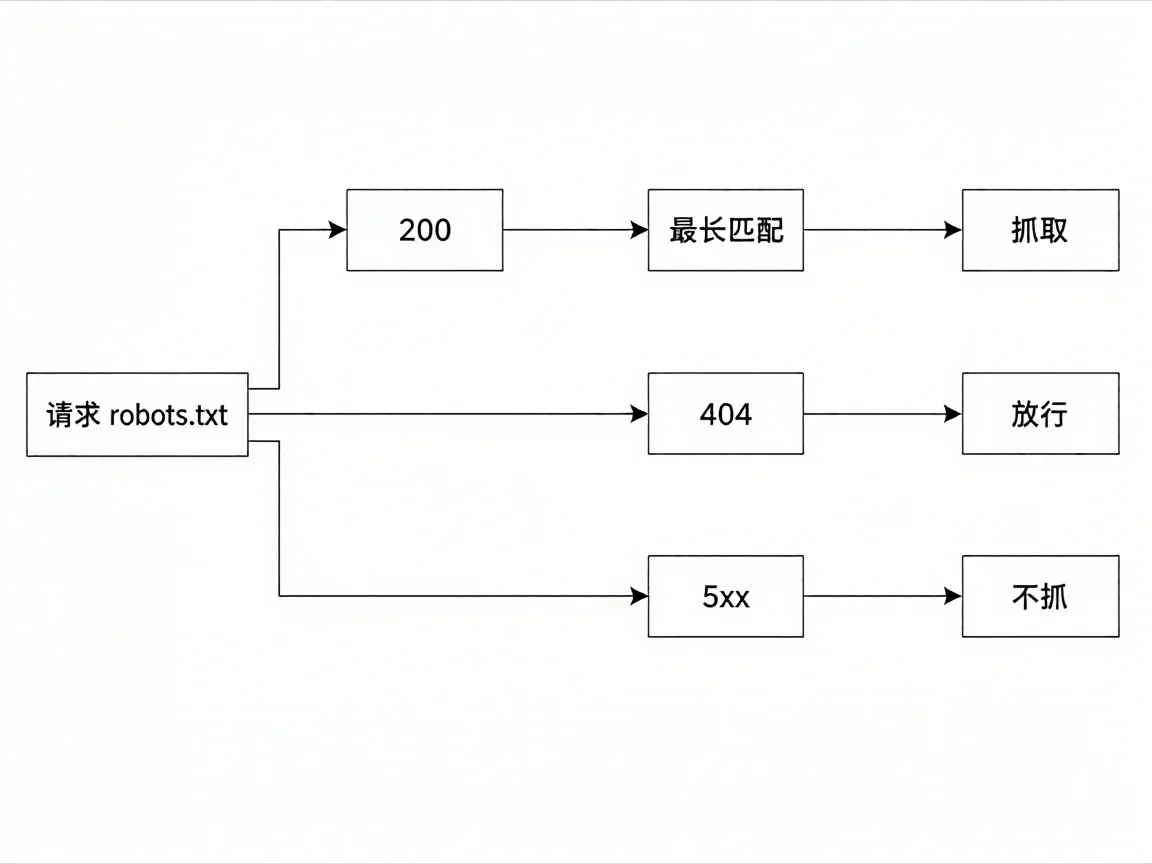
机器那一侧的执行顺序和人读的顺序正好相反:先看状态码,再看组。光盯规则行去理解robots协议怎么读,会漏掉状态码这一层。第一步请求文件,第二步判状态码,200 才解析;3xx 先跟到新地址,最多跟 5 跳,再按最终状态码判;404 和 410 视为没有限制,全部放行;5xx 按完全禁止处理,这是 RFC 9309 的硬要求,Google 遇到 5xx 会临时压低整站抓取。第三步按 UA 选组,多个组同时命中只取最具体的那个,其余忽略,不合并。第四步进缓存,缓存没到期,改文件不生效。
日志里这些请求的 UA 和抓正文的 UA 是同一个字符串。Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html) 会出现在 /robots.txt 和 /post/xxx 两种请求行上,靠它区分谁在读规则、谁在抓页面。
还有一条比语法更影响结果:robots 只决定能不能抓,不决定要不要收录。被 Disallow 的地址照样可能因为外链进索引,只是没有摘要。想让一个页面彻底消失,顺序是先允许抓取,再让页面返回 noindex——反过来做,爬虫根本读不到那行 noindex。
黑名单、白名单和一个都不写
把三种写法摆开之前,得先想清楚一件事:写错的时候,代价落在哪边。这个问题定了,robots协议怎么读基本也就定了,剩下的只是往里填路径。
黑名单是只封明确不想被读的目录。前提是站点结构稳定,你知道哪些目录该封;代价是新增目录默认被抓,得回头补;绝大多数内容站都适用。
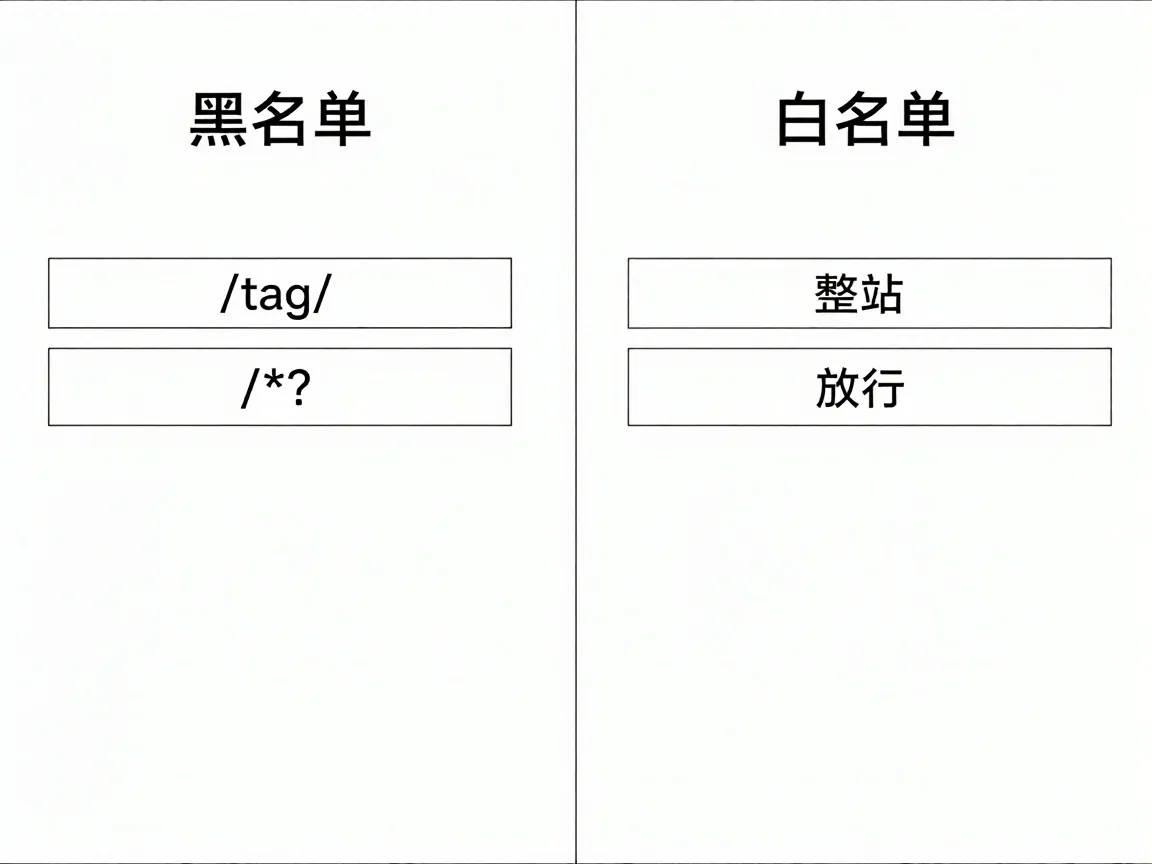
白名单是 Disallow: / 打底,再逐条 Allow: /xxx 放行。前提是能列全所有要放行的前缀;代价是漏一条整站就从索引里消失,Allow 又不支持正则,目录一多维护成本压不住;只适合测试站,或者临时只对外放一个落地页。
一个都不写,404 全放。前提是内容本来就该被抓;代价是没有粗粒度的刹车,只能靠页面里的 noindex 做精细控制。
我选黑名单加少量 Allow 例外,另加一条 Disallow: /*? 封参数页。理由是出错时的方向不同:黑名单写错是多抓几个页面,白名单写错是整站掉出索引,恢复成本差一个量级。
2025 年给 /tag/ 加 Disallow 那次,索引量从 5 300 掉到 3 900,两周后回到 4 100 上下,掉的是 tag 页本身,正文页没动。加 Disallow: /*? 之后,日志里带参数的请求从 31% 降到 6%,带宽峰值也跟着降。
规则改完,先看这三个数
日志里 /robots.txt 的返回码和字节数。改完当天应该还是 200,字节数跟着变,说明换的是线上那一份。
目标目录的请求数。从有到 0 才算生效,缓存期内一直有请求是正常的。
搜索资源平台的索引量。滞后一到两周,短期不动不代表规则没被读到。
三个数对上,才算真正闭环。
回到开头那行 312 字节。当时的错不在语法,在于我把 Disallow: /tag/ 当成了“删掉 tag 页”的动作,写完看索引没动,以为没生效,又补一条 Disallow: / 想逼它重抓,那一下让整站三天没有新页面进索引。重来的话顺序会反过来:先确认日志里 tag 页的请求归零,再等一个抓取周期看索引量,最后才动其他目录。代价是三天收录延迟,外加一次把两千多条 URL 重新提交的返工。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- PHP文件操作常用函数介绍 PHP文件操作常用函数实例代码 2022-11-12
- PHP中数组是什么?PHP数组怎么创建及打印输出 2022-10-20
- 学习前端html必须掌握要懂的英文单词 2021-01-05
- PHP如何在图片上添加文字?PHP在图片上添加文字实例代码 2022-11-22
- PHP简单的内置日期函数有哪些?PHP年月日时分秒时间代码 2022-10-11
- PHP比较运算符==号和===号的用法和区别 2022-06-14