
提示词工程常用框架是什么?四层结构与适用场景的对照
- 2026年11月20日
- 24 次
写提示词到底要不要先套一个框架?答案取决于用途:一次性对话,模板只会拖慢手速;要批量跑、要拿输出做校验,缺了结构第一次改需求就散。我日常用的提示词工程常用框架一共四层,每层对应一类容易出错的地方。
一套框架指的是什么
它不是某个官方规范。有人以为存在标准写法,去搜一圈会发现各家给的层数从三层到七层都有,差别只在拆得细不细。
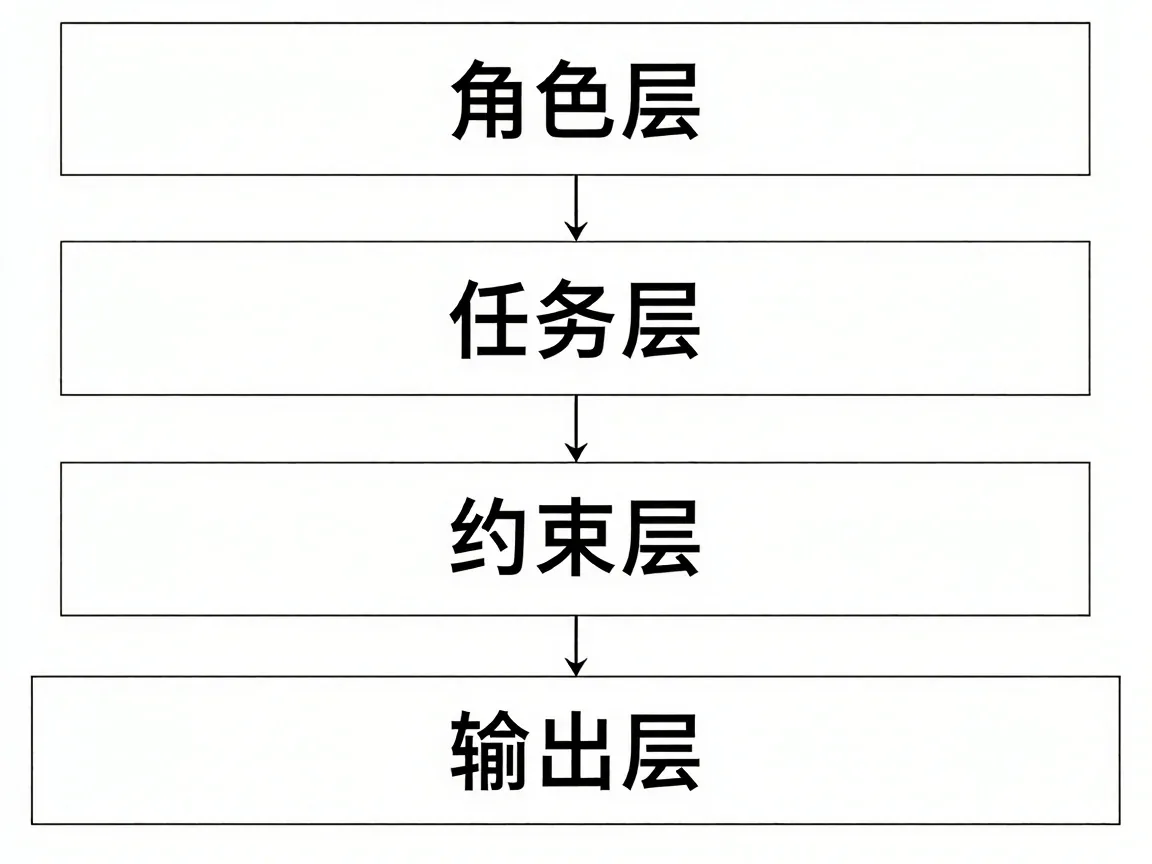
共同点倒是一致的:把「你是谁、做什么、不许做什么、怎么交」拆开写。
拆开最大的好处是改动只落在一条上。要求和格式揉成一段,本来只想调字数,改完发现字段名跟着没了。
所以框架的价值不在写的时候,在改的时候。
提示词框架的四层结构
这四层不是我拆出来的新东西,提示词工程常用框架这个说法在社区里用了两三年,各家层数不同,落点差不多。
第一层是角色层,交代谁在说话。写具体职责,再补一个排除项,比「你是资深专家」有用得多——专家会什么,模型只能靠猜。
第二层是任务层,动词加对象加范围,一句能说完最好。「整理这份会议记录,只保留决议和责任人」比「帮我优化一下」可执行。
第三层是约束层,写不许做什么、依据从哪来、拿不到依据怎么回。这层最常被写空,也是输出飘得最厉害的地方。
第四层是输出层,字段名、顺序、类型、空值怎么写,逐项列出来。类型也要写死:数量字段就要整数,别允许「大概 3 条」这种说法,否则同一批数据里迟早混进「3 条左右」。
顺序不是重点,把输出层提到最前面模型照样能读。但字段的先后有讲究:最关键的字段放第一位。我遇到过返回里 finish_reason 是 length 的情况,文本在半个字段处断掉,整段 JSON 解析失败;结论字段排在前面时,至少还能从残文里读到一句能用的。
四层加起来通常不超过两百字。超过,多半是把示例和解释也塞进了约束层。压到最短大概是这个样子:角色——你是合同专员,只读付款条款;任务——从正文里抽出金额、付款节点、违约条件三项;约束——依据必须抄原文 20 字以内,抄不到就写未提及;输出——按金额、节点、违约条件的顺序给,空值写 null。
角色设定与输出格式
这两层决定成败。中间两层写得糙一点,人读还能补救;这两层糙了,机器直接接不住。
角色层影响用词和详略。同一个抽取任务,「你是合同专员」和「你是法务助理」,后者会把条款解释也写进字段里,字段立刻变长。
输出层影响能不能被程序消费。有次按字段清单要求返回 title 和 tags,实际拿到的是外面又包了一层 data,脚本报 KeyError: 'title'。改法是在约束层补一句「顶层直接给对象,不要再包一层」,输出层再给一个只有键名的空壳。
还有一类更隐蔽:要求「给出依据」,模型回「根据相关文档」。这句无法校验,等于没给。换成「依据必须从原文抄 20 字以内,抄不到就写 原文未提及」,才有办法核对。
具体的调整顺序:打开提示词 → 找到角色那一句 → 把空头衔换成具体职责加一个排除项 → 再到输出层把字段名逐个写出来 → 跑十条样例看缺哪几个。
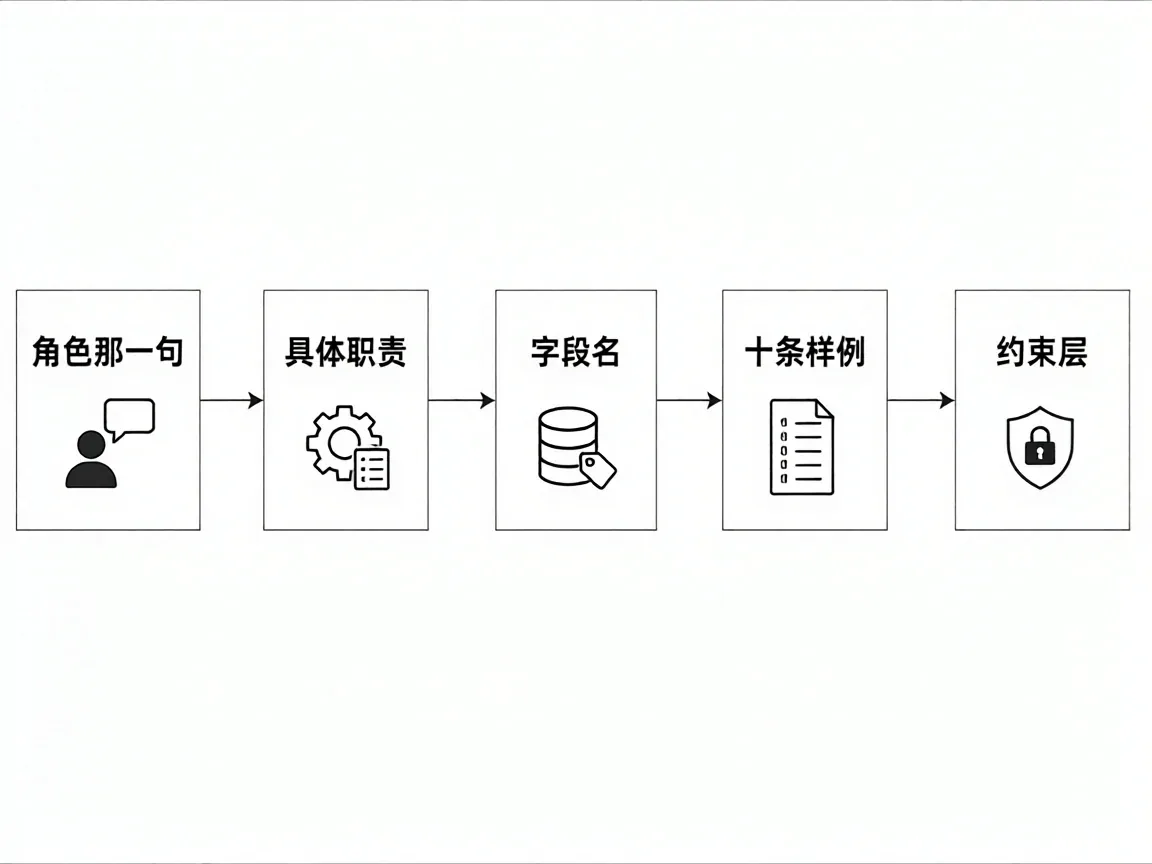
十条样例错三条以上,先动约束层,不要动任务层。任务层改一次,前面跑过的样例全部作废。
提示词工程常用框架的适用场景对照
抽取和结构化最吃四层,尤其输出层。这类任务的温度给 0.2,字段稳定比措辞好看重要。
改写和润色可以砍掉角色层,约束层换成「保留原意、不改事实、不增信息」,温度给 0.7,句子变化才明显。这两个温度值都是按 chat 类模型给的,推理模型不接受这个参数,照着设也不会生效,以官方文档为准。
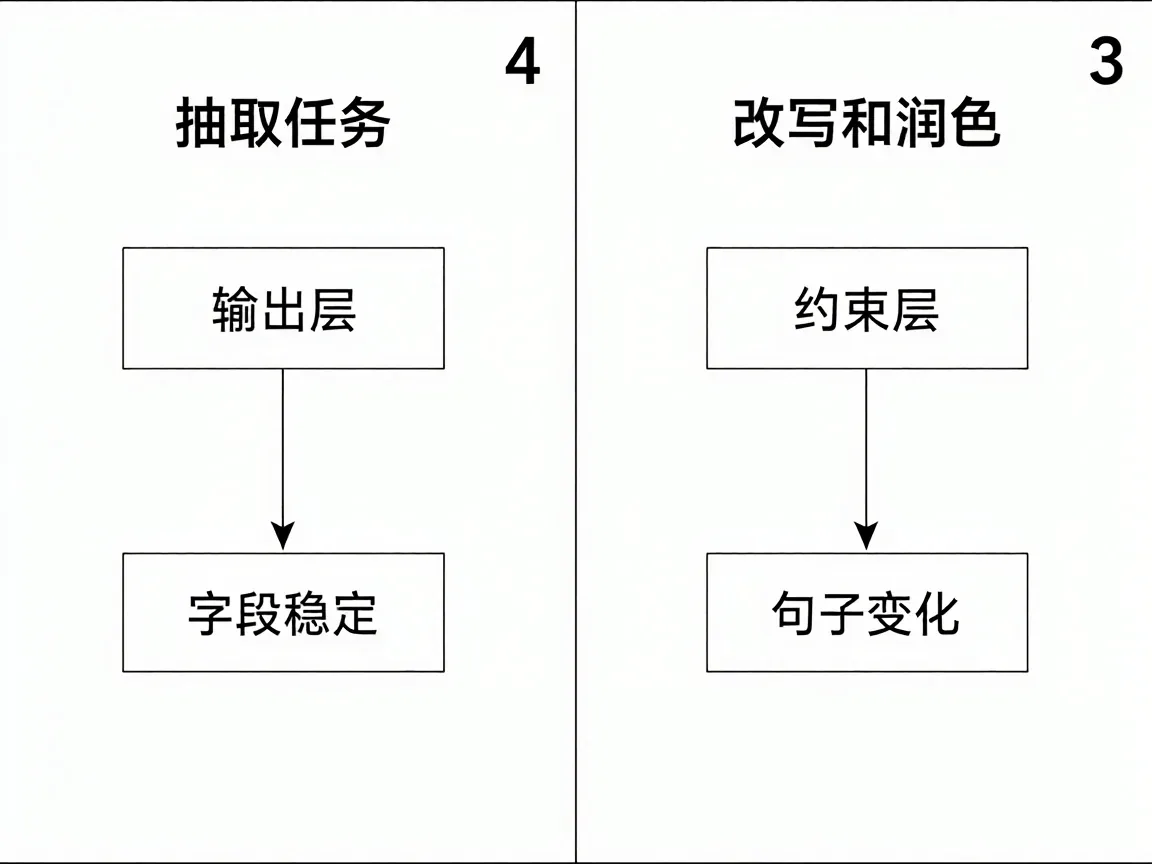
评审和打分反过来,输出层最先定:分数区间多少、扣分理由写不写、理由要不要引原文。角色层一句话带过就行。
判断依据不是任务难不难,是输出要不要被程序或别人接着用。要,输出层一个字段都不能省;不要,砍到两层也能跑。
把它当模板背没有意义,提示词工程常用框架真正起作用的地方,是每次改需求时少漏一项。
两类我给不出定论的情况
多轮对话里框架要不要每轮重贴,取决于平台是否保留系统提示。保留就不用重贴,丢了就得贴,但重贴会让上下文变长,token 成本跟着涨,长会话里这笔账不小。
超长文档加严格格式是另一种麻烦。字段一多,模型开始漏字段,约束层写得越严,漏得越整齐——不确定的字段它直接省略。这两种情况里,提示词工程常用框架能给的支持有限。目前我的做法是拆成两次调用,先抽取再格式化,稳定性上去了,调用费用也多一倍。
这两处我没有通用解,只能按调用次数换稳定性。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- PHP数组常用函数之指针函数用法及实例代码 2022-10-26
- ai生成ppt哪个最好用?三类工具的成品率对照 2026-11-18
- 大模型api平台怎么选?按计费方式和限流规则取舍 2026-11-18
- PHP array_filter() 函数详解:按条件过滤数组元素 2026-07-02
- PHP array_map() 函数详解:对数组元素统一处理 2026-07-02
- 又大又好看的ppt免费百度云下载资源怎么找?三类来源的取舍 2026-11-17