
robots协议禁止网络爬虫访问怎么排查?从日志到配置的顺序
- 2026年11月21日
- 24 次
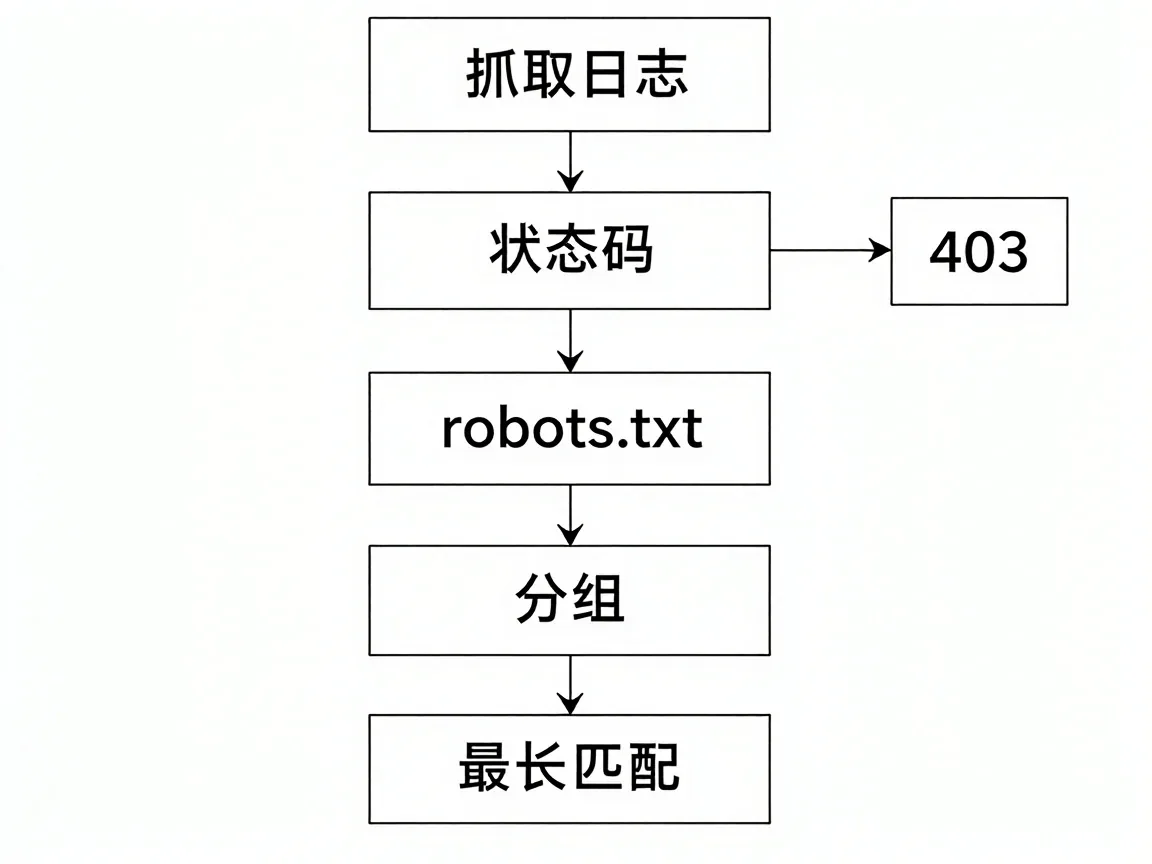
两份 robots.txt 放在两个站上,文本逐字相同,一份收录量稳步上涨,另一份同一批 URL 里有六成掉出了索引。很多人第一反应是改规则,可真正决定robots协议禁止网络爬虫访问能不能生效的,是文件落在哪个主机名根上,以及取文件时前面挡了什么。顺序是从抓取日志往回推:先看爬虫取文件的那一条,再看状态码是 200、403 还是 404,最后才回配置文件。倒过来先改规则,常常在一条本来没错的 Disallow 上折腾半天,日志里那行 403 一直没变。
抓取日志里先确认哪一件事
第一步是找爬虫取 /robots.txt 的那一条,不是找它取页面的那些条。nginx 的 combined 格式一行能读出全部要素,把这一行拆开看:
66.249.66.91 - - [21/Nov/2026:03:12:07 +0800] "GET /robots.txt HTTP/1.1" 403 162 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"
第一个字段是客户端地址,方括号里是时间,引号内是请求行,紧跟其后的 403 就是要找的值,最后一段引号是 UA。两处要核对:状态码,和 UA 里那段 Googlebot 字样——采集器会把这段伪装过去,所以还得反查 rDNS,crawl-66-249-66-1.googlebot.com 这种格式对得上才算真的。
403 的含义和直觉相反。RFC 9309 把robots协议禁止网络爬虫访问从行业约定变成了有正式文本的规范,其中 4xx 归入「不可达」,爬虫遇到不可达按「没有任何限制」处理,Google 的文档用的是同一套说法。WAF 把 robots.txt 拦成 403,不但没禁住抓取,反而让整份规则失效。
5xx 走另一条路。Google 会先暂停抓取,连续三十天以上取不到,才先用最后一次成功抓到的副本按旧规则走,连副本都没有才当成没有限制。真遇到 5xx,先去修服务,别动规则。
404 同样落在不可达里。文件不存在,等于没有限制。
robots.txt 语法里最常写错的几处
语法这一层解决的是文件读不读得懂,robots协议禁止网络爬虫访问要真正生效,还差主机名和分组两步。
- 最长匹配优先,与行的先后无关。
Disallow: /shop/private/和Allow: /shop/并存时前者更长,私有目录被禁;Allow: /page与Disallow: /page等长,放行。 - 通配符属于扩展,不在原始规范里。
*和结尾的$由 Google、Bing 支持,Yandex 也认;一些自建采集器按字面匹配,/*.pdf$在它们那里匹配不到任何路径。要挡目录就直接写目录。 - 路径大小写敏感,UA 名字不敏感。
/Admin/挡不住/admin/;googlebot和Googlebot是同一组。 - 空的
Disallow:是全部允许,Disallow: /是全部禁止,中间只差一个斜杠。删掉这个斜杠,效果是整个站点放开。 - 编码要干净。旧版记事本「另存为 UTF-8」会带 BOM,头三个字节贴在
User-agent前面,第一行认不出,那一组规则连同下面的 Disallow 一起作废;新版默认不带,要带得自己在另存对话框里勾。
带 BOM 的文件用 xxd robots.txt | head -3 一看就露:正常开头是 5573 6572 2d61,55 73 65 72 正是 User 的四个字节;带 BOM 的话前面多出 efbb bf,整行往后挪三个字节。
文件放在哪个主机名的根上
robots协议禁止网络爬虫访问的规则写在文件里,生效范围却由主机名决定。https://www.example.com/robots.txt 管不到 http://example.com,管不到 https://example.com,也管不到 https://m.example.com。四个地址在爬虫眼里是四个独立站点,各取各的文件。
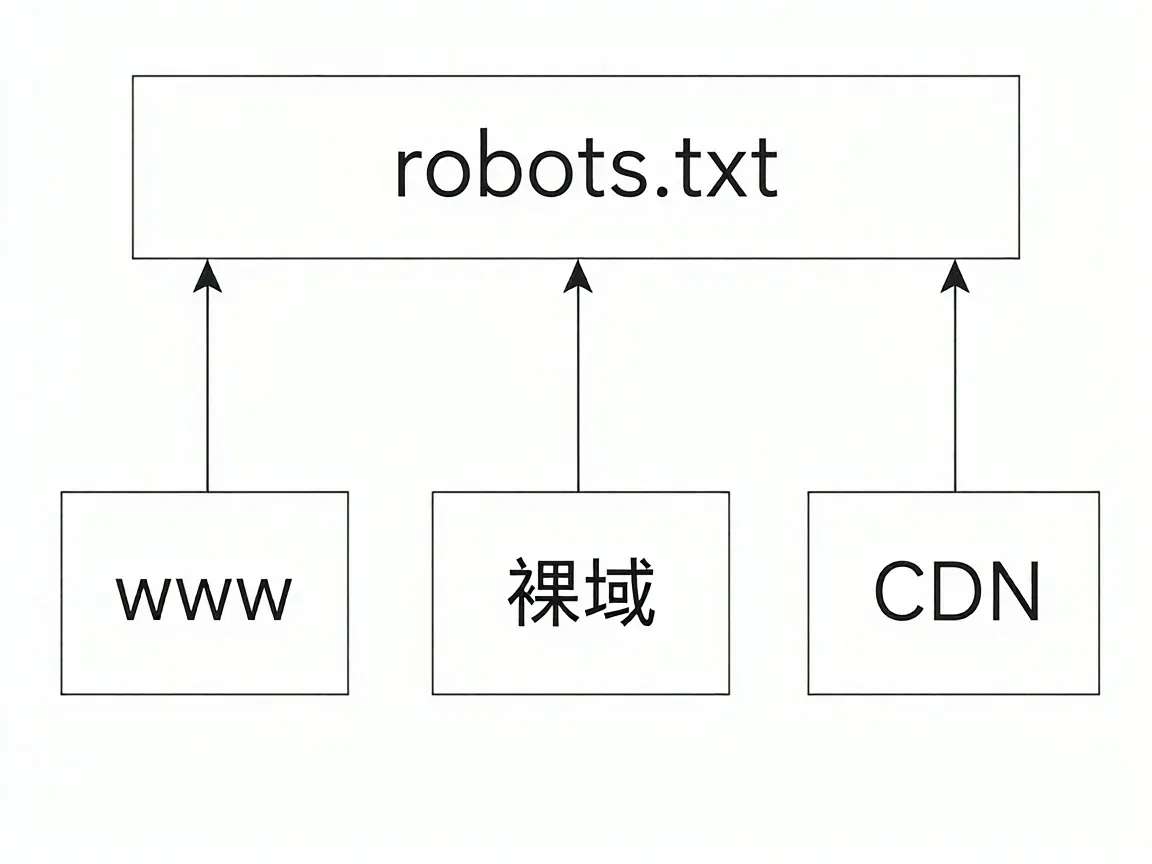
只在 www 上放一份、其余三个地址没管,是出现频率最高的一种。裸域 301 到 www 时,裸域的 /robots.txt 跟着 301,链是通的;换成 302 到活动页,或者 CDN 只回源静态目录、根路径直接吐缓存,链就断在中间。
核对办法是把四个地址逐个打开,看返回的是不是同一段纯文本。有些站点对不存在的路径一律返回 200 加首页,/robots.txt 吃同一条规则,取到的是整页 HTML,一个分组都解析不出来。
文件大小上限 500 KiB,超出部分 Google 直接截断。常规站点碰不到,把整站 URL 一条条列进去的会。
分组写错之后谁生效
一份文件里同时有 User-agent: * 和 User-agent: Googlebot,Googlebot 只读自己那一组,星号组里的规则对它一条都不生效。通用规则写在星号组、再给 Googlebot 单开一组加 Crawl-delay,通用规则就全落空,而且不会报错,日志里也留不下痕迹。
同名分组会被合并,不是后者覆盖前者。写了两段 User-agent: Googlebot,两段里的 Disallow 都算数,想删规则不能靠再写一段空组盖掉。星号组不参与合并。
规则行必须挂在某个 User-agent 行之后。文件开头直接写 Disallow: /tmp/,前面没有组,这一行不属于任何爬虫,等于没写。
挡在 robots.txt 前面的那几层
状态码不是 200 时,先怀疑前面挡了东西,别急着改文件。WAF、云防护的 Bot 管理、安全插件默认拦非浏览器 UA,robots.txt 一起被拦;nginx 里一条 location ~ \.txt$ 把 txt 交给鉴权,结果一样。返回 200 时整份规则生效,返回 403 时整份规则失效,同一个文件能给出两种结果,差别只在中间那层。
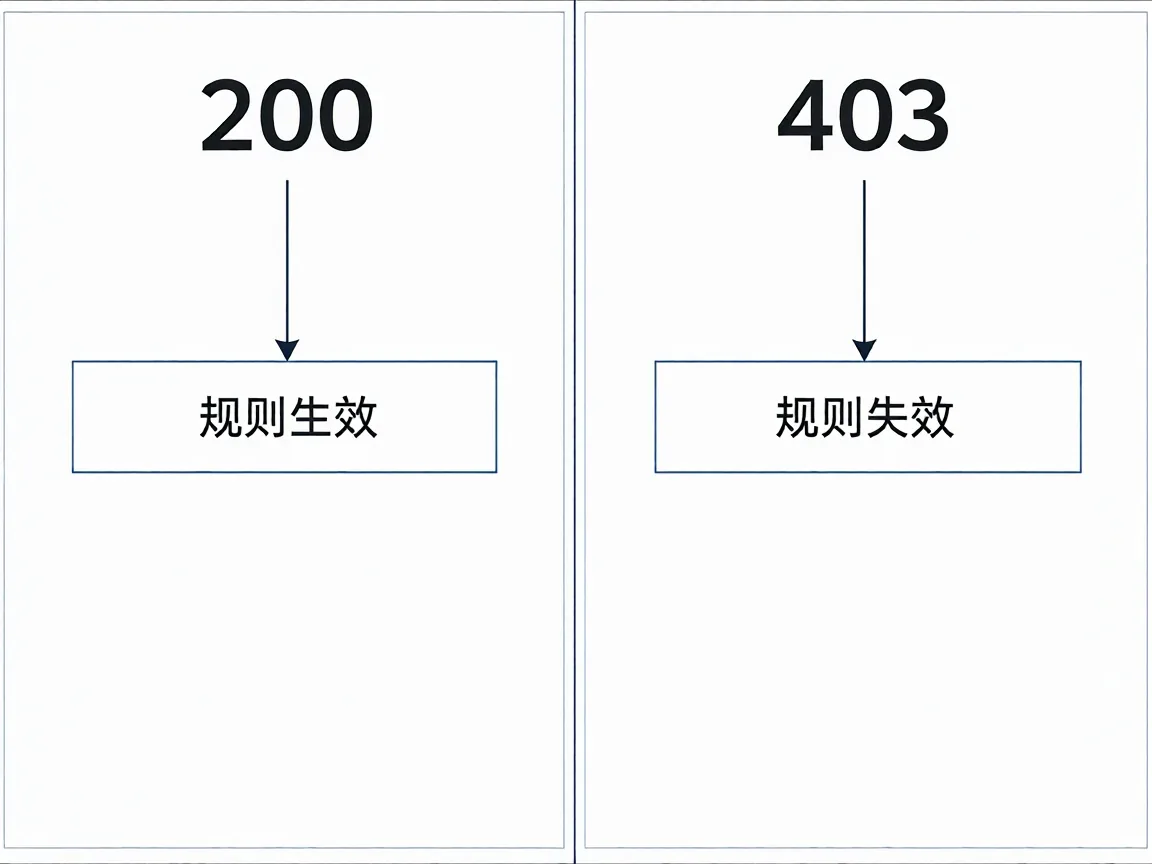
判断靠换 UA 对比。浏览器直接打开 /robots.txt 是 200,换成 curl -A "Googlebot/2.1" 变成 403,问题就在 UA 判定上,文件本身没毛病。
还有一层不在文件里。响应头带 X-Robots-Tag: noindex,页面照样被抓,但进不了索引,看起来和被协议禁掉一样。curl -I 看返回头,这一行在不在很清楚。
「不让抓」和「不让收」是两件事。Disallow 挡住抓取,页面仍可能凭外链出现在结果里,只是没有摘要;想让页面彻底消失,得先让它被抓到、再读到 noindex。两个一起用,noindex 永远读不到。
这套机制靠的是爬虫自觉,文件本身没有强制力。能拦住的只有守规矩的那批,恶意采集器根本不读这份文件,robots协议禁止网络爬虫访问对它们不起作用,得回到 WAF 和限流上。
改完之后看什么
改完不用一直刷日志。Google 对 robots.txt 的缓存按小时到一天量级刷新,取到新文件才按新规则走;页面级的规则生效更慢,几天不动是常态。核对看两点:下一次取 /robots.txt 的状态码有没有回到 200,同一 UA 抓页面 URL 的数量有没有回升。
有一种情况改配置不会有任何变化:robots.txt 是 200,页面也在抓,响应头干净,索引就是不动。这时候多半在内容质量和规范化上,比如 www 与裸域两套内容同时可访问、canonical 各指各的,索引会来回摇。协议能证明允许抓,证明不了愿意收,剩下那截要看站点自己的取舍。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- ollama命令大全列表怎么用?八个高频命令与真实输出 2026-11-21
- docker安装教程怎么装?先配镜像加速再拉第一个镜像 2026-11-12
- 关键词精准匹配和广泛匹配怎么选?看预算与词量再定 2026-11-12
- Nginx 504 Gateway Timeout超时详解:原因与优化方案 2026-07-02
- PHP的错误提示错误报告级别有哪些?如何关闭或屏蔽PHP错误报告提示 2022-11-30
- 不用写代码适合0编程基础的谷歌浏览器爬虫插件:webscraper 2021-12-31