
ollama命令大全列表怎么用?八个高频命令与真实输出
- 2026年11月21日
- 19 次
机房那台跑本地推理的机器要换盘,同事催着交一份能照着敲的清单。旧笔记翻出来没法用:几条是上个项目留下的,子命令改过名,查看和运行还混在一段里。重排时按环节把命令分了组,才发现所谓ollama命令大全列表,真正每天会用到的只有八条,剩下的大多是这八条的组合。
八条命令分在四个环节
把ollama命令大全列表按环节拆成四组,比按字母排更接近日常用法。分组只看一件事:这条命令动的是本地文件、网络,还是正在跑的那个进程。
把它当成一次会话的流程来记,比按字母顺序背省力。查看是 list 和 ps,回答本机现在有什么;取用是 pull 和 show,一个把模型搬到磁盘,一个把模型的结构摊开;运行是 run 和 serve,一个占着当前终端对话,一个把服务挂到后台给别的程序调;增删是 create 和 rm,造新 tag、删旧 tag。
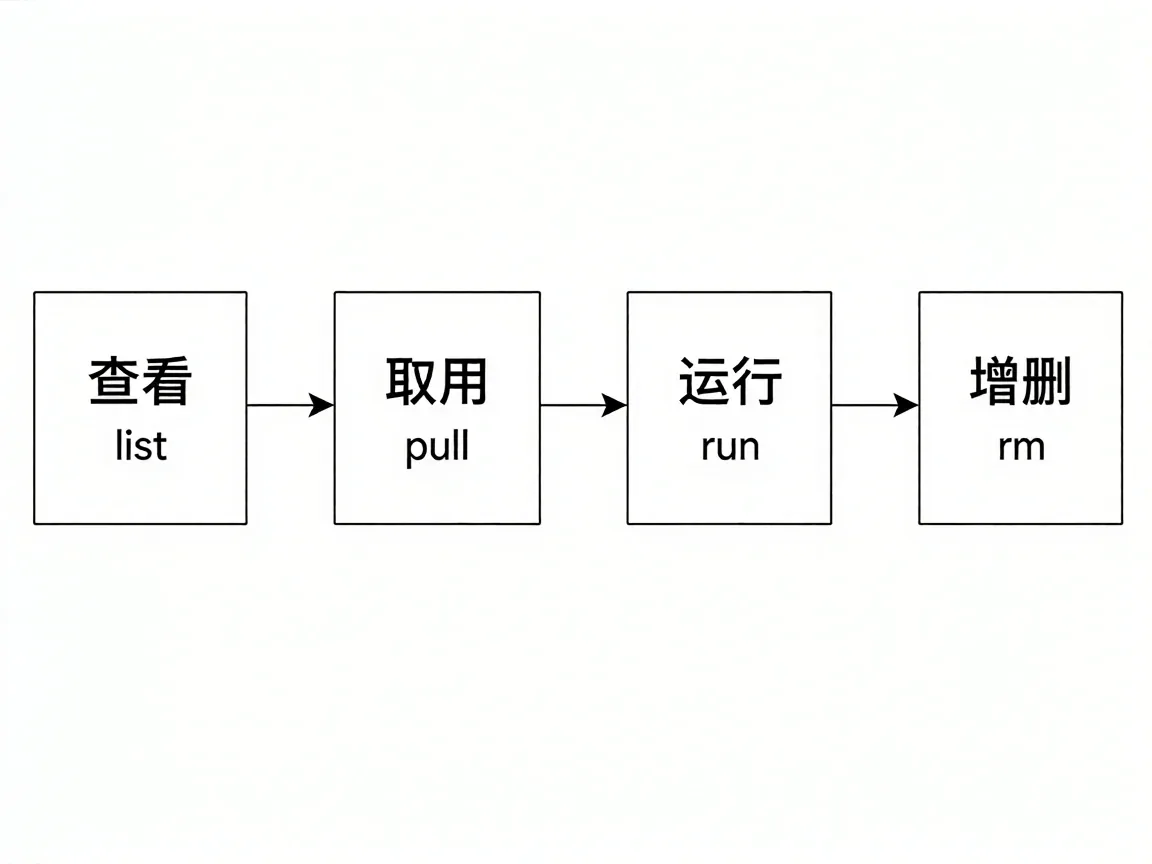
卡住的时候先判断自己停在哪一步,再去那一组里挑,八条里总有一条对得上。需要留神的只有一处:模型得先落到磁盘,run 才有东西可加载。
四组里,查看那两条最容易被当成同义词,实际读的是两个地方。
两条查看命令的分工
ollama list 读的是本地清单目录,ollama ps 读的是已经加载进内存的那份。
$ ollama list
NAME              ID              SIZE      MODIFIED
<模型名>:latest   3f9a1c2b7e04    4.7 GB    2 days ago

$ ollama ps
NAME              ID              SIZE      PROCESSOR    UNTIL
<模型名>:latest   3f9a1c2b7e04    5.6 GB    100% GPU     4 minutes from now
两边 SIZE 不是一个数。list 报的是权重在磁盘上的体积,ps 报的是加载之后的占用,多出来的那截是上下文缓存。ps 比 list 大一千兆左右属于正常,不用怀疑装了两份。
UNTIL 那列是卸载倒计时,到点模型从显存里退出去,ps 就空了。想让它多待一会儿,起服务时给 OLLAMA_KEEP_ALIVE,或者 run 的时候带 --keep-alive。
这两条常被排在一起,其实一条看磁盘、一条看内存,混着用最容易把「模型没加载」当成「模型没装」。
拉取与运行的先后
ollama run 发现本地没有会自己去拉,只跑一次的话 pull 可以省掉。多人共用一台机器时不行:run 先把下载跑完才开始加载,别人同时发起的请求全排在后面。
先 pull 再 run 这个顺序,查得到的地方都写着,理由却少有人说清:两条命令失败的位置不一样。这也是ollama命令大全列表里唯一一处顺序会改变结果的地方。pull 挂住多半是网络,run 挂住是显存不够或者参数写错,串成一条命令,报错只有一个出口。
模型落在 ~/.ollama/models 下面,manifests 存 tag 到层摘要的映射,blobs 存真正的权重。同一个基座的两个 tag 共用 blobs 里的大部分层,所以 list 里两条各写 4.7 GB,磁盘上并没有多出 9.4 GB。
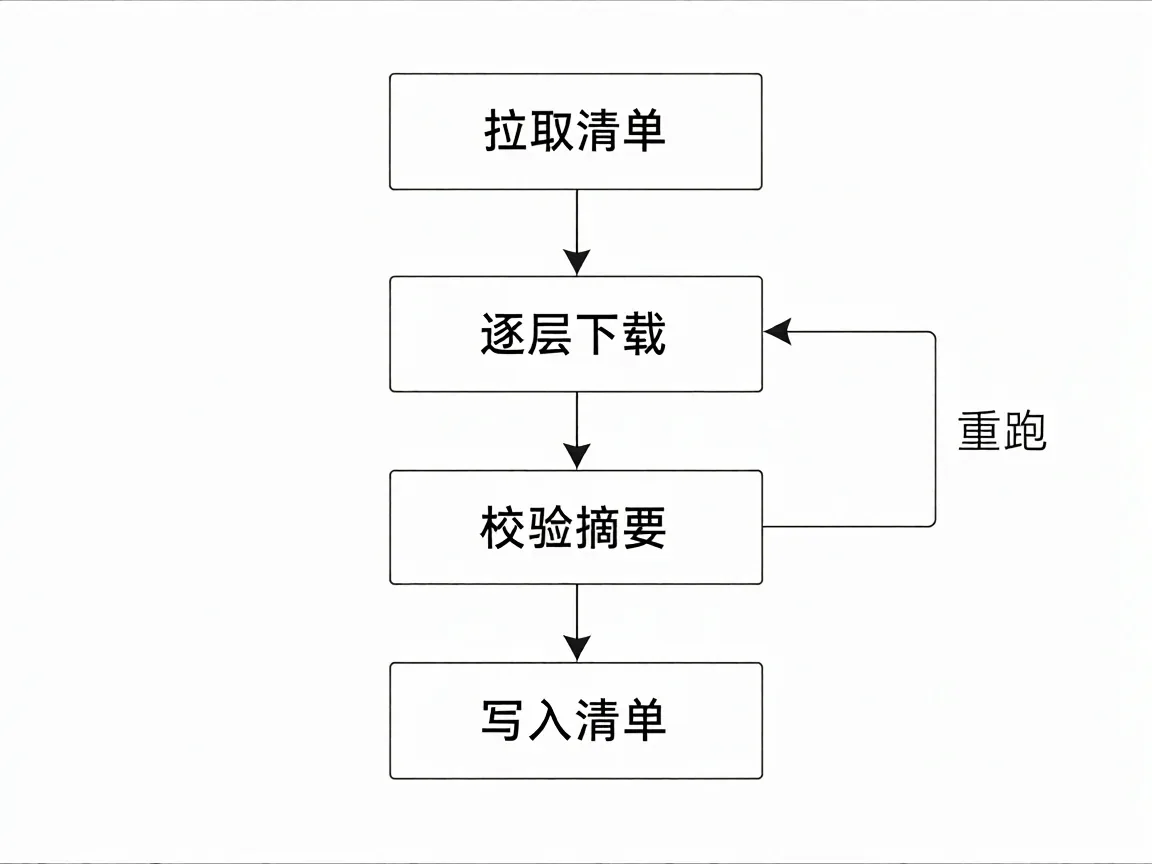
pull 的过程是 pulling manifest、逐层下载、verifying sha256 digest、writing manifest 四段。断在中途,已经下完的层留在 blobs 里,重跑 ollama pull 会跳过它们,从缺的那层接着来。想确认网络稳不稳,拉个大模型故意断一次再跑,看它跳过了哪些层,比反复测速直观。
层的校验按摘要算,摘要对不上就重下那一层,不会整包重来。这也是换个 tag 拉同一基座时,前面那些层几乎瞬间就过的原因。
模板里能改的字段
ollama show 是唯一能看进模型内部的命令,不加参数会打一大段,加 --parameters 只留参数段。
$ ollama show <模型名> --parameters
temperature    0.7
num_ctx        4096
stop    "<|endoftext|>"
这几行是当前生效的值,不是文档里的默认值。
Modelfile 里常用的字段是四个:FROM 指基座,可以是仓库里的 tag,也可以是本地已有的模型;PARAMETER 覆盖运行参数;SYSTEM 写系统提示;TEMPLATE 改对话的拼接格式。挂 LoRA 另加 ADAPTER,想把几轮对话示例写死用 MESSAGE,这两个不是日常必改的。改完要 ollama create 生成新 tag,原来的 tag 不动。
字段改完不 create,run 起来看到的还是旧值。临时试一次用 run 带参数,退出就没了;要长期生效只能落到 Modelfile 再重建。
模板这一块,多数资料只列字段名,不讲哪个字段改了需要重建,照着写容易在 create 这一步停住。
常驻服务还是临时起一个
三种做法摆在面前:桌面端装完就开机自启、ollama serve 手动或写成 systemd 单元、容器里跑再挂载模型目录。
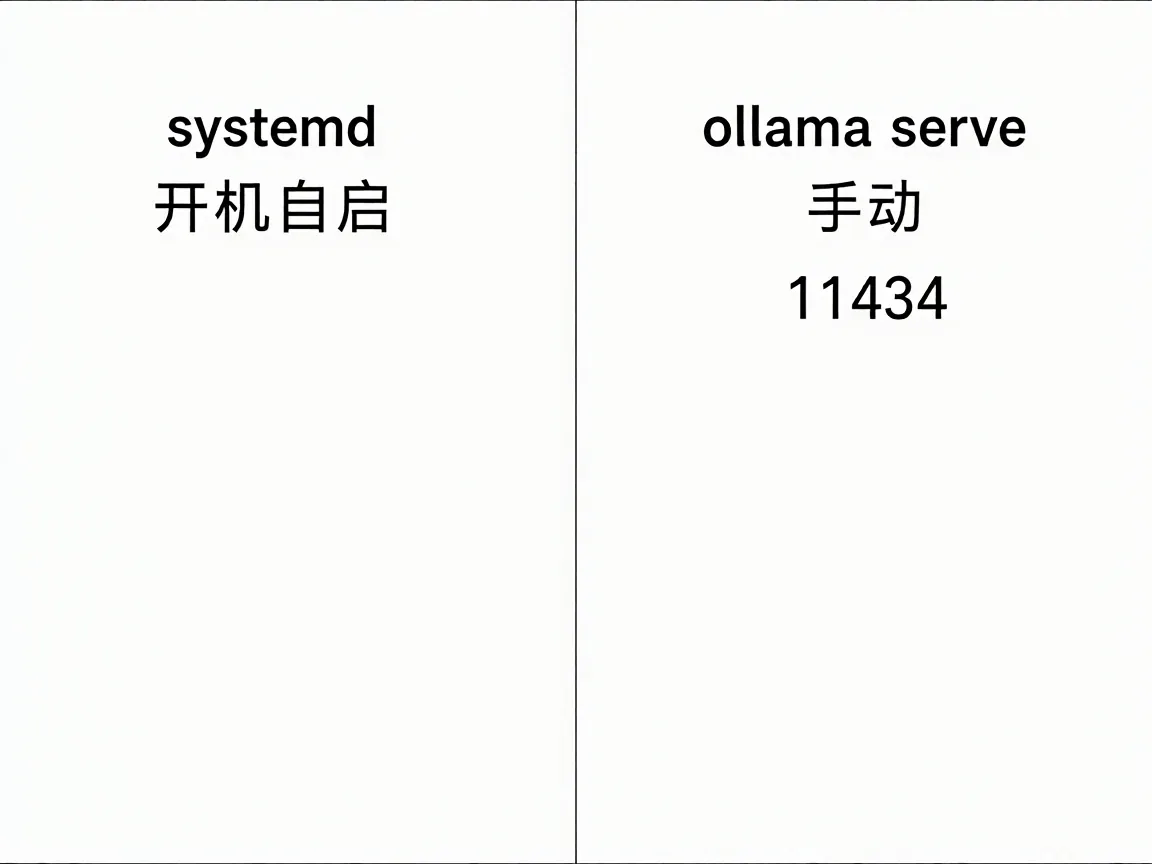
前提不一样。桌面端要有图形界面;serve 只要有 shell,端口默认 11434;容器要能直通 GPU,镜像还得跟驱动版本对得上。
代价也不一样。桌面端升级省心,但会跟着登录用户起停;systemd 归系统管,日志进 journal,改配置要 restart;容器隔离干净,模型目录挂错就是空跑一场。
适用场景分得清:一个人在本机试模型,桌面端够用;几个人共用一台机器,或者要让别的程序通过 HTTP 调,写 systemd 更稳;只有已经有一堆容器在编排,才值得把模型也塞进去。
我这台机器没有图形界面,选了 systemd,单元里给 OLLAMA_HOST=0.0.0.0:11434。它默认不带鉴权,绑到 0.0.0.0 只适合内网,外面还得有防火墙挡着。
serve 起来后日志里会打一行 Listening on,127.0.0.1 和 0.0.0.0 的区别全在这一行,外部连不上先看这里。
删之前看哪两条记录
ollama rm 删的是 tag 和它对应的 manifest,blobs 里的层只要还有别的 manifest 引用就留着。这条规则在ollama命令大全列表里最容易被跳过,跳过的人往往以为删了 tag 就腾出了空间。list 里写着 4.7 GB 的模型,rm 完 du 只降了两三百兆,是因为另一个 tag 还指着同一批层。
清盘前先 ollama list 一遍,盯两条记录:体积相同、MODIFIED 也接近的,多半是同一基座的不同 tag,删掉其中一个省不出空间。
换盘那件事收尾时我才想清楚,当时错在把 run 当成第一步。新盘上什么都没有,一条 run 把下载、校验、加载全串起来,报错时根本分不清是网络慢还是显存不够。重来会先把 list 的输出抄一份留底,再按 pull、serve、run 的顺序走,最后才动 rm。代价是多花半个晚上核对 tag 和体积,比误删一份还要重拉一遍划算。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- robots协议怎么读?allow与disallow取舍 2026-11-20
- 电脑百度网盘下载慢怎么解决?油猴1.4G大压缩包文件3分钟搞定! 2022-05-08
- Notepad怎么设置黑色背景?Notepad++编辑怎么切换背景颜色 2022-11-27
- Photoshop如何新增字体?Photoshop怎样添加新的字体 2022-09-25
- 两条路跑本地模型,llama.cpp和ollama区别在参数 2026-11-10
- 关键词布局优化策略怎么落地?四个位置的先后顺序 2026-11-18