
claude命令行调用方法,非交互模式更适合脚本
- 2026年11月13日
- 47 次
命令行调用 claude 有两种形态,交互式会话留人在终端里接话,非交互式用 -p 把提示词当参数传进去,跑完就退,结果直接走标准输出。要解决的是可重放:同一条命令跑十次行为一致,退出码可信,输出能接进下一段程序。这一层也是claude命令行调用方法里最容易含糊的地方,参数记得住,边界记不住。
第一步:用 -p 把调用压成一条命令
结论先给:脚本里不要拼交互式会话,用 claude -p,提示词走参数,上下文走管道。
claude -p "把这些函数的命名统一成 snake_case,只输出改动后的函数名"不加 -p 进的是对话界面,光标停在输入框等人打字;加上之后进程读完输入就退出,屏幕上不留等待提示。参数里的提示词和管道灌进去的内容会一起进上下文,所以同一份日志别既 cat 一遍又写进参数,token 白白翻倍。
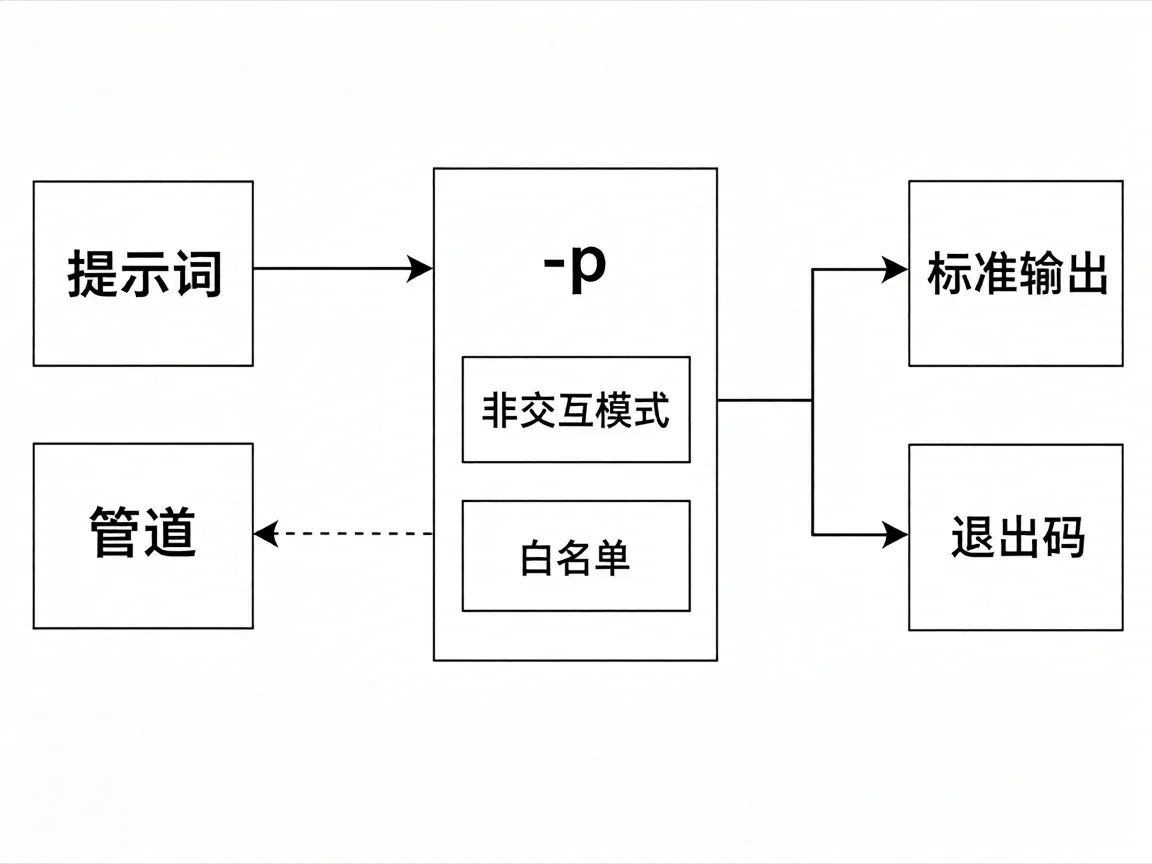
增量场景更适合管道:
git diff --name-only | claude -p '逐个判断是否含硬编码密钥,只输出可疑文件路径'输出是纯文本,一行一个路径,前后没有多余说明,wc -l 数出来就是可疑文件数。前提是提示词里把「只输出 X」写死,写不死它会自己补一段解释,下游还得再洗一遍。
非交互模式的两个硬约束:超时与权限
没有人守在旁边点确认,这是非交互模式最容易被忽略的前提。-p 下弹不出确认框,需要授权的工具调用会被直接拒掉,进程不会停住等人,表现是输出看着正常、结果却少了一块。
工具范围提前收紧,白名单没写的它调不动:
claude -p "把这些函数的命名统一成 snake_case" --max-turns 1

timeout 120 claude -p "只读 src 目录,列出未使用的导出" \
  --allowedTools "Read,Grep" --max-turns 8
--max-turns 1 是给纯文本改写准备的,不让它自己进多轮工具调用;要它读文件、跑测试,这个值就得放开,像上面第二条给到 8,代价是耗时不可控。外层那层 timeout 不能省,被它杀掉时退出码是 124,这个数字来自 timeout 本身,不是 claude 返回的。
只给 --allowedTools 还不够:读文件在白名单里能过,写文件、编辑不在白名单里的照样被拒。要落盘就在 CI 里加 --permission-mode acceptEdits;隔离容器里才考虑 --dangerously-skip-permissions,它等于把权限判断整个关掉,别在有生产凭据的机器上跑。
两个数字要分开看。124 多数是提示词太大或工具给多,原样重跑还是 124;非 0 的普通失败才有重试价值。脚本里把两者并成一个「失败」分支,重试逻辑就没法写。
输出格式决定下游怎么读
输出这一步决定调用能不能被复用。少了这一层,claude命令行调用方法就只能停在手动执行。
默认 --output-format text,标准输出就是模型那段文字,重定向进文件、接 grep 都行。要拿结构化字段就换成 json:claude -p '统计 tests 目录下没有断言的用例' --output-format json | jq -r '.result'。
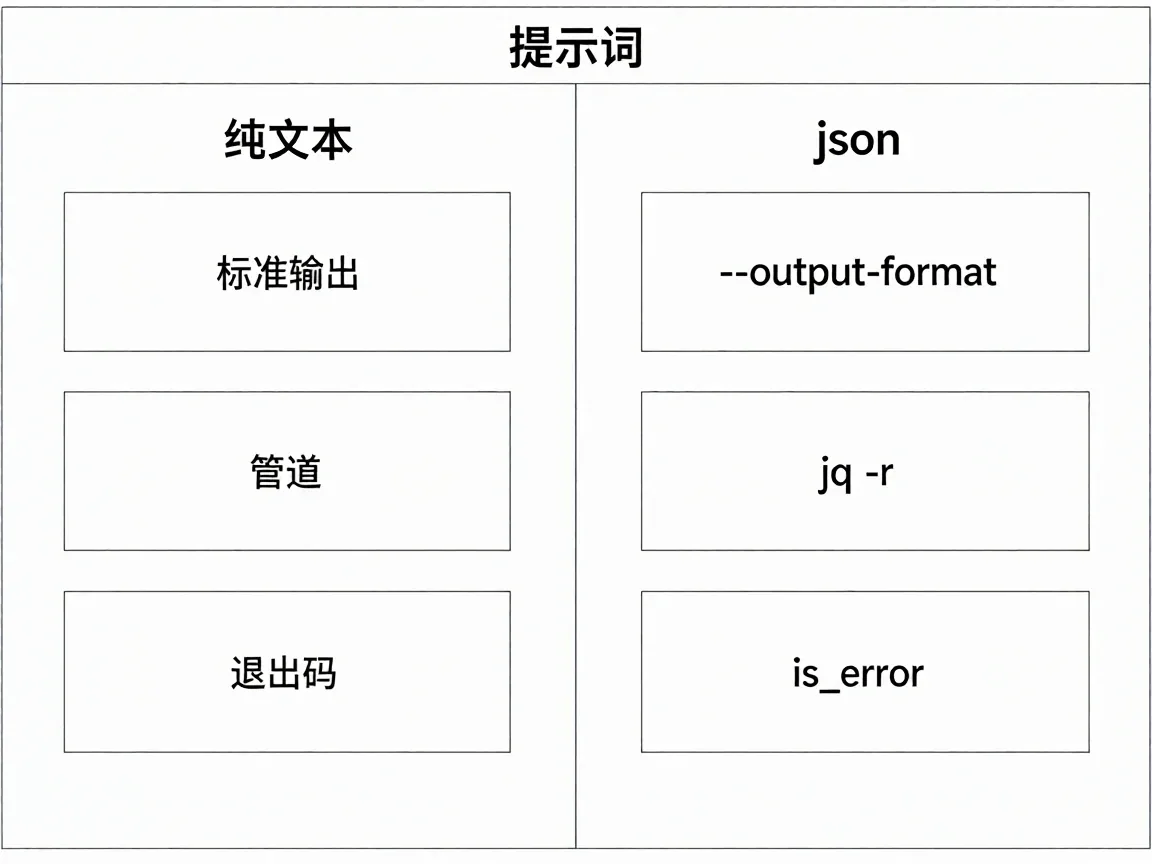
返回的是单个对象,字段大致如下,省掉了耗时和用量:
{"type":"result","subtype":"success","is_error":false,
 "result":"...","session_id":"...","num_turns":1}
result 里还是文本,只是外面套了一层壳。真正有用的是 is_error:模型侧判定这次没成,它为 true,result 里往往是错误说明。只看退出码就放行,这段说明会被当成正常结果写进文件,跑完才发现某一行根本不是代码。
要边跑边看进度,改用 --output-format stream-json,一行一个事件。这个组合在 -p 下必须同时给 --verbose,少一个参数直接报错退出,连第一行都吐不出来。
退出码和标准输出要分开判断
打印到屏幕的内容是给下游的数据,退出码是给脚本的判断,两条通道不能混。前者会被日志、diff、grep 消费,后者只该出现在 if 和 && 里。
包装脚本按这个顺序走:先判 124(超时),再判非 0(进程失败),最后解析 is_error(模型失败)。三层都过,才把 result 交给下一步。
顺序反了会浪费重试。超时的任务按模型失败去重试,等于把同一条长命令原样再跑一遍,该查的是提示词规模和白名单,不是重跑次数。
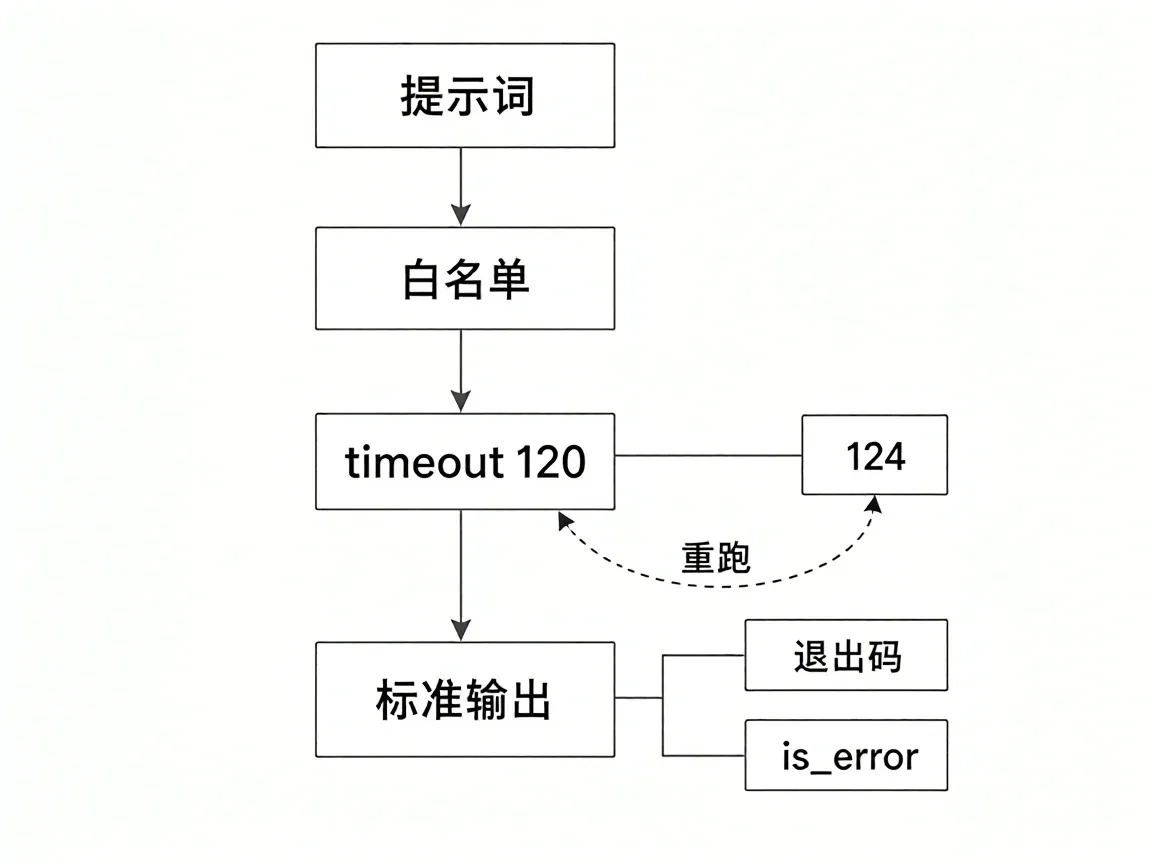
多解析一层也得多担一处失败点:jq 没装、字段改名,脚本一样断在半路。纯文本够用的场合不必上 json。
还有一处 shell 上的细节。result=$(claude -p '...') 会把结尾的换行吃掉,拿它跟原文逐字对比,长度差一位就判成不等。要原样比,重定向到文件再用 cmp,别在两个变量之间比。
什么时候不该用 -p,先排除这三种情况
claude命令行调用方法不适合需要来回追问的活,别硬塞进一次性调用。让它从三个方案里挑一个并解释取舍,第一轮不满意,交互式里可以接着问为什么不是第二个;-p 只给第一轮结果,--max-turns 加再多也是让它在自己内部多转,转到的是它的判断,不是你的。
并发要看工作目录。同一个目录同时跑十几个实例,写文件的那几个会互相覆盖,这不是 CLI 的限制,是任务没做隔离,改成每个任务一份独立副本再并发。
机器上挂了前置 HTTP 代理时,流式输出容易被代理缓冲住,stream-json 看着像一直没动静。先直连验证一次,再去怀疑命令行。
版本之间参数名有调整,--output-format 的取值以官方文档为准,别照两年前的脚本抄。团队里已经有统一封装的,就别在 CI 配置里散着写 claude -p,参数改一次要翻十几处。排除下来,claude命令行调用方法能覆盖的只剩一次性、可判定、不需要追问的任务,其余该留在交互式里。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- react按钮跳转页面没反应?从事件绑定查到路由配置 2026-11-15
- php里面怎么给字符串加反斜杠?三个函数与转义场景 2026-11-14
- PHP concat() 函数详解:字符串拼接的 N 种方法 2026-06-30
- php fpm配置怎么调?5个参数对应的并发场景 2026-11-18
- 轻量云服务器和云服务器区别在哪?按带宽与运维成本选 2026-11-13
- vite打包优化实战:分包策略、依赖预构建与产物体积排查 2026-11-07