
php fpm配置怎么调?5个参数对应的并发场景
- 2026年11月18日
- 37 次
老机器的租约到期,续费报价比去年高出一截,机房换给一台内存只有一半的新机器。旧环境里的php fpm配置是照着面板默认值抄下来的:pm 用 dynamic,max_children 给 50,request_terminate_timeout 那一行空着。平时访问量低看不出毛病,批量任务一开跑就零星 502,重启一次压下去,隔一阵又冒出来。迁移窗口给得很紧,同事只留一句话:五个参数各给一个算得出来的数。
pm.max_children怎么算
先算内存,再谈并发。新机器 8G,mysql、nginx 加系统常驻先扣 2.5G,留给 fpm 的按 5.5G 算。单进程吃多少不能看 top 顶端那个总数,得按池子量:
pids=$(pgrep -f 'php-fpm: pool www')
ps -o rss= -p $pids | sort -n | awk '{a[NR]=$1}
  END {print "子进程数", NR, "中位 RSS MB", a[int((NR+1)/2)]/1024}'
输出是「子进程数 47 中位 RSS MB 52」这样一行,第二个数就是公式里的单进程占用。我按这个数往下取,5632MB ÷ 52 ≈ 108,取到 100,余量留给 RSS 低估的那部分。
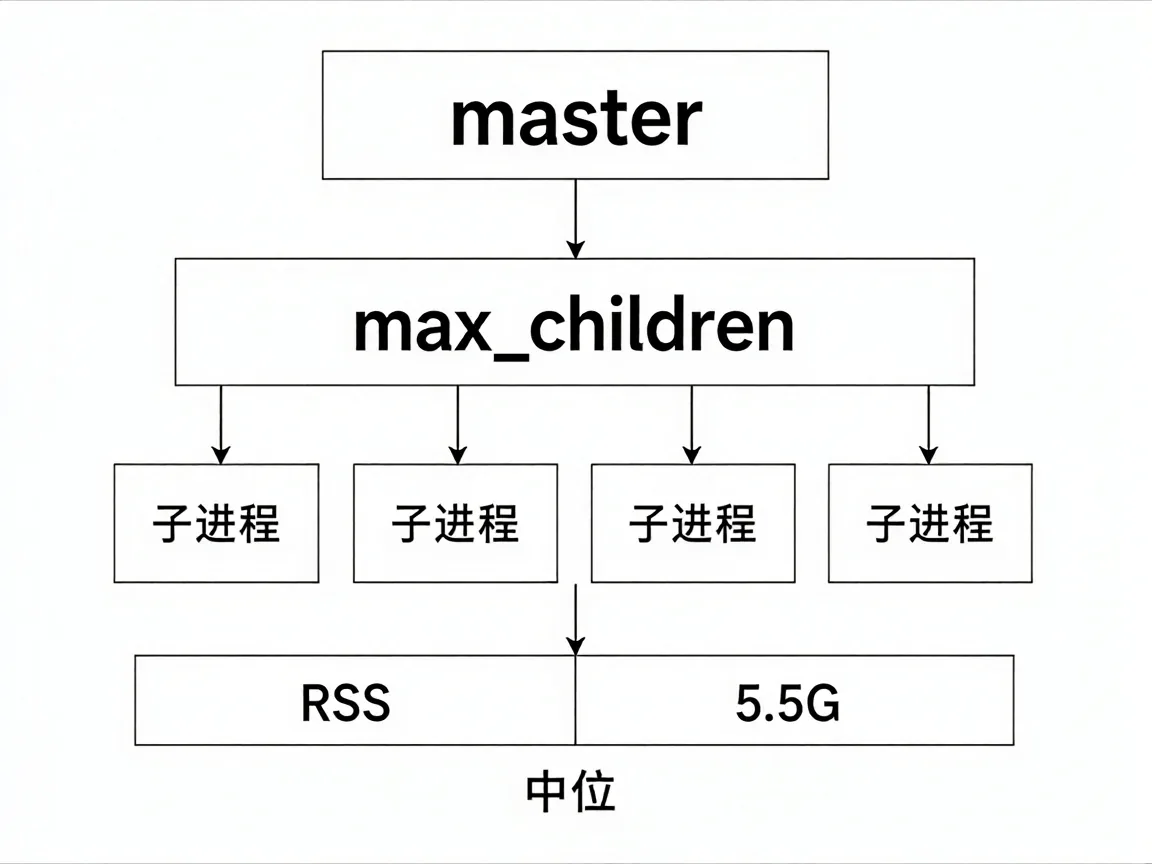
取中位不取平均:一个刚处理完大图上传的子进程能到 300MB,平均值被它一带就废,按平均算出来的上限会小掉三分之一。
还有一层误差得自己抹。RSS 把 opcache 和扩展的共享页算进了每个进程,四十七个进程相加等于重复计数。要更准就读 /proc/<pid>/smaps_rollup 里的 Pss,同池子抽三个进程比一比,和 RSS 差得不多就按 RSS 用。
五个参数里只有 max_children 能这么算出来,另外四个——start_servers、min_spare_servers、max_spare_servers、request_terminate_timeout——都得先看场景再取值。
别人的php fpm配置抄不得,机器不一样,52MB 换台机器可能是 30,也可能是 90。
top 顶上那个总数也不能直接用,它把 master、所有池子的子进程、还有一堆扩展进程混在一起。多池机器上照那个数算,max_children 会小掉一大截。
pm与静态模式的差别
static 把 max_children 一次 fork 满,之后不再增减。dynamic 只是个上限,平时驻留 start_servers 个,空闲数掉到 min_spare 以下就补,涨过 max_spare 就杀。
我这台最后上了 static。理由不是快,是行为可预测:一百个进程常驻吃 5G 出头,压力上来时新请求在 listen 队列里排,而不是等 master 现场 fork。补进程是串行的,尖峰那一下新连接只能干等。
代价也清楚:static 下 start_servers、min_spare_servers、max_spare_servers 三行全部失效,写了也不读。一台机器并排放着三四个池子,或者有几个站点只在固定时段有流量,dynamic 更划算——常驻一百个空转进程纯属浪费。
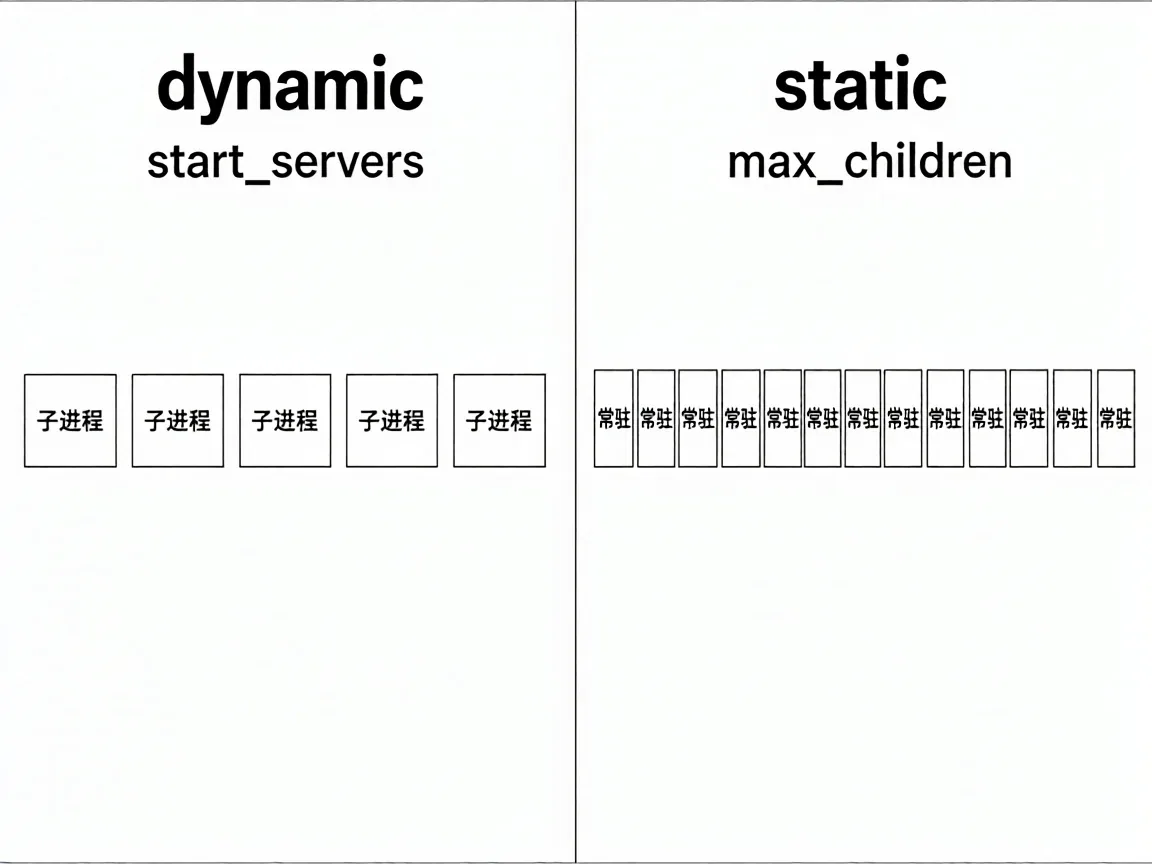
这套php fpm配置只动了 pool 文件,global 段没碰,所以上面的对比只对单机单池成立。图里的方块是示意,实际常驻数按 max_children 走。
从 50 提到 100 的那次 reload 要留神:老进程要等手上的请求跑完才退,新进程已经按新值起来了,中间有几十秒是一百五十个进程同时存在。内存本来就按 100 算的,这一段必超。做法是先把 max_children 写到 100、pm 仍留 dynamic 过渡几个小时,等老进程自然退完、常驻数落回 start_servers 那一档,再 reload 成 static——两次的峰值分别是 150 和 100,不会走到 160。
dynamic 的三个值有个能落地的取法:min_spare 取峰值并发的一成,max_spare 取三成,start_servers 用默认公式 min_spare + (max_spare - min_spare) / 2,不用手调。三个值各管一段场景:start_servers 决定低峰常驻,压到 2 个以下,第一波请求就得现场 fork;min_spare 是补进程的触发线,给太低,峰值刚起来就连续 fork;max_spare 是回收线,给太高等于把 dynamic 用成 static,空转的进程一直占着内存。
request_terminate_timeout设多少
这一项管的是另一种卡死:脚本没报错,也没跑完。max_execution_time 只计 PHP 自己的执行时间,进程卡在 curl、mysqli、file_get_contents 这些系统调用上时计时器是停的,挂多久都不触发。request_terminate_timeout 是 master 侧的闹钟,到点发 SIGTERM,进程直接消失。
消失的时候 error_log 留两行。头一行是 WARNING: [pool www] child 28562, script '/data/www/report.php' (request: "GET /report.php") execution timed out (60.015625 sec), terminating。
紧跟着 child 28562 exited on signal 15 (SIGTERM) after 60.031249 seconds from start,秒数比上面大一点点,差值就是收尸的时间。
web 池给 60s,导出和同步单独开一个池给 300s。依据是 access_log 里 $request_time 的 99 分位再往上留一档,不是拍脑袋。nginx 的 fastcgi_read_timeout 必须比它大,两个都写 60 时,通常先断的是 nginx:客户端拿到 504,fpm 那边晚几十毫秒才收尸。
pool 文件里最终留下的就这几行:
pm = static
pm.max_children = 100
request_terminate_timeout = 60s
batch 池另存一份,把 300s 和 max_children = 8 写进去,两个池的 socket 分开,慢请求就挤不到 web 池。
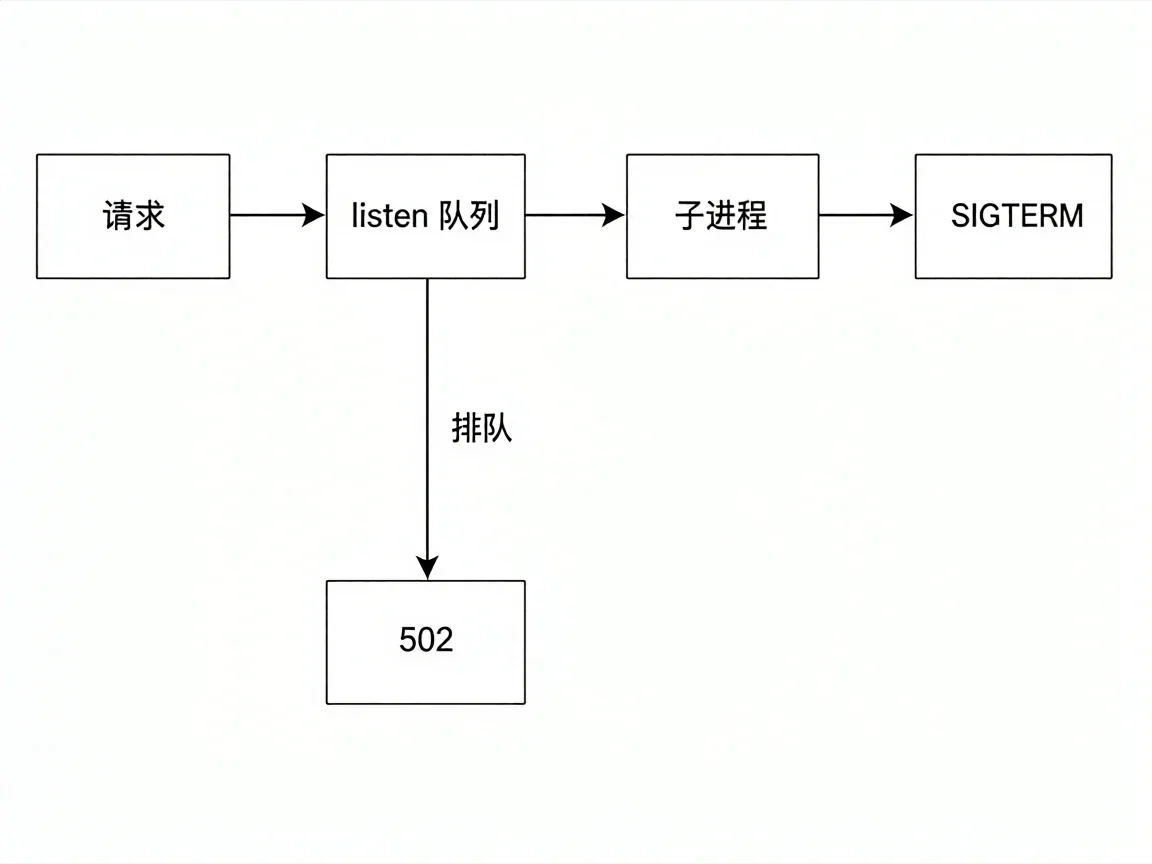
SIGTERM 之后没有宽限期,进程当场没了。正在写 session、正在落临时文件的那种请求,被砍在中间就是半个文件。所以长任务不能只调大超时,得挪到 batch 池,那里 8 个子进程卡住也不影响首页。
502 前后状态页上多了哪几行
子进程打满时 error_log 里是这一行:
connect() to unix:/run/php/php8.1-fpm.sock failed (11: Resource temporarily unavailable) while connecting to upstream, client: 10.0.0.5, request: "GET /index.php HTTP/1.1"
括号里的 11 是 EAGAIN,卡在 listen 队列上,跟 fpm 没起来是两回事。没起来会是 (2: No such file or directory) 或者 (111: Connection refused),三种错改的地方完全不同。
队列有多长、打满过几次,得看状态页。状态页要在php fpm配置里显式打开,pool 段加一行 pm.status_path = /status,nginx 侧用一个 location 把 /status 转给同一个 socket,来源 IP 限死再放行。
curl -s "http://127.0.0.1/status" | grep -E \
  'idle processes|listen queue|max children reached'
平时这三行分别是 idle processes: 7、listen queue: 0、max children reached: 0。出事那天前两行变成 0 和 12,第三行是 3——队列里堆了 12 个连接,历史上打满过三次。
切到 static 之后池子是个常数,满没满直接比 total processes 和 max_children 两个数,前者顶到 100 就是满的,不用等计数器动。
listen.backlog 调到 1024 只是把队伍拉长,子进程一个都没多,排在后面的一样吃 502,只是这行日志出现得晚一点。真到了天天能看见 12 个连接排队,方向是把子进程数或者单请求耗时压下去,不是加 backlog。
改完这三行怎么核
改完的php fpm配置不能靠感觉验收,对三个数就够。
第一步,php-fpm -t,输出末句是 configuration file ... test is successful 才算过,不过就别 reload。
第二步,reload 完立刻 curl -s http://127.0.0.1/status | grep 'total processes',数值应该正好等于 100;少于这个数说明 static 没生效,多半是 pool 名写错或者 reload 打到了另一个 socket。
第三步是压测:先 : > /var/log/nginx/error.log 清空,再 ab -n 2000 -c 80 http://<你的域名>/ 跑完,grep -c 'Resource temporarily unavailable' /var/log/nginx/error.log 是 0 才算过。涨了就回状态页,看 listen queue 是瞬间堆还是慢慢堆:瞬间堆是子进程数量不够,慢慢堆是有请求卡在 request_terminate_timeout 上没释放。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- PHP array_keys() 函数详解:获取数组键名的 N 种姿势 2026-07-02
- 实现php关联数组的增删改查学习笔记 2021-04-12
- PHP自定义回调函数简单实例 对PHP自定义回调函数的运用理解 2022-10-04
- PHP处理文件路径函数pathinfo()怎么用?PHP处理文件路径函数pathinfo()使用实例 2022-11-15
- claude命令行调用方法,非交互模式更适合脚本 2026-11-13
- 配置啥意思?从硬件搭配到软件参数的通俗解释 2026-11-12