
mysql数据库备份与恢复选哪种?按数据量与停机窗口分两条路
- 2026年11月18日
- 35 次
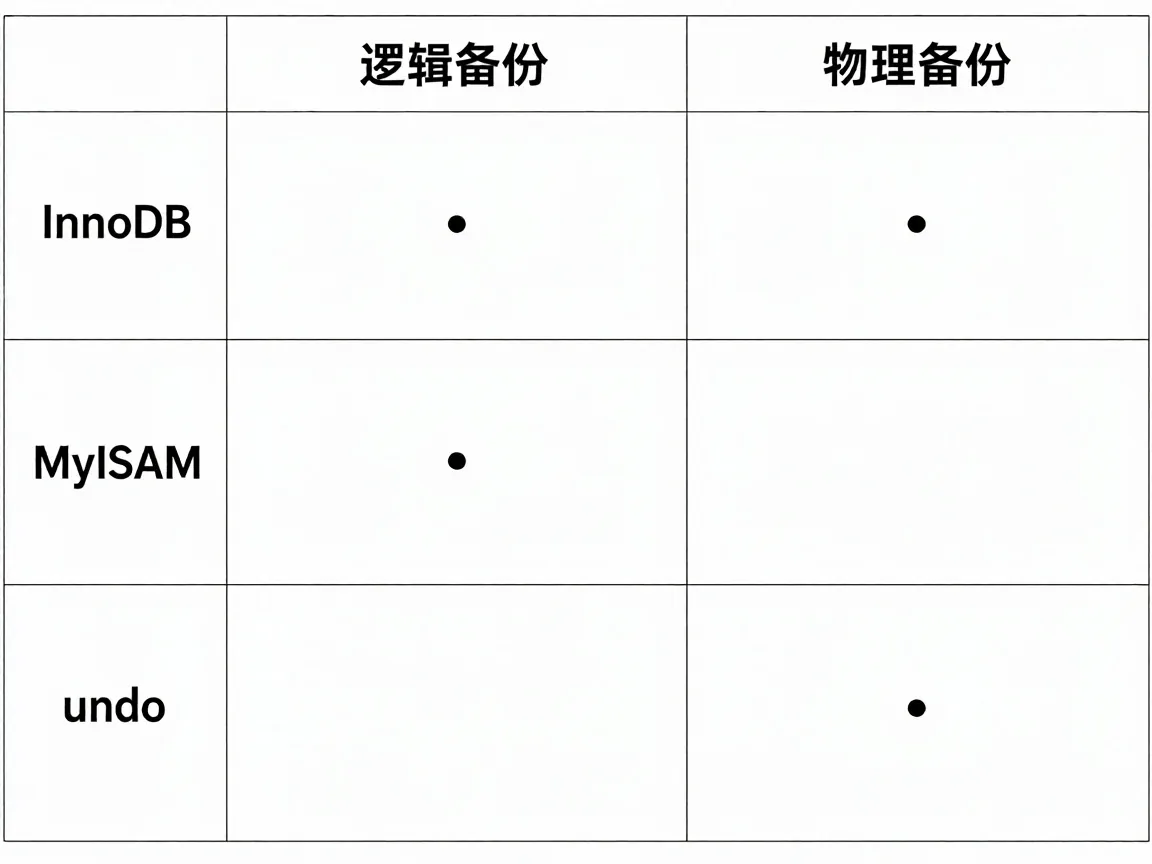
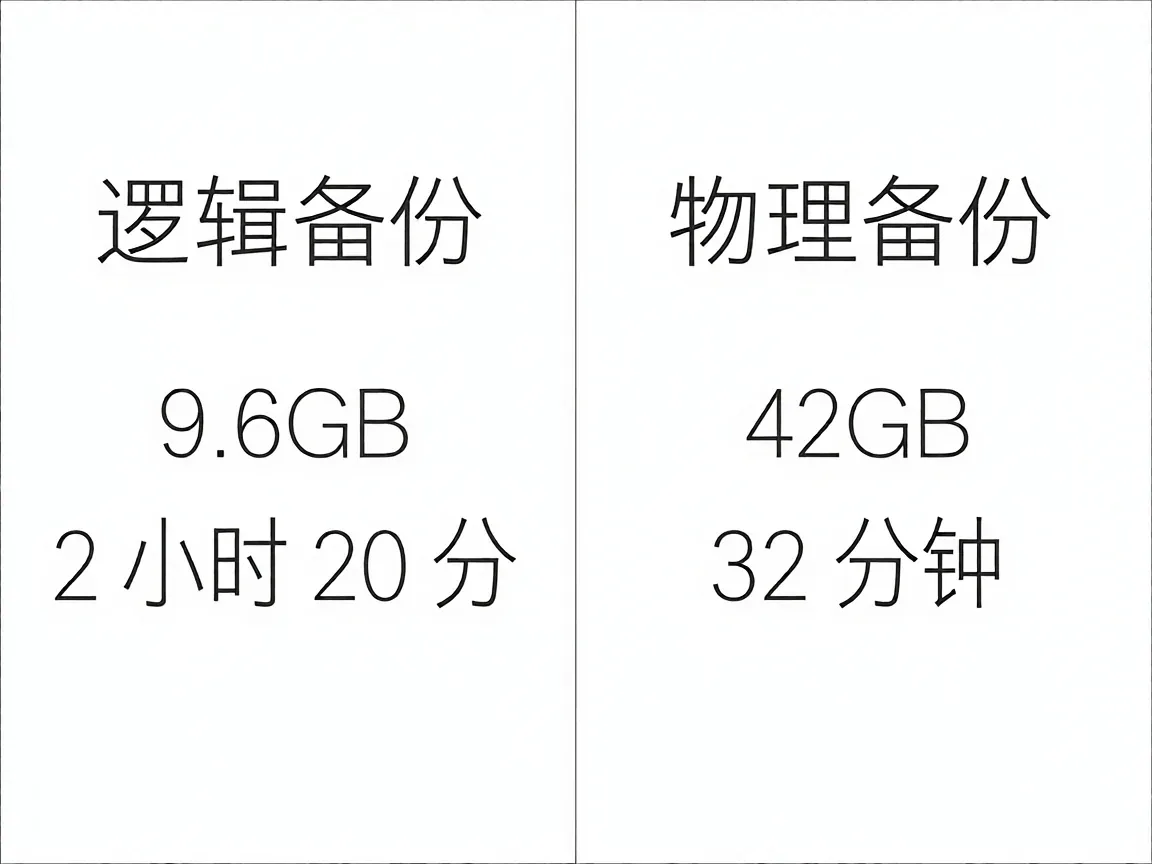
同一个 42GB 的库,两个人各留了一份:老周用 mysqldump,输出 9.6GB 压缩包,看着轻巧;我用 xtrabackup,目录 42GB,笨得没边。选mysql数据库备份与恢复方案,比的不是备份文件多大,而是出事时你多久能把库放回去——他导入跑了 2 小时 20 分,我 --prepare 加 --copy-back 一共 32 分钟。
两条路的分岔在哪
判断只有一条:恢复耗时能不能塞进你能批下来的停机窗口。库在 50GB 以下、停机能批到 2 小时以上,mysqldump 这条路够用;过了 100GB,或者停机只给半小时,就得上物理备份。50 到 100GB 这一段最难受,别拍脑袋定,先在测试实例上导一遍,量出真实时间再选。
备份跑得快不算判据。42GB 的库 mysqldump 38 分钟就出文件,看着不慢;可恢复时要一行行 INSERT、维护二级索引,2 小时 20 分才回到能对外服务的状态。备份是顺序读,恢复是随机写,两个方向本来就不对称。
mysqldump适合多大的库
50GB 这条线是算出来的。同样的库翻一倍到 84GB,导入时间大致翻到 4 小时半,多数业务的窗口给不到这么长。到了这个体量,mysql数据库备份与恢复的重心就从导出转到了导入——导出慢一点还能挂夜里跑,导入慢一点就是业务停着等。
mysqldump 属于逻辑备份,出来的是 SQL 文本,压缩比好看,代价是恢复要逐行重放。导出这条命令我用了两年,参数只留必要的:
mysqldump -h 127.0.0.1 -u backup -p \
  --single-transaction --source-data=2 \
  --set-gtid-purged=OFF --default-character-set=utf8mb4 \
  --databases shop | gzip -6 > /data/backup/shop-$(date +%F).sql.gz
--source-data=2 是 8.0.26 之后的写法,更早的版本叫 --master-data,改之前以官方文档为准。跑完 ls -lh 应该看到一个 9.6G 上下的文件,gzip -l 报的压缩比在 4.4 倍左右;文件开头有一行被注释掉的位点记录,那两个字段名在 8.0.23 起从 MASTER_LOG_FILE 换成了 SOURCE_LOG_FILE,跟选项名不是同一次改的,回放 binlog 时靠它定起点。备份账号得有 RELOAD(或 FLUSH_TABLES)权限,这两个参数才写得进去;给不了就删掉参数,改记 binlog 位点。
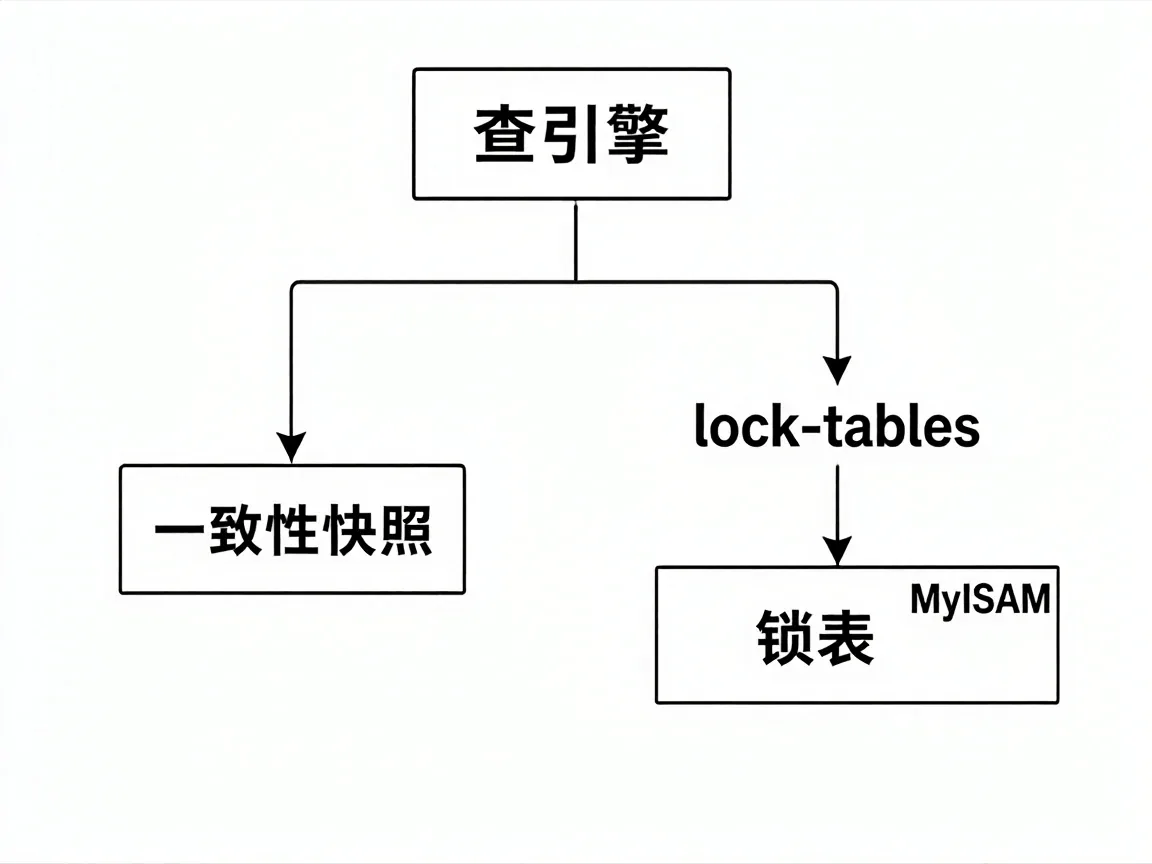
--single-transaction 拿到的是一致性快照,这个保证只对 InnoDB 成立。库里混着一张 MyISAM 表,导出来的内容前后就对不上:它不报错,文件看着完好,等你恢复完才发现两张表差了几百行。查引擎这一句就够:SELECT ENGINE, COUNT(*) FROM information_schema.tables WHERE table_schema = 'shop' GROUP BY ENGINE;
返回两行 InnoDB 214 和 MyISAM 3 的时候,多出来的那 3 张就是隐患。这两个参数也不能靠「都加上」解决:--single-transaction 生效时,--lock-tables 是被关掉的,官方文档里写明的一条,锁表的语义跟快照根本不是一回事。有 MyISAM 的库,我把这几张单独导一份,剩下的走快照。
版本不匹配是另一种停法。8.0 的客户端连一台 MariaDB 10.x,命令终止在这样一行上:
mysqldump: Couldn't execute 'SET OPTION SQL_QUOTE_SHOW_CREATE=1': Unknown system variable 'SQL_QUOTE_SHOW_CREATE' (1193)
不是权限问题,是客户端在给服务端设一个对方不认识的会话变量。换成本机对应大版本的 mysqldump 就通了,备份机和服务器的版本对齐这一条,放进巡检脚本比写在文档里管用。
停机窗口怎么估
窗口别拿 du -sh /var/lib/mysql 估。那条命令在这台机器上报 57G,真正要灌进去的行数据是 42.3GB,差出来的部分是 undo、redo 和没回收的碎片。量逻辑体积用这条:
SELECT table_schema,
       ROUND(SUM(data_length + index_length) / 1024 / 1024 / 1024, 1) AS size_gb
FROM information_schema.tables
WHERE table_schema = 'shop'
GROUP BY table_schema;
一行 shop 42.3。拿这个数除以 5 到 8MB/s 的单线程导入速率,42GB 落在 1.5 到 2.4 小时之间,和我实测的 2 小时 20 分对得上。停机窗口是mysql数据库备份与恢复里最不该拍的数。
窗口 = 停写 + 导入 + 回放 binlog + 抽查,四项相加再留两成余量。回放那一项没法拍,binlog 体积除以回放速率,只有真回放过一次才知道倍数,第一次做就拿演练数据记时间。
空间也要提前算。有一次 9.6GB 的包灌到 62% 停了:
ERROR 1030 (HY000) at line 904122: Got error 28 from storage engine
df -h 一看 /var/lib/mysql 所在分区只剩 3GB。那次是临时开的实例,分区总共 30GB 空闲,42.3GB 灌到 62%(约 26GB)再加上临时文件就把盘写满了。42GB 的行数据按 1.5 倍备盘是 63GB 起,压缩包小不等于恢复时占得少,这个差值就是停机当天最容易出事的地方。
物理备份什么时候上
库过了 100GB、停机又批不下来,mysql数据库备份与恢复就只剩物理备份这一条路。它拷的是数据文件本身,不经过 SQL 层,恢复时也不用重放 INSERT。binlog 不在备份集里,得另行备份,回放那一步才有东西可放。42GB 的库,xtrabackup 四线程备份 14 分钟,目录 42GB 上下——默认不压缩,别指望体积变小。
xtrabackup --backup --target-dir=/data/xtra/<日期> \
  --datadir=/var/lib/mysql --parallel=4
跑完 target-dir 里会有 xtrabackup_checkpoints,第一行 backup_type = full-backuped,下面 to_lsn 后头那串数字要抄下来,做增量时拿它当起点。恢复三步:--prepare 6 分钟,--copy-back 12 分钟,起 mysqld 再核对表数量 14 分钟,加起来 32 分钟。
约束比 mysqldump 硬:目标实例的版本不能低于源实例,innodb_page_size 必须一致,copy-back 之前 mysqld 必须停。三条任意一条不满足,prepare 或者启动阶段就过不去。还有一条容易忽略——单表恢复得先 --export 导出表空间再 import,步骤比重放 SQL 麻烦得多,捞一张订单表往往要绕一圈。
这套路数在哪些情况下别用
单库不到 20GB、又经常要捞单表数据,别上物理备份。恢复一张表要走 --export 再 import,操作成本比 mysqldump 单表导 200MB 高得多,那几分钟的导出更省事。
要做大版本升级,物理备份给不了这条路。5.7 的备份目录不能直接 copy 进 8.0 的 datadir,页格式和系统表都对不上,只能走逻辑导出再导入。
从库延迟已经吃紧的时候,也别在同一台机器上跑 mysqldump。长事务会把 undo 撑大,延迟跟着往上走,备份窗口和业务高峰撞在一起就是双重麻烦,换到延迟从库或者只读实例上做。
最后一条是人的问题:团队里没人跑过 --prepare,就别选物理备份。恢复手册第一页写清目录权限、chown 谁来做、起库后核对哪几张表,这三行省下的就是那半小时。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- PHP explode() 和 implode() 函数详解:字符串与数组互转 2026-07-02
- python字符串常用方法有哪些?6个高频函数的参数与返回 2026-11-15
- css选择器nth-child怎么用?4种取值与负号边界 2026-11-20
- 私人网站有什么用?私人网站还在还能赚钱么? 2022-09-02
- react按钮跳转页面没反应?从事件绑定查到路由配置 2026-11-15
- 自建Chevereto图床网站教程 拥有自己的图床网站 2021-12-27