
python字符串常用方法有哪些?6个高频函数的参数与返回
- 2026年11月15日
- 49 次
机房角落那台跑采集的机器 2019 年上的线,CentOS 7,系统 Python 停在 3.6,另装了一个 3.9 在 /usr/local/bin 下面,两套并存。七个解析日志的脚本挂在上头,最老的那个六年没改过,每天还在切字段、去行尾空白。这些脚本里python字符串常用方法翻来覆去就那么几个,接手的同事每次都要问一遍参数和返回值。
六个函数的名字与它们各自的返回值
日常解析用得上的高频函数,python字符串常用方法数下来就六个:find、replace、split、strip、join、startswith。按返回值分四支,find 给整数下标,找不到是 -1;replace、strip、join 给新字符串,原串一个字都不改;split 给列表;startswith 给 True 或 False。
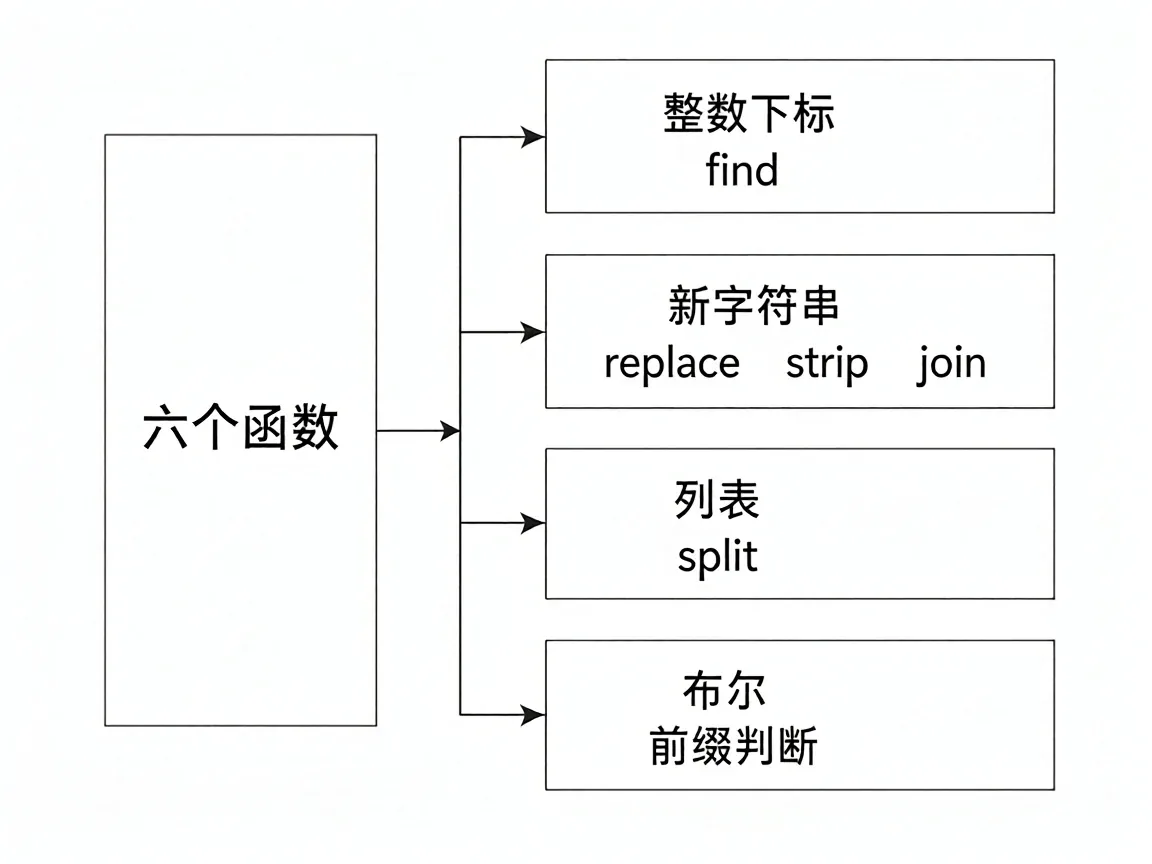
字符串不可变,返回字符串的那三个也不会改原串,变量必须接住返回值,s.strip() 单独占一行,s 一点变化都没有。
参数记不住可以翻文档,返回值记错就会写出看着对、跑起来不对的代码。if 里少一个 == -1,整批任务能被一行没有时间戳的日志带停。
列表那一支要单独留意,切出来的元素个数不固定,直接按下标取第三段,碰到字段少的行就 IndexError。find 那一支的 -1 既不是 None 也不等于 False,它是真值,判断只能写 == -1。
python字符串查找:find、index 与 in 的返回差别
同一个位置查询,三种写法前提不同。in 只回答存不存在,给布尔;find 给下标,找不到返回 -1;index 也给下标,找不到抛 ValueError。三者取舍不一样:in 拿不到位置,得再查一次;index 省掉判断,可异常会一路往上冒;find 多写一行 if,换整批任务不中断。
>>> "abc".find("z")
-1
>>> "abc".index("z")
ValueError: substring not found
ValueError 后面那行是原样输出,不带下标,堆栈里也看不出缺的是哪个字段,只能在调用处自己包 try。日志解析里我不用 index,就是为了这个。
find 的参数不止一个。"abcabc".find("a", 1) 返回 3,第二个参数是起始下标;第三个是结束下标,取开区间,"abcabc".find("a", 1, 3) 返回 -1,因为 [1, 3) 里只有 b 和 c。rfind 从右往左找,"abca".rfind("a") 给 3。空串要当特例,"abc".find("") 返回 0。
字符串替换的方法:replace 的两个参数怎么用
换文本这件事,python字符串常用方法给出的第一个入口是 replace,形状是 replace(old, new, count)。count 省略就全换,给了数字只换前几个,"aaa".replace("a", "b", 1) 得 'baa'。old 和 new 只能按位置传,写成 replace(old="a", new="b") 报 TypeError: replace() takes at least 2 positional arguments (0 given),三个参数里关键字只剩 count 能用。
和 re.sub 摆在一起比:replace 的前提是字面量匹配,不认模式;re.sub 能按模式改,代价是模式串要转义,替换内容里的反斜杠也得处理,报错比 replace 难读。要找的是固定子串,replace 一行写完;要按模式改日期、合并多个空格,才动 re。
old 传空串时,replace 会在每个字符之间插一遍,"abc".replace("", "-") 得 '-a-b-c-'。拿它当分隔符拼接之前,先确认 old 不是空。
切分的边界:split 带不带参数的区别
切分这件事,python字符串常用方法最常用的是 split,但它带不带参数是两套规则。不带参数按任意空白切,连续空白算一个,首尾空白直接丢;带参数按字面切,连续分隔符之间会切出空串。
>>> "a  b".split(" ")
['a', '', 'b']
>>> "a  b".split()
['a', 'b']
两个空格进去,带参数那次中间多一个空串,元素个数从 2 变 3,后面按下标取字段的代码全部错位。
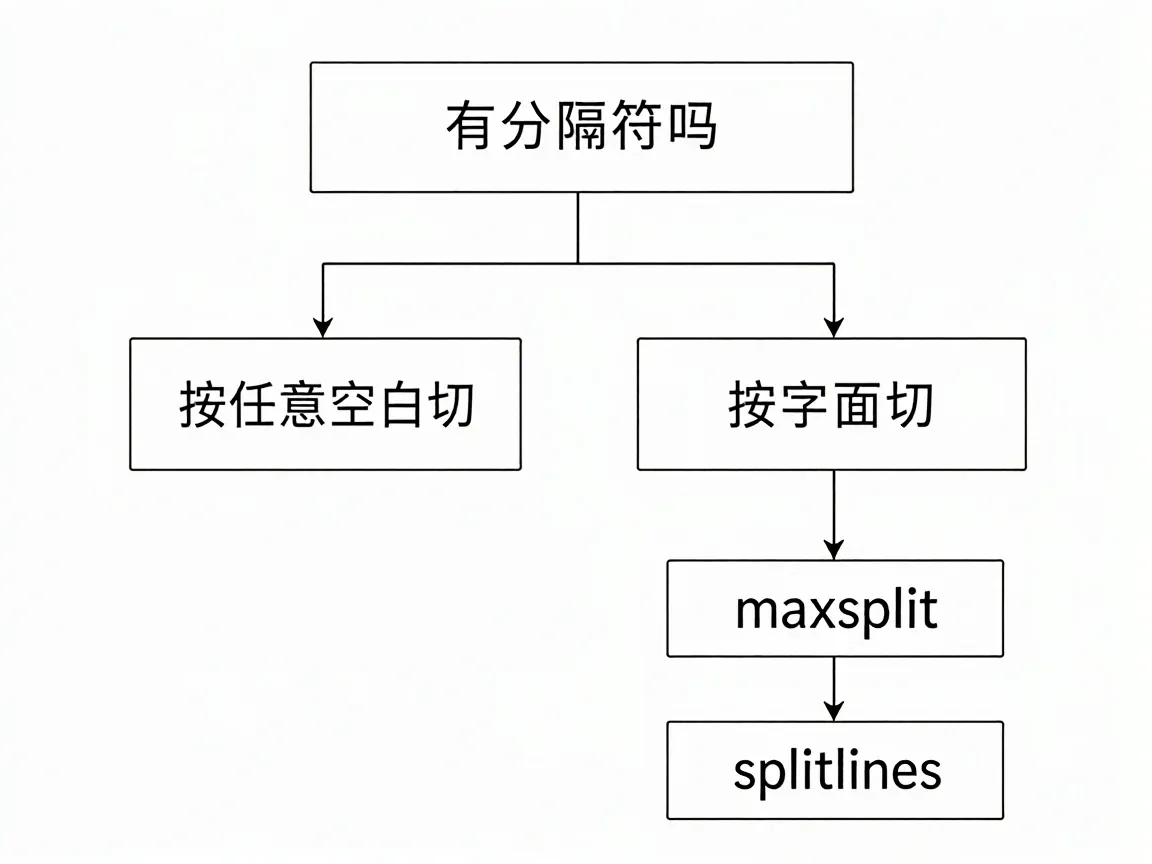
maxsplit 是第二个参数,控制切几次,"a-b-c".split("-", 1) 得 ['a', 'b-c'],剩下的不再切。给 0 是根本不切,"a-b".split("-", 0) 得 ['a-b'];给负数等于不限制,跟不传一样。解析 key=value=extra 这种一行多等号的配置正好用 1,左边是键,右边整段是值。
换行切分要单独说。split("\n") 会留下行尾的空元素,"a\nb\n".split("\n") 得 ['a', 'b', ''];splitlines 不保留行尾,同一份输入给 ['a', 'b'],\r\n 也认。读文件逐行处理用 splitlines,数行数时少一个空元素。
去空白与拼接:strip 的 chars 与 join 的入参
strip 的参数是字符集合,不是前缀。"xxaxx".strip("x") 得 'a',两头所有的 x 都剥掉;"abcba".strip("ab") 得 'c',从头剥到 c 停,从尾也剥到 c 停。只去一边用 lstrip 或 rstrip。不传参就只去空白,\t、\n、\r 都算,中间的不动。
join 的调用方向容易记反,分隔符在前、列表在后,",".join(["a", "b"]) 得 'a,b'。入参元素必须全是 str,混进数字直接报错。
>>> ",".join(["a", "b"])
'a,b'
>>> ",".join([1, 2])
TypeError: sequence item 0: expected str instance, int found
报错点名了第一个元素是 int。拼数字要先 map(str, items),这一层转换换掉的是循环里用 + 一段段接的写法,每次 + 都生成新字符串,几千行拼下来内存里全是中间产物。join 先算总长度再分配,代价是手上得先有一份完整列表。
前缀判断:startswith 为什么能吃元组
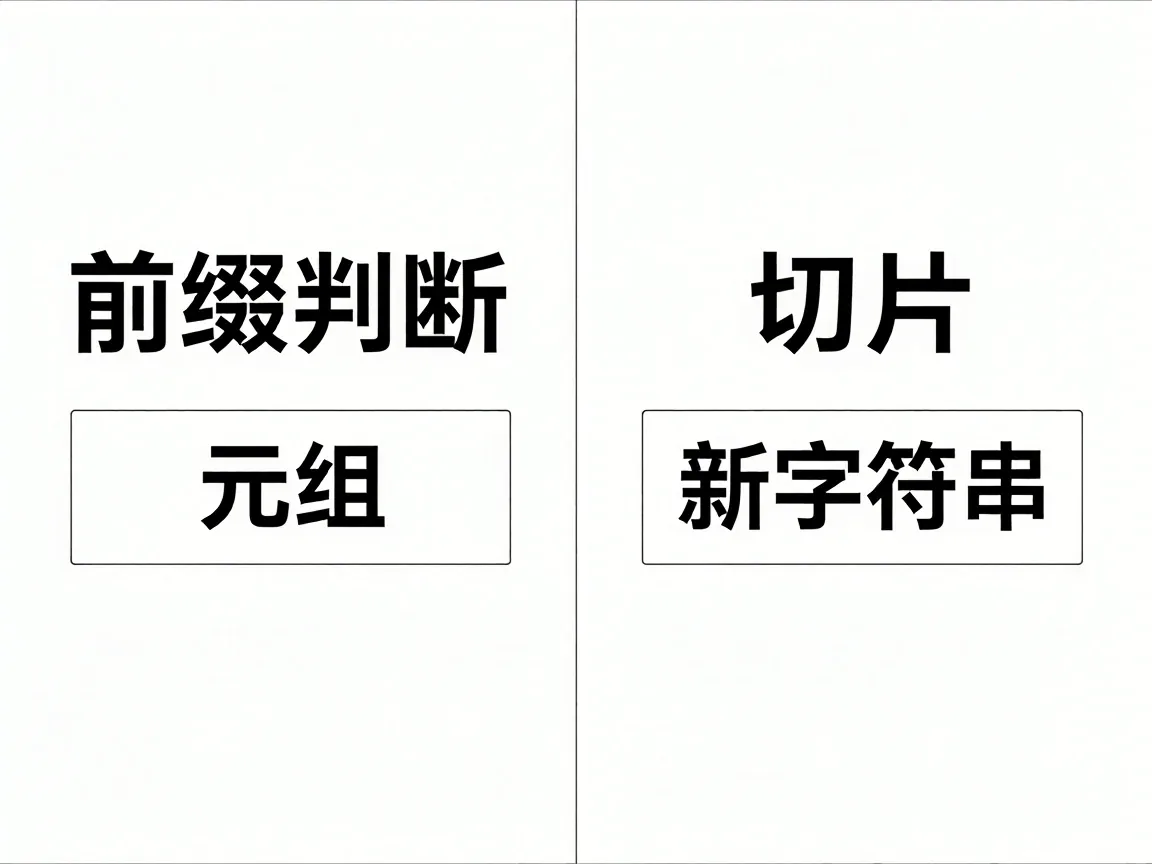
startswith 的第一个参数可以是字符串,也可以是元组,"a.log".startswith(("a", "b")) 得 True,命中任意一个就够。传列表不行,报 TypeError: startswith first arg must be str or a tuple of str, not list。
它还有 start 和 end 两个位置参数,语义跟切片一致,"abc".startswith("b", 1) 得 True。endswith 形状一样,判扩展名时传元组比连着写 or 干净,name.endswith((".py", ".pyc"))。
用切片 s[:4] == "http" 也能判。切片不用记参数,花销是每次都新建一个短字符串,循环几十万行时这层分配白费;好处是能直接拿到前缀本身。单次判断两种写法都行,批量过滤日志行时用 startswith,省掉中间对象。
回到那几个脚本。最老的一个第一版用 index 取时间戳,日志格式加了一个字段之后,某些行的位置对不上,ValueError 把整批解析打断,那天采集的数据重跑了一遍。现在的写法是先 find,返回 -1 就跳过该行并计数,跑完看计数不为零再去查格式。每行多一次比较,坏行就不会把整批带走。参数都能现查,返回值类型得先记在脑子里。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- Html中转义字符是什么?Html常用的转义字符大全 2022-11-08
- PHP array_merge_recursive() 和 array_replace() 详解:数组合并与替换 2026-07-02
- robots文件存在限制指令,Disallow写错会挡掉全站 2026-11-11
- jquery判断元素是否显示怎么做?两种取法对照 2026-11-16
- wordpress的robots.txt在哪儿?wordpress修改robots文件的方法 2022-09-22
- robots协议怎么读?allow与disallow取舍 2026-11-20