
rag知识库构建步骤怎么排?5步从切分走到召回上线
- 2026年11月14日
- 39 次
检索增强生成的知识库,做的是把文档切成块、编码成向量、存进索引,提问时先取回相关块再交给模型作答这一整套活。这套rag知识库构建步骤按链路排成五步,前后有依赖,顺序换过就得多返工。判断标准只有一条:模型给出的答案,能不能在召回的块里找到原文依据。对不上,就回链路上找断点。
第一步:切分粒度先定死,文档切分与向量化一起做
排法只有一种:切分(连同向量化)、建索引、召回、重排、上线回归。前一步的输出是后一步的输入,跳过的步最后都会在召回端暴露。
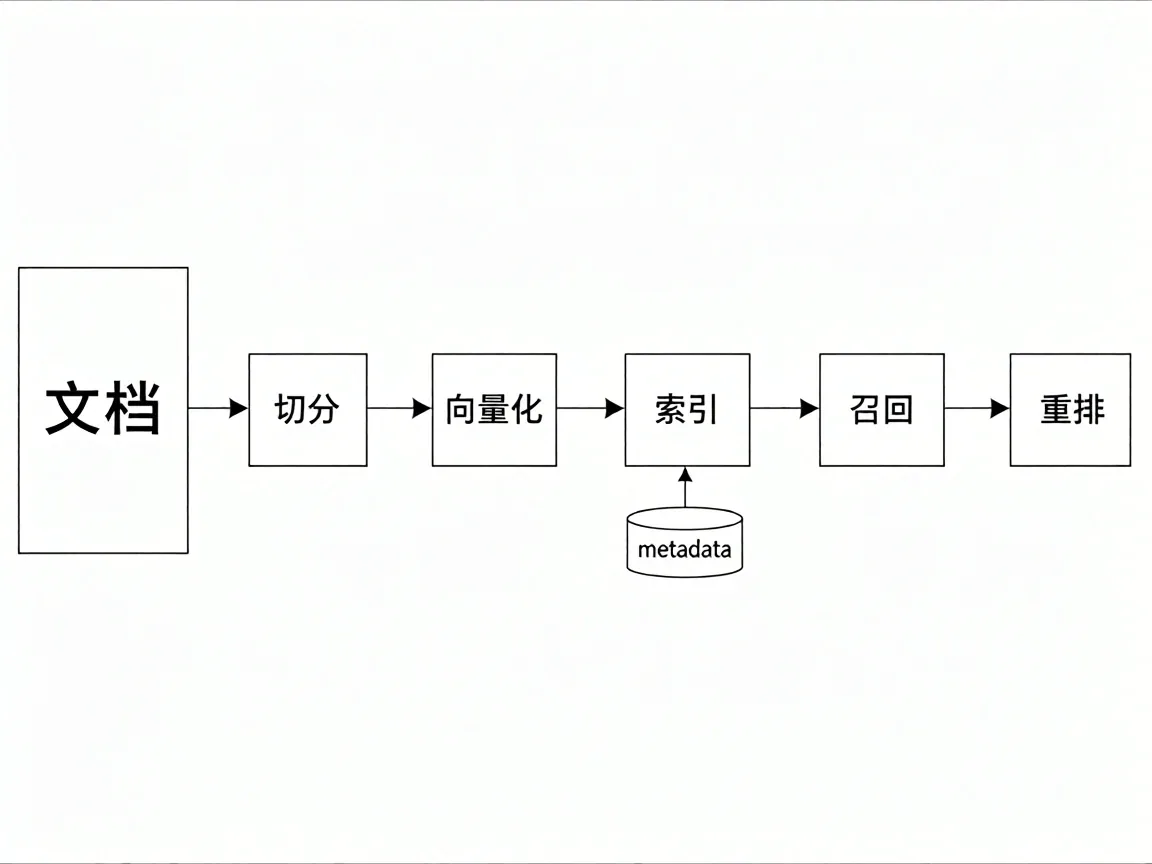
返工最多的一环不是模型,是切分;这条rag知识库构建步骤里,一半的返工都出在这儿。块太大,一块塞进三四个主题,向量被平均掉,召回时哪个都像;块太小,条件句被切断,取回来半句话,模型只能顺着猜。
我手上是 128 篇 Markdown 加 38 个 PDF 的混合库。PDF 先出问题:3 个文件抛 pypdf.errors.PdfReadError: EOF marker not found,其余解析出来页码全错位。前者的修法是 qpdf --replace-input 重写文件头,后者换成 pdftotext -layout 保版面。跑完没有任何输出,才算这批文件能进下一步。
切分参数定 chunk_size=500、overlap=80,按汉字算。500 大约是一个小节的长度,80 用来接住跨段的条件句。这组值不是标准答案,语料换了要重调,但别一上来按 1000 切。
块长定了再送嵌入模型,切一次编一次。块长一改,全库重编,这个代价得在动手前想清楚。
用下面这段跑一遍,块数和块长分布一起出来。
from pathlib import Path

def chunks(text, size=500, overlap=80):
    step = size - overlap
    return [text[i:i + size] for i in range(0, len(text), step)]

total, sizes = 0, []
for p in Path("docs").rglob("*.md"):
    for c in chunks(p.read_text(encoding="utf-8", errors="ignore")):
        total += 1
        sizes.append(len(c))
if total:
    print(total, sum(sizes) // total, max(sizes))
输出是 1743 412 500:1743 块,平均 412 字,最长正好 500 字。最长顶到 size 上限,说明没有哪一块是整篇没切就塞进去的;平均比 500 低一截,是每篇结尾那截短块拉下来的。
取回来的块总是从半句话开头,先看 overlap 是不是被设成 0;平均块长明显低于 size,说明末尾碎块多,把 overlap 调大一档再看。两个分支都用上面这段统计脚本验证,改完再看一遍最长值。
第二步:建索引,块、向量、metadata 绑在一起
一条记录至少三个字段:id、向量、metadata。id 用文件哈希加块序号,重新切分也能落回原位置;metadata 留 source、page、source_type,后面的过滤全指着它。
写入前确认一件事:同一批文档必须同一个嵌入模型。中途换模型,老向量和新向量不在一个坐标里,检索结果会变得没规律。维度和上限以官方文档为准,别照抄别人博客里的数字。
索引的组成就这几块,向量只是其中一块。
建完先数条数。入库条数要等于切分输出的块数,1743 对不上就是 id 撞车把块覆盖了,回去改 id 里的块序号。
第三步:召回先粗排,topk 给 20
问题先进嵌入模型拿向量,再去索引取近邻。topk 定 20,因为下一步重排只留 5 条,20 给重排留出可挑的余地;topk 直接给 5,重排没有候选,等于白设。
走到这里,前两步已经定型,召回只是把结果取出来。
先撞上的问题是召回为空,一条都不返回。先查过滤条件,再查索引本身。
rows = index.query(question_vector, top_k=20,
                   filter={"source_type": "PDF"})
print(len(rows))
for r in rows[:3]:
    print(r.id, round(r.score, 3))
query 的参数名按你用的向量库改,语义就是 top_k 加 metadata 过滤。这段输出 0。库里 source_type 存的是小写 pdf,查询写了大写 PDF,过滤把 20 条全筛掉了。改成小写之后返回 20 条,第 1 条得分 0.71。
过滤排除完还是空,去对索引条数和嵌入模型版本。换过模型没重建索引,向量距离整体失真,这种情况只有重建索引一条路。
两条都过了结果还是偏,那问题不在召回,往下走。
空结果的排查就这两层,过滤和索引。两边都干净还空着,去看查询向量本身:提问被截断、或者前面被加了指令前缀,都会把向量推离原来的位置。
第四步:召回结果重排,把对的块顶到第一条
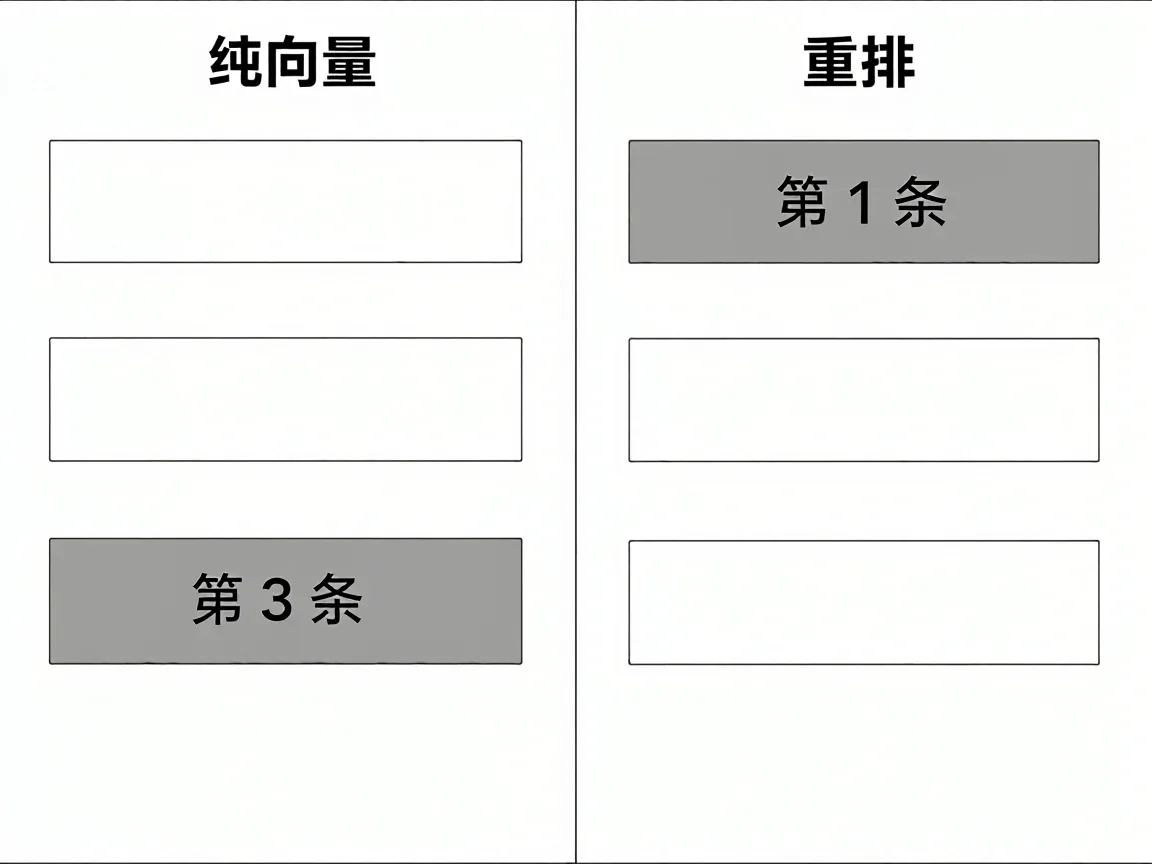
向量召回看整体语义接近,目录页、章节标题、免责声明这类块天然占便宜,纯向量的短板就在这里。重排换 cross-encoder,把问题和每个候选块成对打分,按新分数取前 5。
我那批数据里,正确答案原本在第 3 条,前两条一个是目录,一个是上一节的结尾。加上重排后它到第 1 条,前 5 条里另外 4 条也都带着答案。
重排模型只管排序,不产答案,别拿它当生成模型使,也别跨语言混用一个。
重排完还是答非所问,多半不是重排的错,是块里根本没有答案。回第一步看切分,表格和代码块被切断时最典型。
第五步:上线,用 20 条问题做回归
最容易从rag知识库构建步骤里省掉的是最后一步。留一个 20 条问题的回归集,每条标好答案落在哪个文件哪一页;改切分、换模型、调 topk,都跑一遍。
判据仍然是开头那条:答案能不能在召回的 5 条块里找到依据。找不到就记为挂,别用「回答看着还行」当通过。
日志里每条回答记 retrieved_ids 和 top1_score,出问题能直接分出是召回没给还是模型没用。
grep 'top1_score' app.log | awk '{print $NF}' | sort -n | head -n 3这三行是分数最低的三条。top1_score 从 0.7 掉到 0.4,基本是索引和查询用了不同模型;分数正常但答案错,问题在切分或重排的候选范围。
今天能做的动作很小:在召回函数返回前打一行日志,把 top1 的 id 和分数写进去,拿 20 个真实问题跑一遍,数一数有几条 top1 的块里不含答案。这个数字出来,rag知识库构建步骤里哪一步欠账就清楚了。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- PHP中getimagesize()函数使用方法 getimagesize()函数有哪些内置参数? 2022-11-23
- 关键词布局区别与联系是什么?按栏目页和详情页分工 2026-11-13
- PHP中如何重命名、复制、删除文件?PHP重命名、复制、删除文件操作实例 2022-11-11
- windows11命令提示符修复电脑怎么用?四步排查顺序 2026-11-16
- 宝塔面板网站502 Bad Gateway报错的N种原因和解决方法 2026-07-02
- 后缀md是什么文件?后缀为.md的文件是啥文件 2022-12-13