
php连接mysql总超时,最后我只改了驱动里的两个参数
- 2026年11月21日
- 17 次
上周四的队列告警不是第一次响,这次连着七次重试全卡在同一条 SQL 上。监控里 php-fpm 的进程数被占满,任务表压了两千多条待处理。我把php连接mysql的那层封装翻出来,从建连接开始一段段掐表,最后只动了两个参数,业务代码一行没改。
超时发生在哪一层
判断先摆在这里:不在网络,不在 PHP 的执行时限,卡在服务端等表锁;客户端那 601 秒是驱动的读超时在兜底。
两条线对上了才敢下这个判断。脚本自己计时,new PDO 到 query 返回一共 601.4 秒,抛出来的是 SQLSTATE[HY000] [2006] MySQL server has gone away。同一时刻在库里跑 SHOW PROCESSLIST,那条连接 Command 是 Query,State 停在 Waiting for table metadata lock,Time 从 300 一路涨到 601。
第一步是把耗时拆成两段:new PDO 之前一个 microtime(true),execute 返回后一个,中间的空档单独再记一条。三次采样里连接段都是 0.01 秒量级,601 秒全落在 query 那一段,网络慢这条先排掉了。
表锁不是谁 SELECT 出来的,是一个跑批事务改完数据没提交,MDL 一直攥在手里。后面的查询、DDL 全排在它后面。
日志里那七条报错时间戳彼此相差十分钟,这个间隔本身就是线索——它正好等于配置里的读超时,跟 SQL 本身的执行计划没关系。封装里的重试写死了七次,遇到 2006 一律重来,没分连接错还是语句错,于是同一件事被记了七遍。
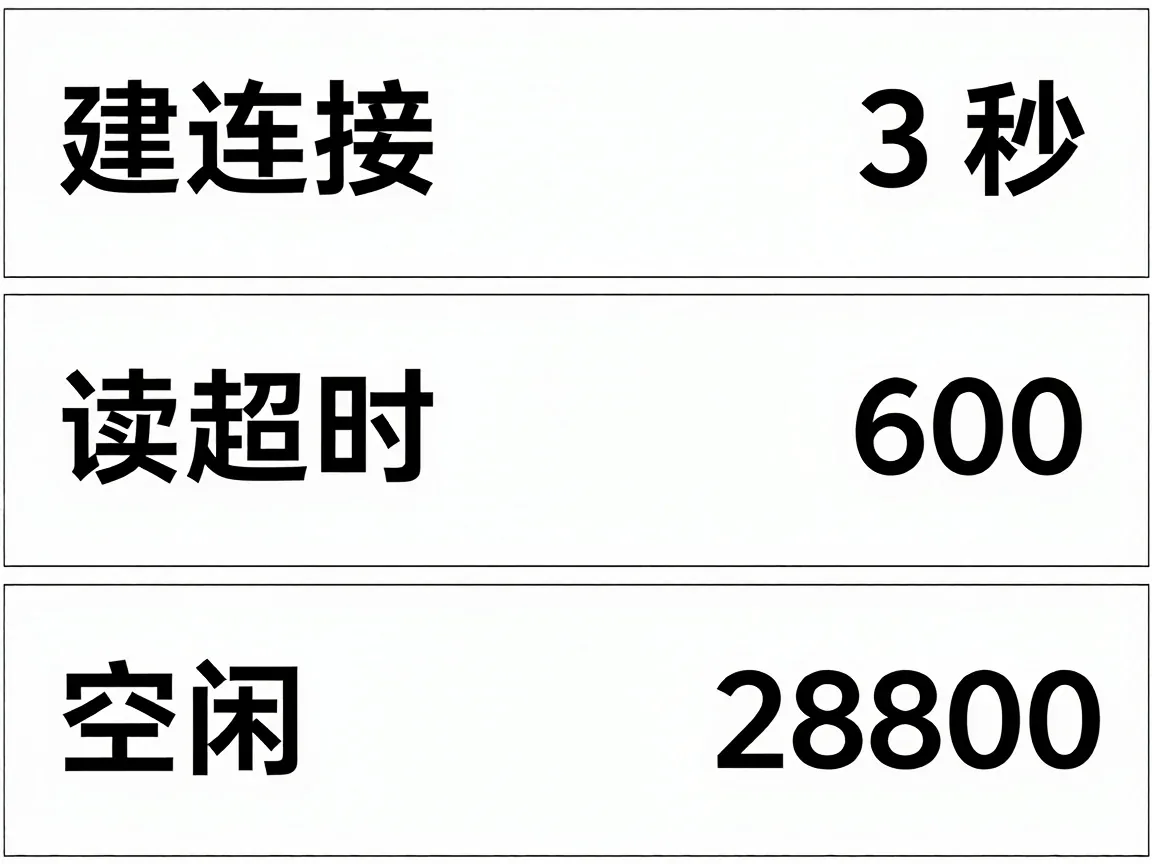
判断标准我只留一条:实测耗时减阈值,差值在 2 秒以内就是那个阈值在生效,差出几十秒说明计时点不在这层。601 减 600 剩 1 秒多,那 1 秒是收尾和异常栈的时间,先钉死读超时。另外两个数,3 和 28800,后面各对上一次。
驱动里的两个参数各管一段
第二步动两个参数。连接和读在php连接mysql时根本不在同一个配置面里设,这一点最费时间。
PDO::ATTR_TIMEOUT 只作用于 TCP 握手,管不到语句执行。把它设成 3,卡住的那条照样挂 600 秒,这也是它最常被当成万能开关的地方。压住读的是 php.ini 里的 mysqlnd.net_read_timeout,接手时被改成了 600。
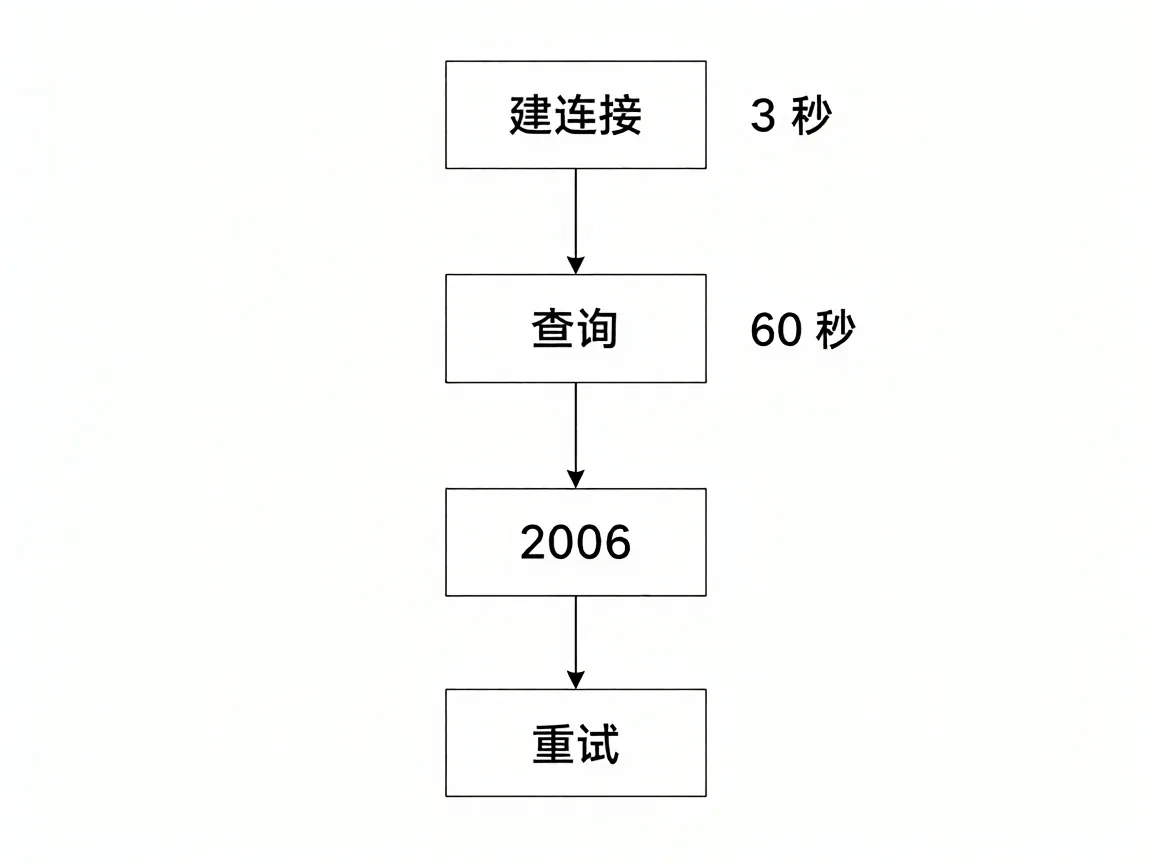
600 是被「查询太慢」这个说法误导改上去的:有人把 2006 当成慢查询的报错,把读超时放大到十分钟,于是问题从报错变成了挂住,告警也从「失败率高」变成了「进程数满」。
两处一起动:options 里给 3,ini 里给 60。60 不是拍的,最慢的一条报表 SQL 掐表 41 秒,留了不到一半余量;再压到 30,那条报表会先死。
3 秒也不是越小越好。同机房 RTT 不到 1 毫秒,3 秒是给握手留的余量;跨可用区、或者穿过公网连云上实例,握手多几个来回,这个值得按实际 RTT 往上加,不能照抄。
$pdo = new PDO($dsn, $user, $pass, [
    PDO::ATTR_TIMEOUT => 3,
    PDO::ATTR_ERRMODE  => PDO::ERRMODE_EXCEPTION,
]);
这段只管「连不上要快点报」,跟一条查询跑多久无关。拿一个被防火墙丢包的地址试,3 秒整抛 2002,不用等内核把 TCP 重传走完。
ini 里补一行 mysqlnd.net_read_timeout = 60,reload php-fpm 之后才轮到它生效。
服务端的等待上限不止一个
第三步去服务端核数。wait_timeout 是最常被提起的那个,但它只管空闲:连接 28800 秒没有语句进来,服务端主动断开,客户端下次复用这条连接才报 2006。语句执行到一半卡住,跟它无关。
卡住这类的上限在另一处。metadata lock 的等待看 lock_wait_timeout,默认 31536000,正好一年;行锁看 innodb_lock_wait_timeout,默认 50 秒。SELECT 被 MDL 挡住时,服务端既不会 50 秒放手,也不会 28800 秒放手,只能靠客户端的 60 秒先跳出来。
翻了下那天的 PROCESSLIST 快照,还有几行 Sleep,Time 停在 28700 上下——那是快到 wait_timeout 的空闲连接,跟卡住的两回事,别混在一起数。
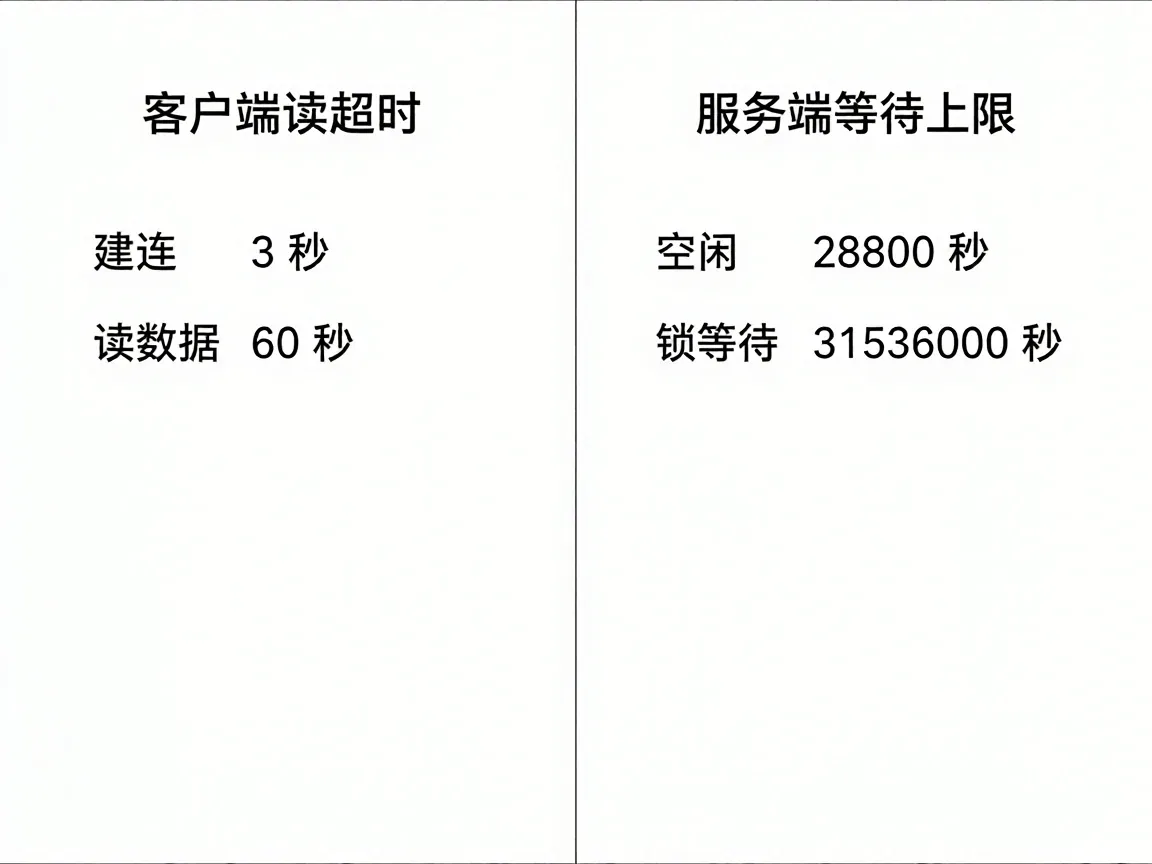
这条一次把三个值打出来。
mysql -h 127.0.0.1 -u root -p -e \
"select @@wait_timeout, @@lock_wait_timeout, @@innodb_lock_wait_timeout"主机和账号换成自己的,-p 后面不要跟密码,回车再输。输出一行三列:28800、31536000、50。哪个对不上,说明有人动过,按现值重算。
这次改的是php连接mysql的客户端,服务端这三个数只用来核对,不在这次改动范围里。
长连接把这个坑放大了一截。PDO::ATTR_PERSISTENT 打开之后,连接在 worker 里睡着,超过 wait_timeout 服务端已经单方面断开,进程还当它活着,下一次 query 直接 2006。这种报错是成批来的,跟 MDL 那种一条卡住不一样,看报错的分布就能分开。
改完重跑那一次
第四步重跑同一条 SQL,61 秒抛 2006,队列里那七次重试 7 分钟内跑完,待处理清零。SQL 没变快,变的是失败来得早。
重试次数没改,还是 7 次。601 一次的话,一条任务串起来是 70 分钟,够把 worker 全占死;换到 61 秒,7 次一共 7 分钟出头,队列才腾得出手去接新任务。
真正该修的是那个不提交的事务。改完第二周,我在 information_schema.innodb_trx 里按 trx_started 排了一遍,找到一个开了四十分钟还没提交的跑批连接。kill 掉之后 MDL 立刻释放。
2013 Lost connection to MySQL server during query 多半是服务端先动手杀的连接,2006 更像是连接已经废了还在被复用。两种报错分不清的时候,先看是谁先松的手。
调小读超时只解决「堵多久」,不解决「为什么堵」。MDL 还在,php连接mysql的等待照样会来,只是从 601 秒变成 61 秒,队列照样堵,堵得短一点而已。
三行命令对一遍
php -i | grep net_read_timeout,要看到 60 => 60 两列同值;只出现 600 说明 ini 没被读到。mysql -e "select @@lock_wait_timeout",31536000 表示没人动过;别的值以现值为准,别照抄。- 拿一个丢包的地址建连,3 秒左右抛 2002,ATTR_TIMEOUT 才算落地。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- PHP构造方法使用学习笔记 PHP构造方法实例代码 2022-12-03
- PHP数组如何修改、新增、删除操作 2022-10-22
- PHP数组去重函数array_unique()怎么用 PHP数组去重函数使用实例 2022-11-14
- PHP in_array()、array_search()、array_key_exists() 查找函数对比 2026-07-02
- PHP判断数据类型的方法有哪些?PHP如何判断数据类型? 2022-06-09
- PHP文件操作常用函数介绍 PHP文件操作常用函数实例代码 2022-11-12