
python字符串join用法是什么?join与加号的取舍
- 2026年11月20日
- 27 次
同一批数据摆两种写法:循环里 s = s + item 一路累加,十万条时明显慢一截;先把片段 append 进列表、循环结束再来一次 ''.join(parts),敲回车就有结果。把列表拼成字符串只是python字符串join用法最表面的一面,两段代码背后差的是拷贝次数。
join 接什么、返回什么
join 是字符串的方法,不是列表的。sep.join(iterable) 里 sep 是分隔符,iterable 每项都得是 str;返回值是一条新字符串,元素之间插分隔符,两头不插。空的可迭代对象给空串,只有一个元素时原样返回。
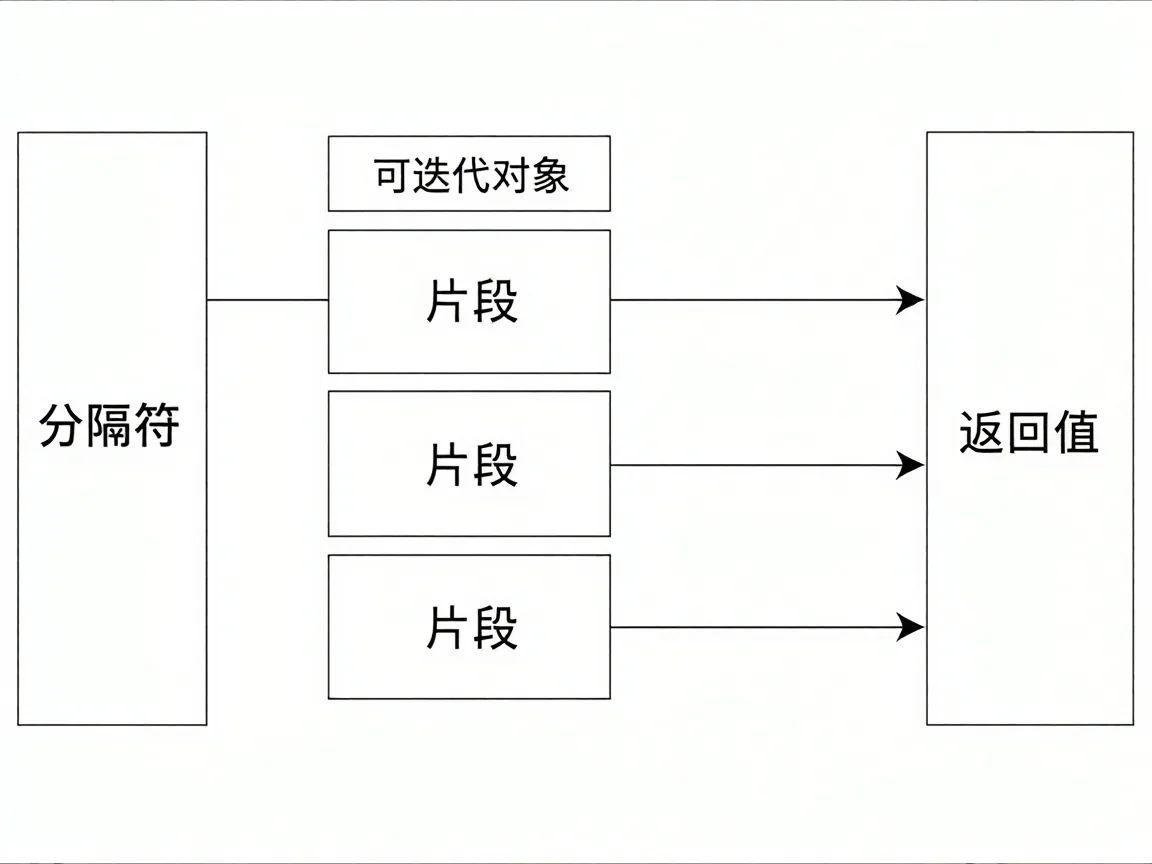
顺序和分隔符是两件事,混在一起看容易糊。
括号里不限于列表:','.join(d) 对字典取的是键,生成器也能进,join 会先把它整体取成序列再算长度。
把三种分隔符放在一起跑,末尾加一行看空列表。
parts = ['nginx', 'gunicorn', 'uvicorn']
print(''.join(parts))
print('+'.join(parts))
print(' | '.join(parts))
print(repr(''.join([])))
四行依次是 nginxgunicornuvicorn、nginx+gunicorn+uvicorn、nginx | gunicorn | uvicorn 和 ''。零宽分隔符把片段粘死,+ 那版在中间留下可数的加号,一行之差全在这里。
''.join 的输出长度等于各片段长度之和;换成分隔符 ',',长度会多出 n-1 个逗号。上面三段是 5、8、7 个字符,零宽拼出来 20,逗号拼出来 22,差的正好是两个逗号。长度这么好算,是因为 join 只有一趟拷贝:先按总长申请一次缓冲区,再把每段搬进去。
参数里只放片段,分隔符永远站在括号外面,位置写反了报的是 AttributeError,list 根本没有 join 这个方法。
第一步:join和加号,十万条时差在哪
判断只看一件事:这段代码能不能保证拼接目标只有当前作用域一个引用。
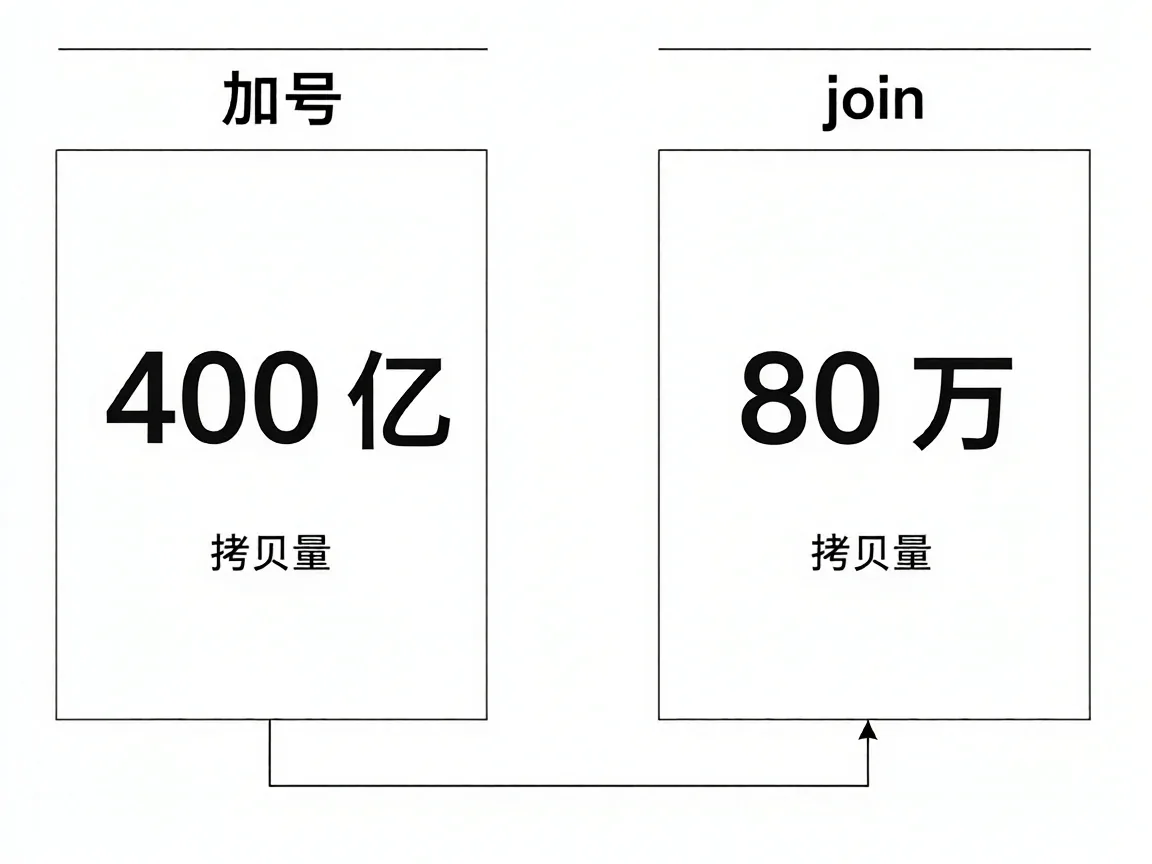
s = s + item 的账最好算。每轮都新建一条字符串,把已经拼好的部分整个复制一遍。按 8 个字符一段、十万段推,第 k 轮复制 8k 个字符,累计 8 × (1+2+…+100000),约 400 亿字符;join 走完只有 80 万字符,两边的拷贝量差 5 万倍。
s += item 别照着这个数抄。CPython 3.x 的 INPLACE_ADD 落到 Objects/unicodeobject.c 里的 PyUnicode_Append:左值是精确的 str、引用计数为 1 时,它调 PyUnicode_Resize 就地调整缓冲区,省掉新建对象那一趟。能不能真就地扩,取决于分配器,规模大了照样可能整块搬一次。所以 += 不构成线性的保证,只是把常数压下去。
判断因此落在引用上。s 一旦被塞进列表、挂成属性、当参数传给别的函数,或者被闭包捕获,引用计数就不是 1,那条路直接失效。这种位置我改成循环里 append、循环结束一次 join。
拼接目标和引用这两件事分清楚,python字符串join用法剩下的就都在边界上——分隔符、空元素、类型。
反过来,只拼两三个固定字段、整个函数只跑一次,join 要多建一个列表,+ 或 f-string 反而更短。python字符串join用法和 + 的分界就在拼接次数上,不在哪种写法更高级。
第二步:元素不是字符串时谁先报错
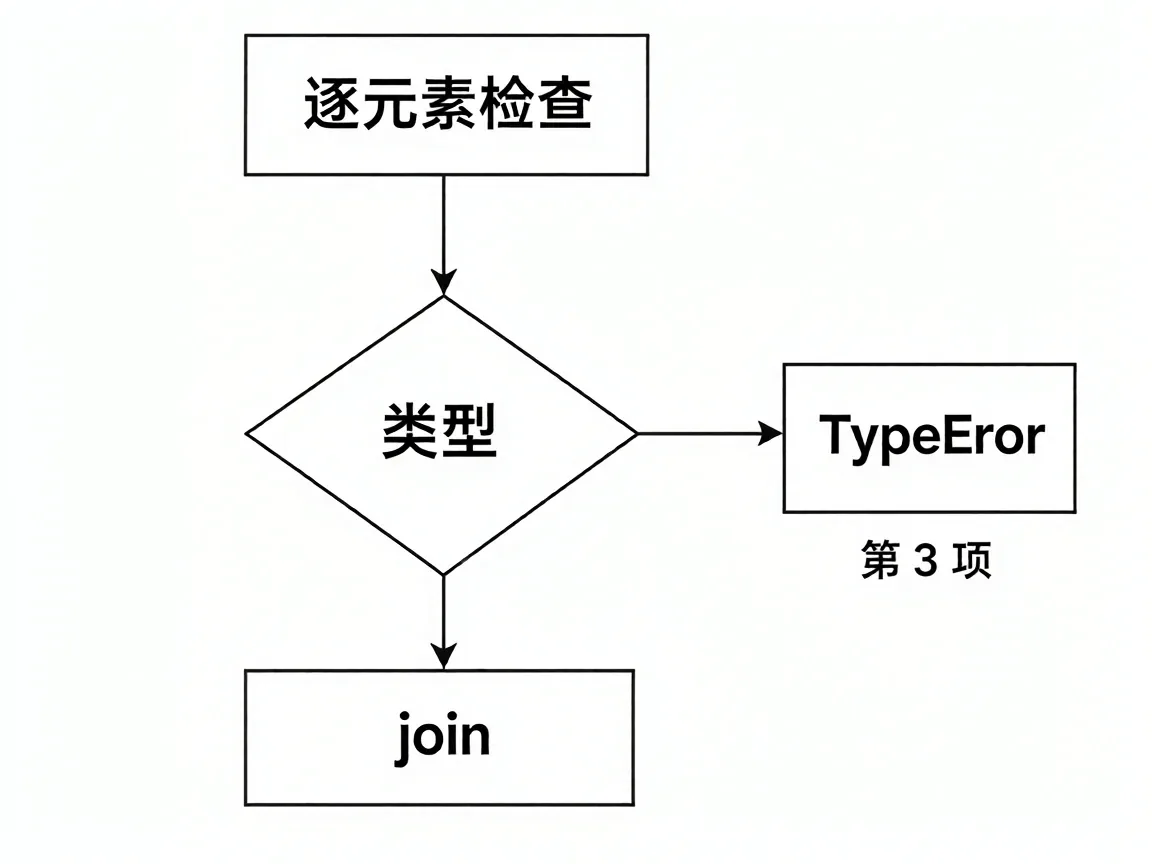
join 不收 int,也不收 bytes。混进一个数字,报错长这样。
rows = ['id=1', 'name=lee', 3]
try:
    print(','.join(rows))
except TypeError as exc:
    print(exc)
打印出来是 sequence item 2: expected str instance, int found。下标从 0 起,2 指列表第三个元素,也就是那个 3;四个元素时报的是 sequence item 3。
对比 +:'a' + 1 给的是 can only concatenate str (not "int") to str,不带位置。列表长起来以后,带下标这一句能省掉一轮二分。
修法一行,','.join(map(str, rows)) 得到 id=1,name=lee,3。map 是惰性的,join 内部会整体取一遍,不必先 list()。
f-string 和 % 不走这套规则。f'{3}' 与 '%d' % 3 都直接给 '3',它们做的是格式化,不是拼接;数字进 join 就得先自己转。读 CSV 那类混类型列的时候,map(str, ...) 比在每个字段上补 str() 稳。元素类型不对时报错带位置,python字符串join用法在这一点上比 + 好定位。
一行 type(x) is str 的打印,就能分清是 bytes 还是 int,两类报错只差 found 前面那个类型名。
第三步:分隔符写在哪,空串又算什么
分隔符写在 join 前面那一段,括号里只放片段。多字符分隔符也合法,' | '、'\n'、'--' 都能用。
一条 join 只认一个分隔符。a, b; c 这种混排在调用前就得规整成同一种边界,别指望它按位置换。
规整的办法是先切再拼。split() 不传参数时按任意长度的空白切,'a b'.split() 给 ['a', 'b'],再 ' '.join(...) 回去,多余空格就统一成一个了。
'' 是合法的分隔符,也是唯一一个让输出长度正好等于片段长度之和的取值。
空片段和空列表给出同一个结果:','.join([]) 与 ','.join(['']) 都是 '',长度都是 0。靠返回值分不出「没有数据」还是「有一条空数据」,要判断得看 len(rows)。
把空串塞进中间再算一遍:''.join(['a', '']) 是 'a',长度 1,正好等于两段长度之和;分隔符不是零宽时,结果才会多出 n-1 倍分隔符长度。
换行分隔符最常用,拼完打印一次长度和末位字符,才知道末尾到底有没有换行。
rows = ['id,name', '1,lee', '2,wang']
text = '\n'.join(rows)
print(len(text), repr(text[-1]))
输出 20 'g'。三段 7、5、6 个字符,加两个换行正好 20;末位是字母 g 而不是换行符,说明 join 不会替你在结尾补 \n,落盘那一行得自己加。它也不做 strip,片段前后带空格就原样进去,' , ' 拼出来是两个空格。
分隔符选错是最常见的错误来源:日志该拼成一行却用 '\n',或者写文件用了 ',',肉眼能看出毛病,grep 一查全是同一行。
换完之后拿三条自查对一遍
第一条,把 len(parts)、sum(map(len, parts))、len(result) 一起打出来,len(result) - sum(map(len, parts)) 应该正好等于 (len(parts) - 1) * len(sep);对不上就说明中间有元素被隐式改过长度。
第二条,在报错那一行前面插一行打印,确认每个元素 type(x) is str;bytes 混进来时报 sequence item N: expected str instance, bytes found,与 int 那条只差 found 前面那个类型名。
第三条,在脚本目录下跑 grep -nE "\+=" 你的脚本.py(文件名换成自己的),把命中的位置逐个看过去:s 是不是只在本函数里出现,只要有一处被共享出去,就换成先收集再 join。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- 五种将将.jfif后缀格式的图片转化为.jpeg、jpg格式图片的方法 2023-02-13
- react按钮跳转页面没反应?从事件绑定查到路由配置 2026-11-15
- 小破站指的是b站还是a站?小破站叫法的由来与两个站点的对照 2026-11-21
- ZblogPhp首页、列表页、文章页、tag页面调用面包屑导航代码 2022-10-11
- PHP获取PHP配置文件函数有哪些?PHP获取PHP配置文件函数怎么用? 2022-11-29
- python列表遍历怎么写?for、while、推导式三步走 2026-11-12