
python列表遍历怎么写?for、while、推导式三步走
- 2026年11月12日
- 47 次
判断python列表遍历该用哪种写法,只看两件事:循环体要不要下标、要不要自己控制指针推进。要下标就用 enumerate,要改步长或从尾部往前走就用 while,只做逐项加工就用推导式。提前退出不算理由,for 加 break 就够。三种写法快慢差得很少,区别在可读性和出错概率。选错了不会立刻报错,通常是删元素、加条件那一步才暴露出来。
第一段代码先跑通
最短的版本是这样,先确认输出对得上,再往下看细节。
nums = [3, 1, 4]
for i, n in enumerate(nums):
    print(i, n)
跑出来三行:0 3、1 1、2 4。第一个值是下标,第二个是元素本身。start 参数默认 0,要从 1 开始就写 enumerate(nums, 1)。
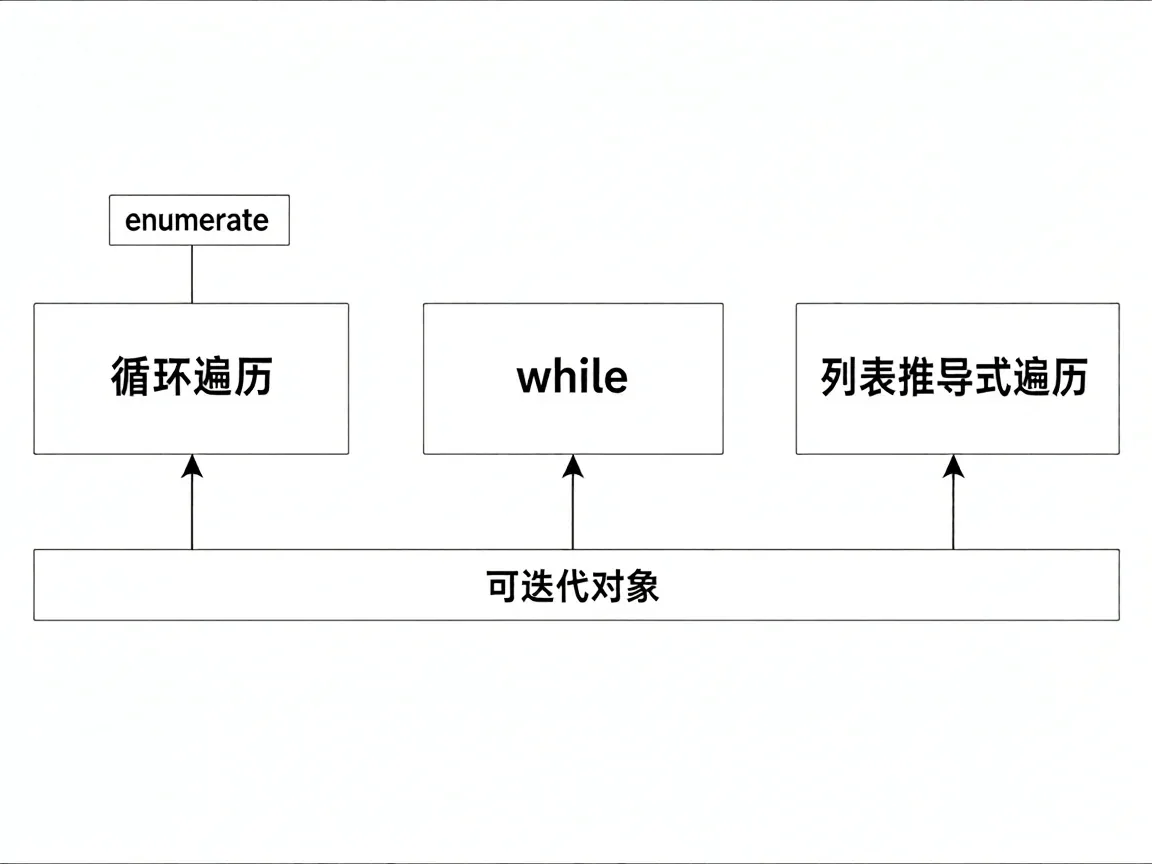
变量名别省:for idx, value in enumerate(nums) 比 for i, n in 多打几个字符,读的时候不用猜哪个是下标。i 在多数人眼里默认是下标,用在元素上要多想一步。
同一个可迭代对象,三条路进去,出来的东西不一样,python列表遍历的分岔点也就在这儿:for 给元素,while 给一个自己维护的索引,推导式给一个新列表。
for 循环遍历:要下标就交给 enumerate
只取元素、不关心位置时,for n in nums: 就够,不要写 range(len(nums)) 再 nums[i]。后者多一层索引,读代码的人得在脑子里翻译一次,能写错的地方也更多。
平时最常见的写法就是这一个。需要下标才换 enumerate,它一次给两个值,for idx, value in enumerate(nums) 比单字母好读,代价是行变长。
两个列表要并行取,用 zip 而不是按下标硬凑:for name, score in zip(names, scores)。zip 在最短的那一边耗尽时停,两边长度不等不报错,只少几轮;按下标取正好相反,短的那边会抛 IndexError。
while 更适合中途跳出
for 也能 break,所以 while 真正值钱的地方在于步长由自己定,或者要从尾部往前走。
nums = [3, 1, 4, 1, 5]
i = 0
while i < len(nums):
    if nums[i] == 4:
        print("找到", i)
        break
    i += 1
输出 找到 2。i += 1 写在循环体末尾,漏掉这一行就是死循环,只能 Ctrl+C 停。反着走写 while i >= 0,每轮 i -= 1。倒着删元素不是只有这一条路,range(len(nums) - 1, -1, -1) 更省心,后面删元素那节用的就是它。
步长也能自己定。隔一个取一个写 i += 2,同一件事用 for 得靠 nums[::2] 或 range(0, len(nums), 2),读的时候要在心里换算一次起点和终点。
break 只跳出一层。两层嵌套想一起退出,要么加标志位,要么把内层封成函数用 return。
列表推导式遍历:只加工,不产生副作用
nums = [3, 1, 4, 1, 5]
squares = [n * n for n in nums if n > 1]
print(squares)
输出 [9, 16, 25]。条件写在 for 后面,结果表达式写在 for 前面,两边位置对调会直接语法报错。
写成推导式的前提是循环体只干「取值、变换、收集」这三件事。里面有 print、写文件、改原列表、break,都不适合,硬塞进去要么报错要么没人读得懂。
两层也能压成一行,[x for row in matrix for x in row] 就是摊平。读的时候从左往右按 for 出现的顺序念,不要从右往左,顺序反了结果完全不同。
速度上做过一次 timeit,1000 个整数乘 2,推导式 18.9 微秒,for 加 append 31.2 微秒。这是本机单次观测,换机器换数据量都会漂,只能说明量级接近,别当结论引用。
遍历时改列表,结果会漏项
排查方式是先看输出对不对。nums = [1, 2, 4, 6],边遍历边删偶数,print 出来是 [1, 4],4 没被删掉。删掉 2 之后 4 前移到索引 1,而循环指针已经走到索引 2 的 6 上,于是跳过去了。
list 不报错,只是静默漏项,这类 bug 因此能活很久。
遍历中删除是python列表遍历最容易出事的地方,常见两种改法:遍历副本 for n in nums[:],或者倒序遍历 for i in range(len(nums) - 1, -1, -1)。倒着删不会让未处理的元素移位,代价是多一处 -1,容易写错边界。
用 while 加下标也能安全删,规矩只有一条:保留元素时 i += 1,删掉的那个不推进指针。逻辑三行,写反一次就是原地打转。
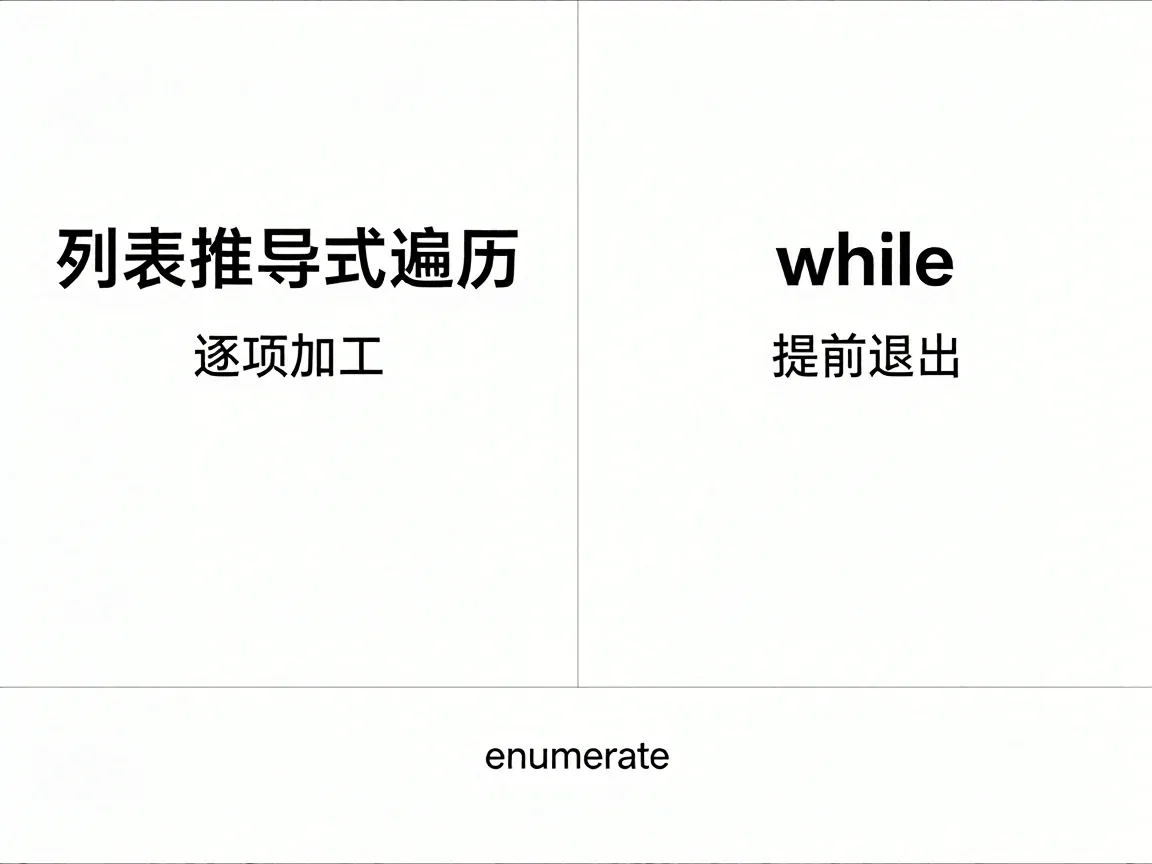
更隐蔽的是列表变短这件事。range(len(nums)) 那种写法一边删一边取下标,短到不够就抛 IndexError;for n in nums 不抛,只悄悄少跑一轮。同一个删除动作,两种错法都得见过一次才认得出来。
要保住原列表对象、又不想边删边移位,还有一招是重造:nums[:] = [n for n in nums if n % 2]。切片赋值改的是内容不是引用,别处拿着的还是同一个列表。
字典是另一回事,遍历时增删键会直接抛 RuntimeError: dictionary changed size during iteration,报错比 list 干脆。不同版本对这类检查的宽严有差别,别指望它每个版本都拦。
三种写法怎么选
清单拉开,判断依据只有循环体一件事,取舍也就这几行:
- 只读元素、不动列表 →
for n in nums - 要下标,或下标和元素一起用 → enumerate
- 要提前退出、要改步长、要从尾部走 → while
- 遍历中删除元素 → 用副本或倒序遍历
- 结果是新列表 → 推导式
- 循环体有副作用 → 退回 for,别用推导式
前五条是常规选择,最后一条是硬线。推导式里塞 print 也能跑,但下次别人读到这行,会以为它只是在造列表。
清单外还有一种:只找一个满足条件的元素。next((n for n in nums if n > 3), None) 一行就够,第二个参数管落空,不给它、找不到时会抛 StopIteration。
真正麻烦的是两个条件同时成立:既要下标又要提前退出,还得顺手收集结果。这种情况我一般拆开写——先 enumerate 找位置,跳出后再用切片造新列表,多两行,读起来省心。
多线程是python列表遍历还没定下来的部分:一个线程遍历,另一个线程在改这个列表,加锁还是先复制。现在的做法是先 list(nums) 复制一份再遍历,锁的粒度始终没试出合适的值,等有压测数据再定。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- 安装Python解释器及测试是否安装成功 2021-07-28
- python列表解包怎么用?4个场景各给一段代码 2026-11-11
- PHP array_reverse() 函数详解:数组反转的 N 种方式 2026-07-02
- 抖音账号权重报错怎么解决?从数据到违规记录的排查 2026-11-20
- 踩坑Phpcms:伪静态文章页URL地址串联及简单解决方案 2022-03-02
- Python循环中continue和break的用法和区别 2021-08-02