
宝塔nginx服务器简单禁止Python网络爬虫爬取网站
- 2021年9月16日
- 1,600 次
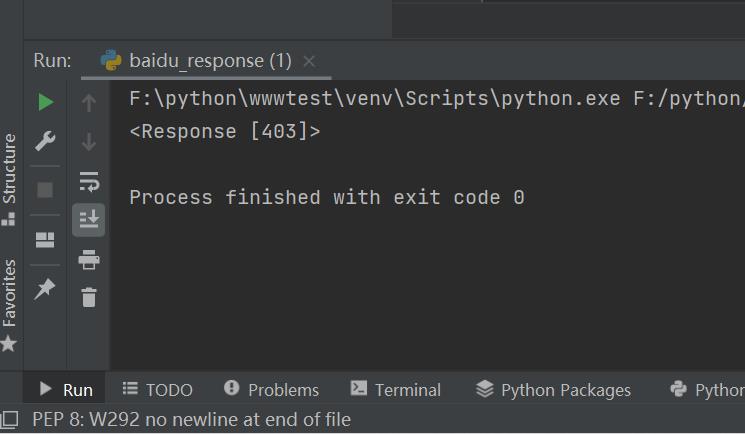
今日在学习Python网络爬虫过程中,见识到了Python爬虫的厉害,所以就拿自己网站做了一个测试,结果在未设置UA头的情况下,直接输出了网站的信息,所以就对服务器做了简单设置,使宝塔nginx服务器简单禁止Python了网络爬虫请求爬取网站。
如图所示:
设置步骤如下:
宝塔控制面板——网站——设置——配置文件中添加以下代码:
if ($http_user_agent ~* "Python|Java|Wget|Scrapy|Curl|HttpClient|Bytespider|FISPIDER|YisouSpider") { return 403; }
重启服务器后,再次在Pycharm启动requests模块请求的时候,就直接显示了403禁止访问错误。这里只是简单的在服务器里禁止了Python网络爬虫爬取网站,如果添加了user_agent头之后,还是可以爬取到。后续在学习Python过程中将继续学习和研究如何防范伪装的UA头爬虫。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- mysql连接报错2003是什么原因?先查端口再核监听地址 2026-11-11
- 宝塔日志切割功能在哪?宝塔日志切割功能如何使用? 2022-10-16
- PHP获取PHP配置文件函数有哪些?PHP获取PHP配置文件函数怎么用? 2022-11-29
- 抖音发布时间段流量增加,按粉丝在线时段排发布表 2026-11-14
- 腾讯云云服务器配置怎么免费升级? 2022-11-07
- mysql数据库备份与恢复选哪种?按数据量与停机窗口分两条路 2026-11-18