
百度快照怎么没有了?从robots到抓取诊断的排查顺序
- 2026年11月17日
- 39 次
抓取诊断的结果页只给了两行:抓取状态「失败」,失败原因「robots 规则限制」。同一时间 site 查询回来 19 条,站点地图里交上去的 URL 有一百多条。这两个数字挨在一起看,百度快照怎么没有了就不再是产品入口的事,是蜘蛛根本没走进来。
抓取诊断里那行失败原因怎么读
搜索结果页底部那个「百度快照」入口,截至 2026 年 11 月已经看不到,属于搜索产品自己的调整,站点这边做什么都改不回来。会让页面连同摘要一起消失的只有两种:蜘蛛进不来,或者进来了读不到正文。所以问百度快照怎么没有了,要先分清问的是哪个——入口不见了,无事可做;摘要跟着页面一起没了,才需要往下查。
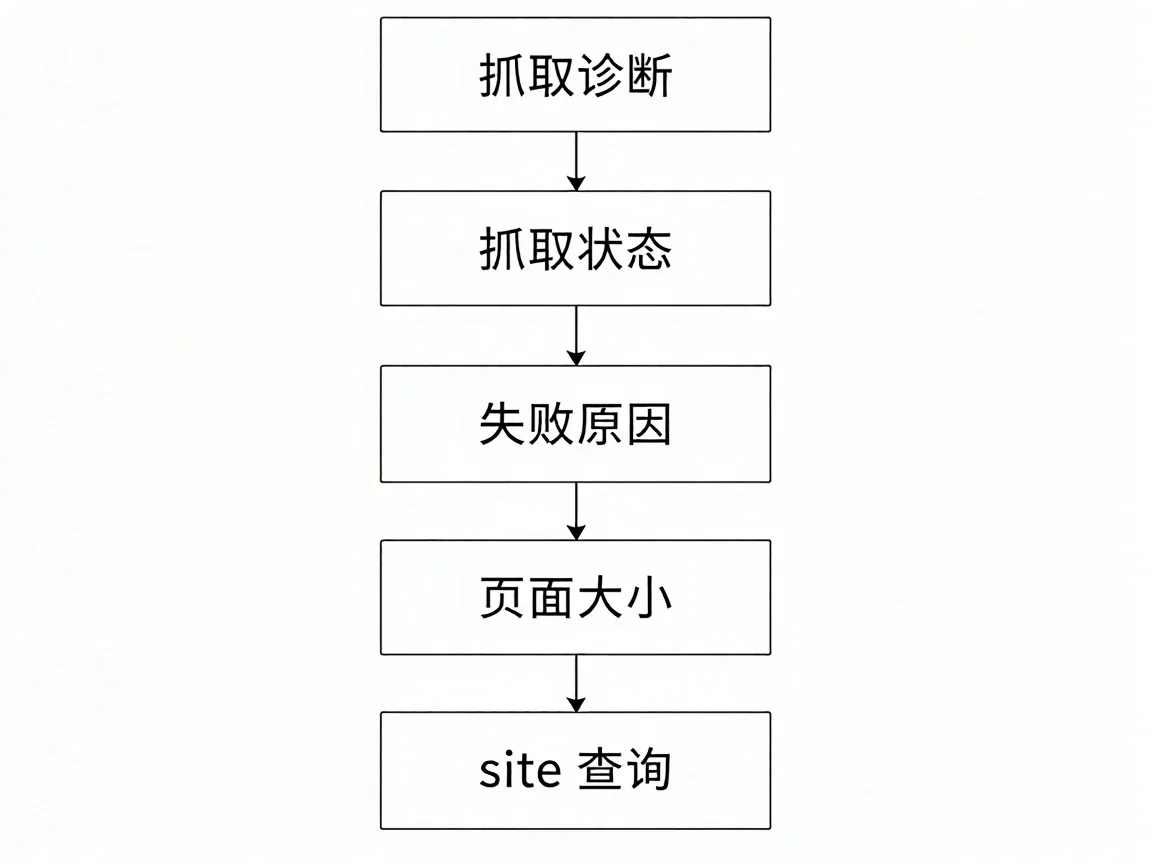
这一页值得看的字段只有三个:抓取状态、失败原因、页面大小。抓取诊断在搜索资源平台里,站点得先验证到自己账号下才看得到;状态只有「成功」「失败」两种取值,失败时下面跟一行原因,常见的是「robots 规则限制」「连接超时」「域名解析失败」;状态是失败、页面大小又是 0 B,说明蜘蛛连 HTML 的第一个字节都没拿到。
点「抓取详情」还能看到这次请求拿到的 HTTP 状态码和抓取耗时。状态码 200 配 0 B 要单独归一类:服务器确实应了,回的是空响应体——空壳页、前置 WAF 直接返回空内容、压缩链路出错,都会是这个样子,跟 robots 没关系。验证办法是用 Baiduspider 的 UA 直接取一次,比对返回 body 的长度和响应头里的 Content-Length 差多少。403 和 503 则是服务端自己拒的,方向要转到防火墙和访问频率限制上。
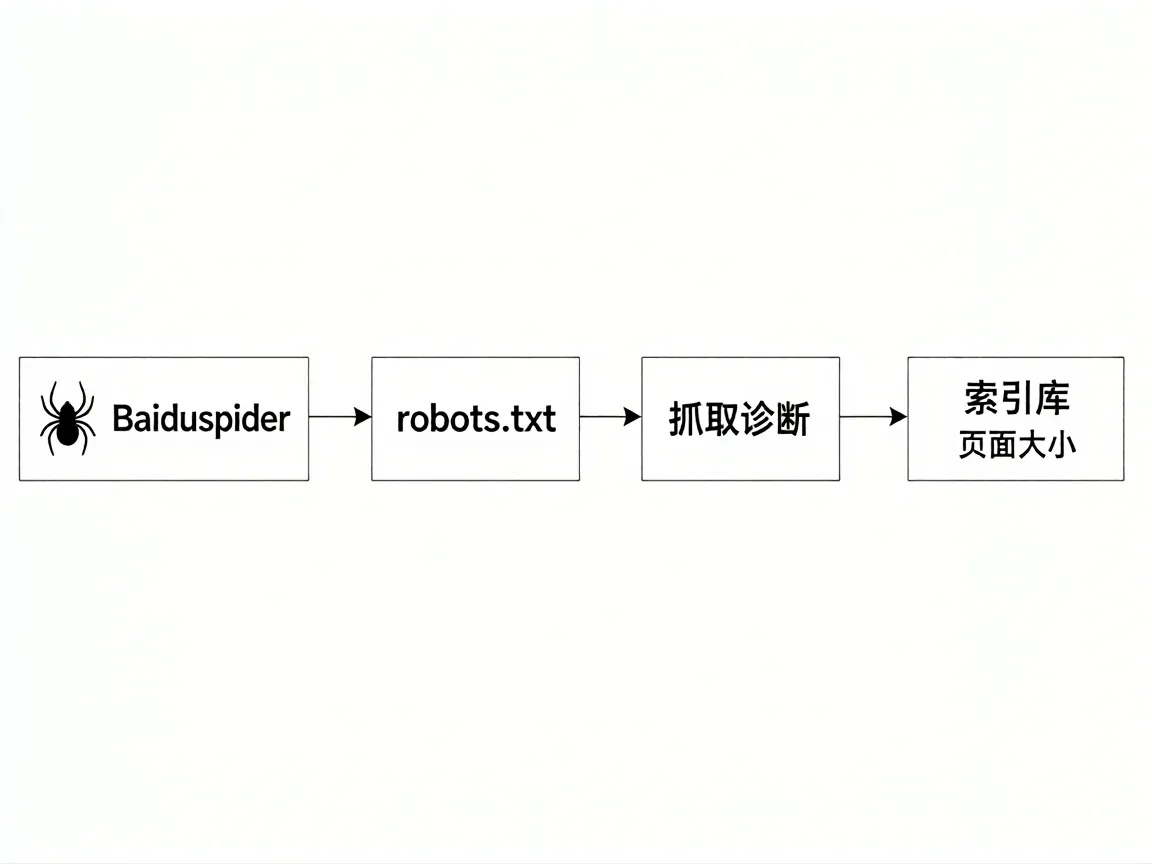
图上那条从左到右的线是检查顺序:先看蜘蛛来没来,再看规则放不放,最后看索引里有没有。抓取诊断是站长手动发起的验证工具,蜘蛛不经过它,只是排查时第一个被点开。
robots.txt 里挡住蜘蛛的是哪一行
第一步,浏览器直接打开 https://你的域名/robots.txt,屏幕上那份就是蜘蛛看到的那份,不用去服务器上找文件比对。
重点看 User-agent 分组。给 Baiduspider 单独写一组时,Disallow: / 是整站禁抓;写在 User-agent: * 下面同样对百度生效,除非前面另有一组 Baiduspider 把它放开——分组按最具体的那条算,不叠加。
拦我的是 User-agent: * 底下的 Disallow: /。当初为了挡一个测试目录加上去的,目录删了规则留着,蜘蛛从那天起就只抓 robots.txt 本身。这一层是唯一能自己动手改的地方,也是百度快照怎么没有了最常见的一类原因。
还有两处容易漏。robots.txt 必须挂在域名根目录,放子目录里不生效;返回 200 且是纯文本才算读到,返回 404 等于没有规则、全站可抓,返回 503 蜘蛛会当成暂时不可用,先搁一阵再来。
三条路线的前提和代价
能做的事只有三件,区别在前提和代价。
第一条是什么都不动,等入口回来。前提是抓取和收录本来就正常;代价是规则一直拦着的话等多久都不会变,索引只会一条条往下掉。只适合入口消失、抓取诊断显示成功的站。
第二条是只改 robots.txt,把挡路的那行删掉。前提是失败原因确实是「robots 规则限制」而不是超时;代价是要等下一轮抓取,快的一两天,慢的跟着蜘蛛的调度节奏走。拦截面小、只影响几个目录时够用。
第三条是改完再主动推一把:重新提交站点地图,挑几个关键 URL 各跑一次抓取诊断,盯着页面大小有没有从 0 B 变成正常值。前提和第二条一样,代价是多半天的验证时间,换来的是不用靠猜。整站被 Disallow: / 拦掉、一次掉几十条的,只有这条能给出确定答案。
我选第三条。规则放开只说明门开了,蜘蛛有没有进来要看那一行「抓取成功」和不为 0 的页面大小。
改完规则之后盯哪几个信号
改完当天不用守着,蜘蛛有自己的节奏。第二天重新抓同一个 URL,看三处:状态从失败翻成成功,失败原因那行消失,页面大小不再是 0 B。三个都对上,规则这关就过了。
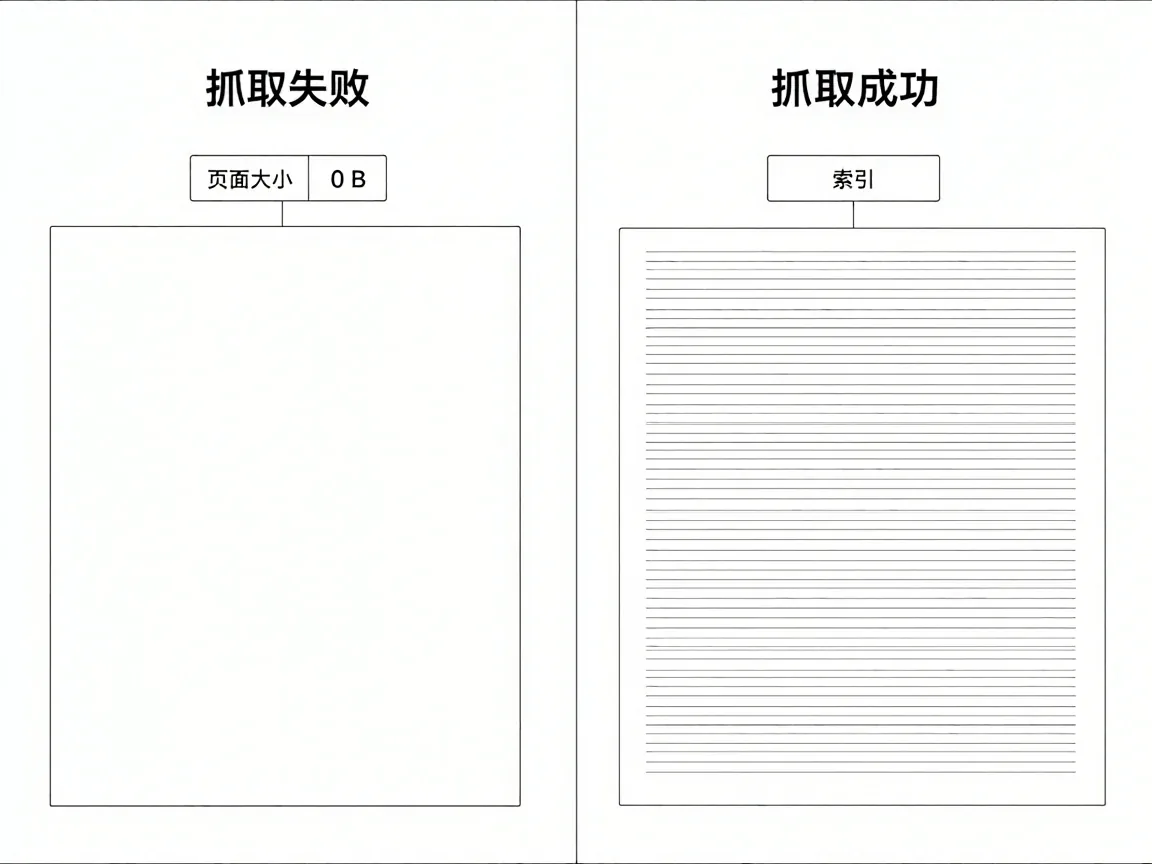
我这份是第二天下午变的,页面大小从 0 B 到 43 KB。site 查询没跟着动,隔了差不多一周才从 19 条爬到 30 多条,中间几天一直安静。
再往下看日志。按 UA 过滤 Baiduspider,改之前那几行只有 GET /robots.txt,内页一条没有,时间挤在同一天的两个小时里;改完之后同一条 UA 开始出现具体文章路径,状态码 200,返回大小和正文长度对得上。
别只盯 site 的数字。site 是抽样,条数少不代表没被收,条数多也不代表新发的进了索引;抓取诊断和日志是过程,site 是结果,过程对了结果会慢半拍。
抓取成功与抓取失败的分岔在哪
抓取诊断成功、site 查询里还是没有,这跟前一种不是一回事。蜘蛛读到了页面,但没进索引库,问题多半在内容重复、正文太薄、或者页面刚发还在观察期;抓取失败则是压根没进门,规则、DNS、超时三选一。两条路的动作正好相反:一个改页面,一个改入口。
判断标准可以压成一句:先看抓取状态。失败就是入口问题,从 robots、DNS、超时三处排;成功但正文很短,是内容问题,页面大小只是旁证。抓取失败时的 0 B 和抓取成功时的几十 KB,说的不是一回事。
把两件事混成一件,百度快照怎么没有了就容易查偏。左边是门,右边是屋里的东西,中间没有第三种情况。
再回到开头那两行:抓取状态「失败」,site 19 条。当时我把这两个数字分开看了,先去怀疑入口下线,隔了两周才点开抓取诊断,那两周里发出去的四篇一次都没被抓过。重来一次顺序会反过来:先拿状态和页面大小,再决定动不改 robots.txt,代价是多花十分钟,比空等两周划算。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- Xz域名如何转移到腾讯云?Xz域名平台将域名转移到腾讯云步骤 2023-02-09
- WordPress设置伪静态后百度仍然收录带?p链接怎么办? 2022-06-02
- robots协议怎么读?allow与disallow取舍 2026-11-20
- 网络用语legend是什么意思啊?legend什么意思中文? 2022-12-08
- html网页如何连接到css?css和html连起来的方法介绍 2022-12-02
- 怎么解析域名?从添加记录到生效验证的完整做法 2026-11-21