
Rag知识库数据权限,先从文档层切到块层再谈召回
- 2026年11月17日
- 39 次
给知识库加权限,是先检索再过滤,还是先过滤再检索?答案取决于同一份文档里有没有不一样的可见范围。整库对谁都全开时,权限写在入口就够;可同一份制度文档里既有全员条款又有部门附件,Rag知识库数据权限就必须落到文档和块两层:先定文档可见性,再谈块级召回。
文档级权限为什么不能等到召回之后再补
判断放在前面:可见性要在候选集生成之前参与筛选,块不单独持有权限,只继承所属文档的判定结果。顺序反过来,调大 k、换 embedding、加重排,都补不回来。
链路上有五个位置可以插入判断:切片、向量化、近似最近邻、取 top k、重排。后过滤只能插在第四步之后,被剔掉的槽位不会回填。调一个部门库时,日志里是 hit=30 drop=19 keep=11,剩下的 11 条有 6 条来自同一份 2025 年旧制度,而那个部门只授权了 2026 版。相邻块的语义几乎一样,过滤掉一条等于过滤掉一串,候选集就被一份不该出现的文档占满。
于是症状不是搜不到,而是搜到了却看不见,看不见的那部分正好挤掉了能看的。
例外在小库。三千块以内、用户基本能看全库,后过滤加三倍放大系数还能用,改造成本比动索引低。代价是权限每收紧一次,k 都得跟着调。
元数据过滤要压在哪一层
把Rag知识库数据权限压进索引的过滤条件里,比压进应用层的循环可靠。
每块向量旁边要带一组能直接比较的标量:doc_id、acl_group、acl_version、tenant_id。前三个决定这条块该不该出,第四个决定它在哪个库里出。查询时把用户所在的组拼成数组,和查询向量一起送进检索,向量索引内部先按标量裁掉不可见的块,再算距离。
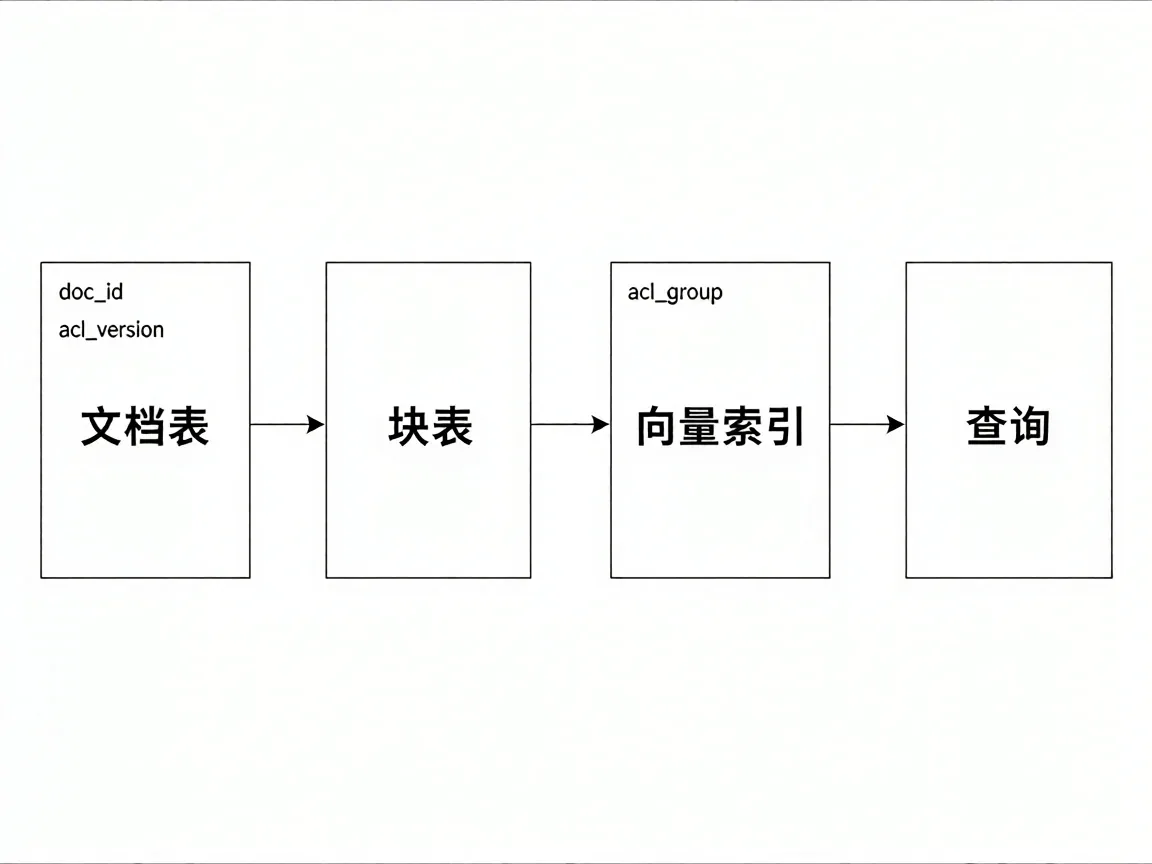
组 id 的粒度要选对。用 user id 建权限字段,八百人的部门会变成八百个 OR 条件,过滤基数比向量还大;换成部门组 id,条件只剩一个。
字段类型上出过一次错:acl_group 存成字符串 dept_a,dept_b 时只能做前缀匹配,dept_a 会命中 dept_ab,改成数组类型按元素匹配才对得上。各引擎对数组过滤的支持差别很大:Qdrant 侧看 payload 过滤能不能做 match any,元数据留在 Postgres 里就是数组列的包含与交集运算。选型前先确认支持哪一种,写法以官方文档为准。
例外是层级深的组织。一个人挂在五层部门下,展开后每块带五个组 id,写入放大约四倍。层级超过三层、组关系又每天在变,别在写入侧展开,改成查询时把用户的组集合算好传进去。
块表里该存什么,不该存什么
块表只留 doc_id 和 acl_version,权限字段不复制——这一条决定了Rag知识库数据权限能不能收紧。
早期为了少一次 join,把 acl_group 冗余到每个块上。文档改权限时只更新文档表,块上的副本没动,结果是离职两个月的账号还能搜出内部制度。翻日志看见同一条块的 acl_version 比文档表落后三个版本,过滤读的却是块上的旧值。
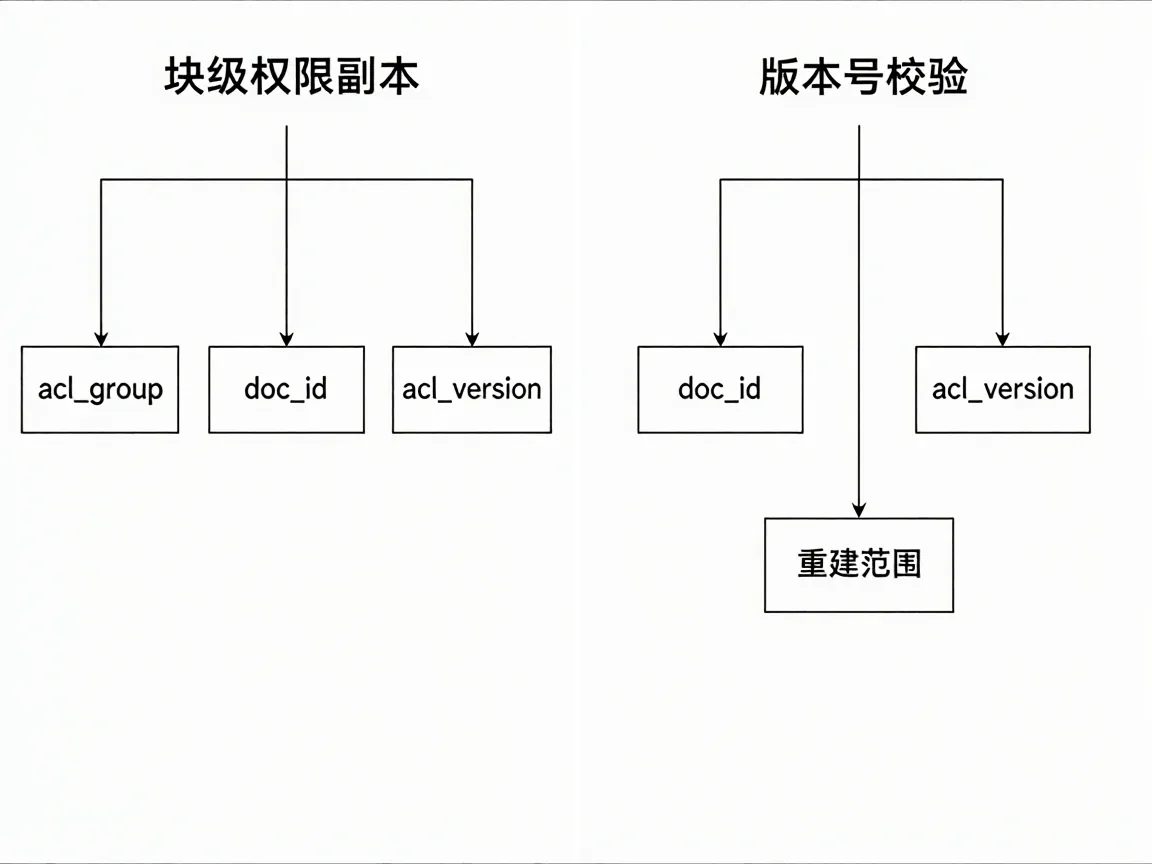
改法有两种。查询链路能访问文档表,就在检索后按 doc_id 做一次版本号校验,只留版本一致的块;访问不到,就保留块级权限副本,但把版本号写进去,权限变更按文档为单位失效,重建范围从全库缩到一份。
不复制不等于不要。检索时要用的 acl_group,在写索引那一步按 doc_id 从文档表 join 出来,只放进索引的 payload,不回写块表——上一节说的数组过滤靠的就是这一份。
真正需要块级 ACL 的场景比想象中少。同一份文档里「正文全员可见、附件只给财务」,正确做法是拆成两份文档分别授权,不是给块单独打标签。块级 ACL 一上线,切块策略、重建逻辑、审计口径全要跟着改,换来的只是省一次拆分。
例外确实有:合同库按条款授权,一份合同几十条分属不同项目组,这时块级 ACL 是刚需,权限字段得进块的主键,并且接受重建时整份文档重算。
改完之后盯哪三份样
改完不等于生效,中间隔着一轮索引同步。
顺序是:改权限,更新文档表的 acl_group,版本号加一,触发该文档的块重建,最后抽样核对。重建和核对这两步最容易漏,不少索引只更新向量不更新标量,块重建了而过滤字段还是旧值。核对方法很土:用被收回权限的账号重跑原来那条查询,看目标块还在不在前十条里。这是唯一能验证Rag知识库数据权限是否真的落地的动作。
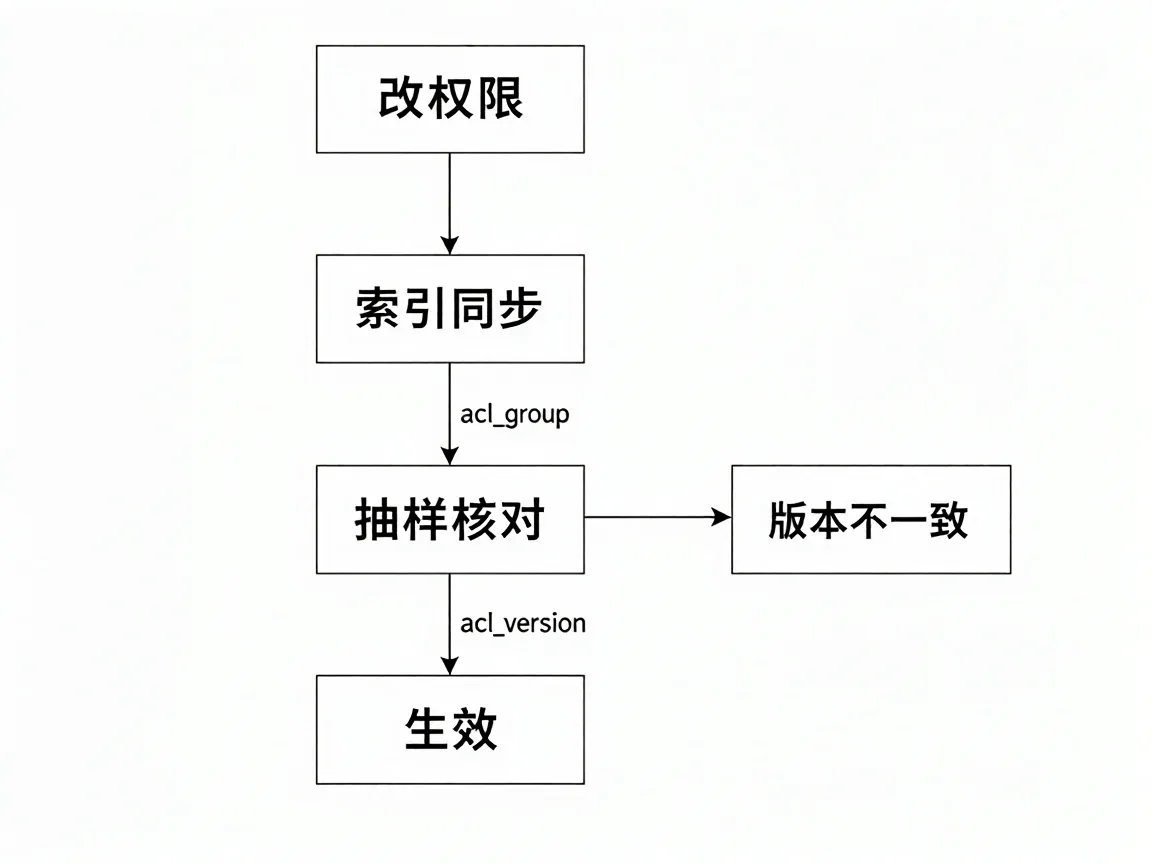
抽样别只抽改过的那份。同批次的相邻文档常被同一个批处理写进去,版本号容易一起错。一般抽三份:改过的、同目录没改的、权限最宽的那份。抽到版本不一致的那条,说明同步还没跑完,等下一轮再核。
例外是只放宽不收紧。放宽只需追加字段值,不必重建;收紧必须重建,旧值留在索引里,过滤条件写得再严也拦不住已经写进去的副本。
这套做法的代价与边界
单租户、所有登录用户看到的内容一致,这套东西就是负担:多一层过滤多一份字段维护,权限表还容易和组织架构表打架。判定只在登录时做一次就够的场景,别往下拆。
权限按小时变的场景,Rag知识库数据权限不适合压进索引。前过滤要求标量和文档表同步,同步靠批处理,延迟按分钟算;权限抖得比同步快,用户会看到刚给的权限迟迟不生效。这种场景放到网关层按请求实时判定,索引里只留租户维度。
还有前置代理已经在做行级过滤的团队。代理拦一道、检索层再拦一道,两套规则各写各的,迟早对不上。收口只能选一处:代理做细粒度判定,索引里就只留租户维度;索引做判定,代理就别再碰文档可见性。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- rag知识库常见问题出在哪?按切片到检索的顺序排查 2026-11-12
- PHP array_map() 函数详解:对数组元素统一处理 2026-07-02
- PHP array_keys() 函数详解:获取数组键名的 N 种姿势 2026-07-02
- 提示词工程常用框架是什么?四层结构与适用场景的对照 2026-11-20
- 手机投屏在哪里设置?从系统入口到第三方应用的两种路径 2026-11-15
- python列表解包怎么用?4个场景各给一段代码 2026-11-11