
硅基流动配置模型怎么填?3个参数改完就能跑通
- 2026年11月9日
- 16 次
上游 SDK 从 0.x 升到 1.x 之后,内部问答服务的请求全变成 400。代码没动,硅基流动配置模型本身也没换,错的是三个必填项的填法。代码逻辑没坏,我把最终 URL 和请求体打到日志里才看清,卡住的只有这三个值。
三个参数,改完就能发出请求
要动的就是 base_url、api_key、model 三个。base_url 填接口地址,api_key 用控制台里那串 sk 开头的字符串,model 填模型 ID 而不是页面上显示的名字。temperature、max_tokens、stream 都有默认值,不填也能返回结果,卡住的从来不是它们。真正必须给的只有这三个。
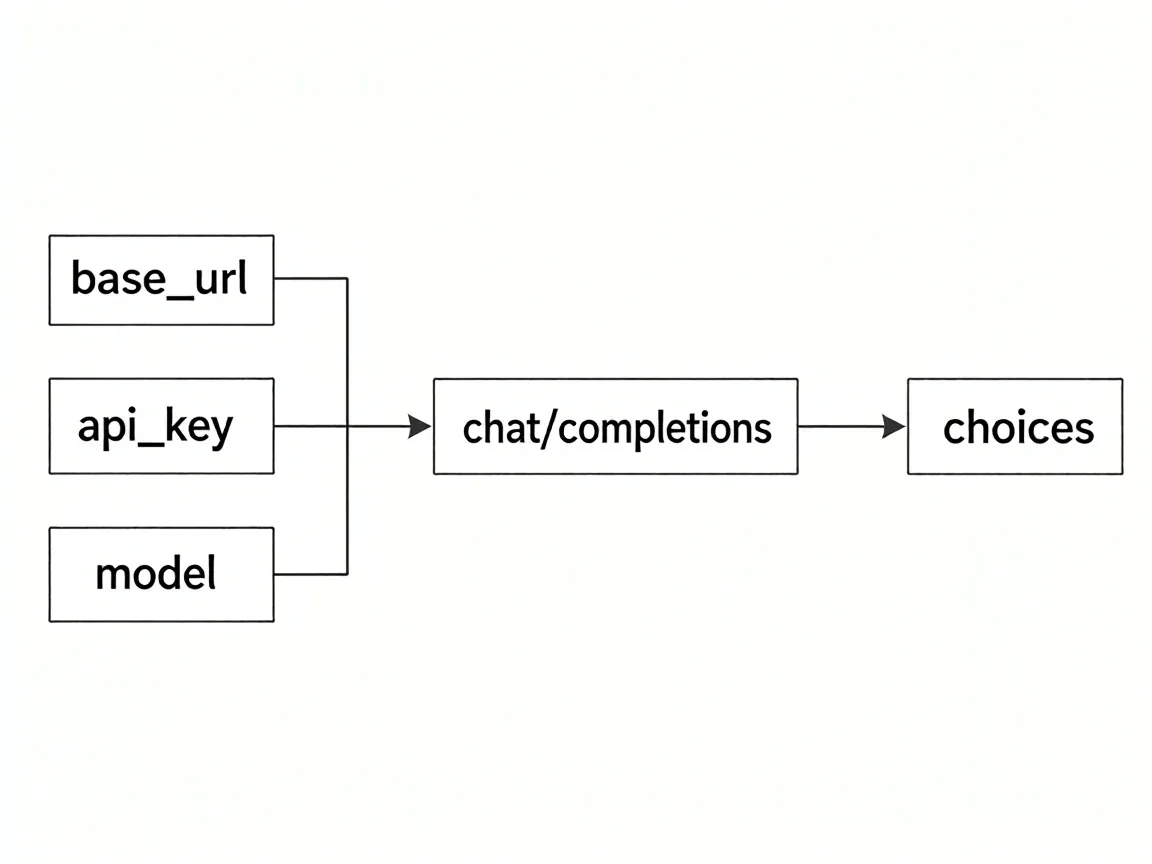
这三个值在代码里只留一份。base_url 和 api_key 作为 client 的构造参数传进去,model 每次请求时带,别的地方一律不重复写。以前把 model 写死在业务函数里,换一个型号要翻十几个文件,改漏一处就有一路请求继续打到旧模型上,日志里看不出来。
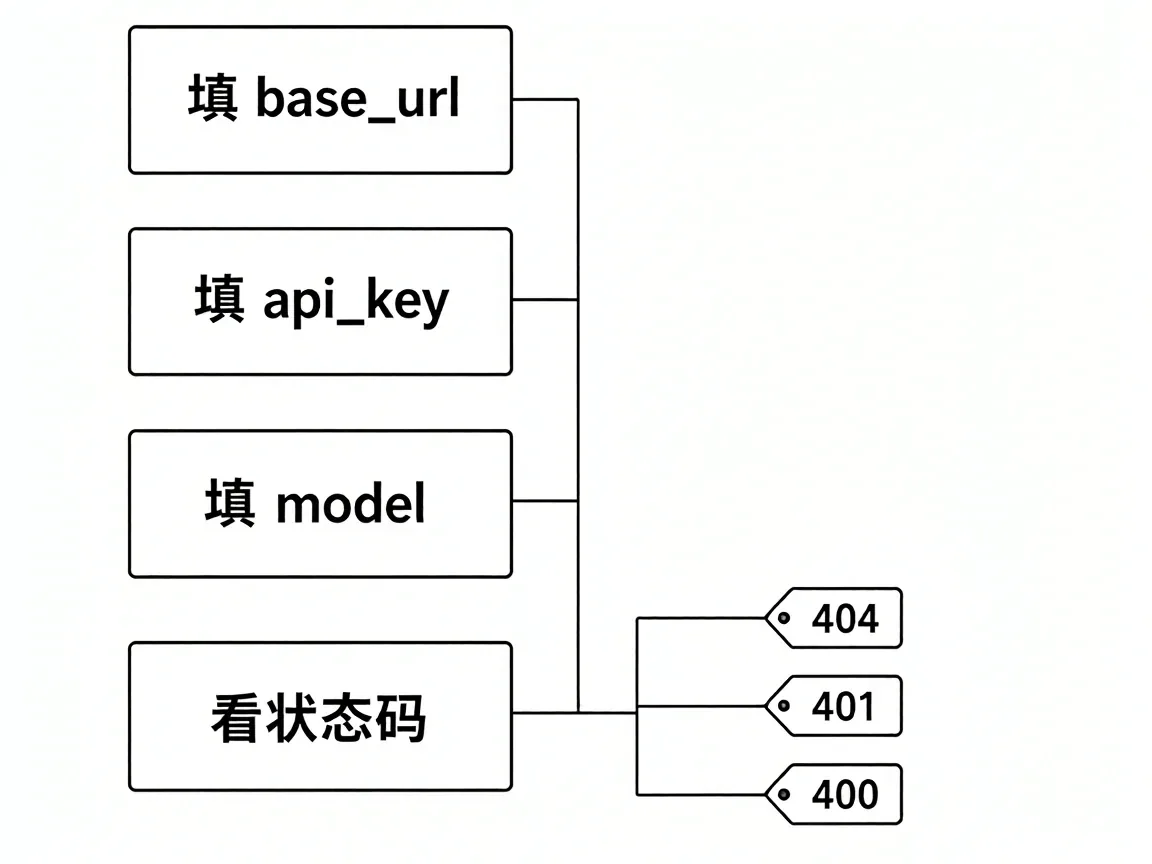
三个参数错的位置不同,回来的东西也不同。base_url 错是 404,api_key 错是 401,model 错是 400 带一句 Model does not exist。按这个对应关系倒推,比逐个换值试要快得多。
接通之前先别上 SDK。SDK 会把拼路径、加请求头这些动作藏在里面,出错时分不清是自己写错还是它拼错,一条 curl 能把这层剥掉。
export SILICONFLOW_API_KEY="sk-换成自己的"
curl -s https://api.siliconflow.cn/v1/chat/completions \
  -H "Authorization: Bearer $SILICONFLOW_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"Qwen/Qwen2.5-7B-Instruct",
       "messages":[{"role":"user","content":"ping"}]}'
正常返回里 choices[0].message.content 是模型答的话。示例里的 model 只是占位,正式跑之前换成 /models 列出来的那一个。如果拿到的是顶层 code、message、data 三个字段,说明请求根本没进模型,照着 message 去查错误码表,别急着改代码。
base_url 与 api_key:位置不对,报错信息也不对
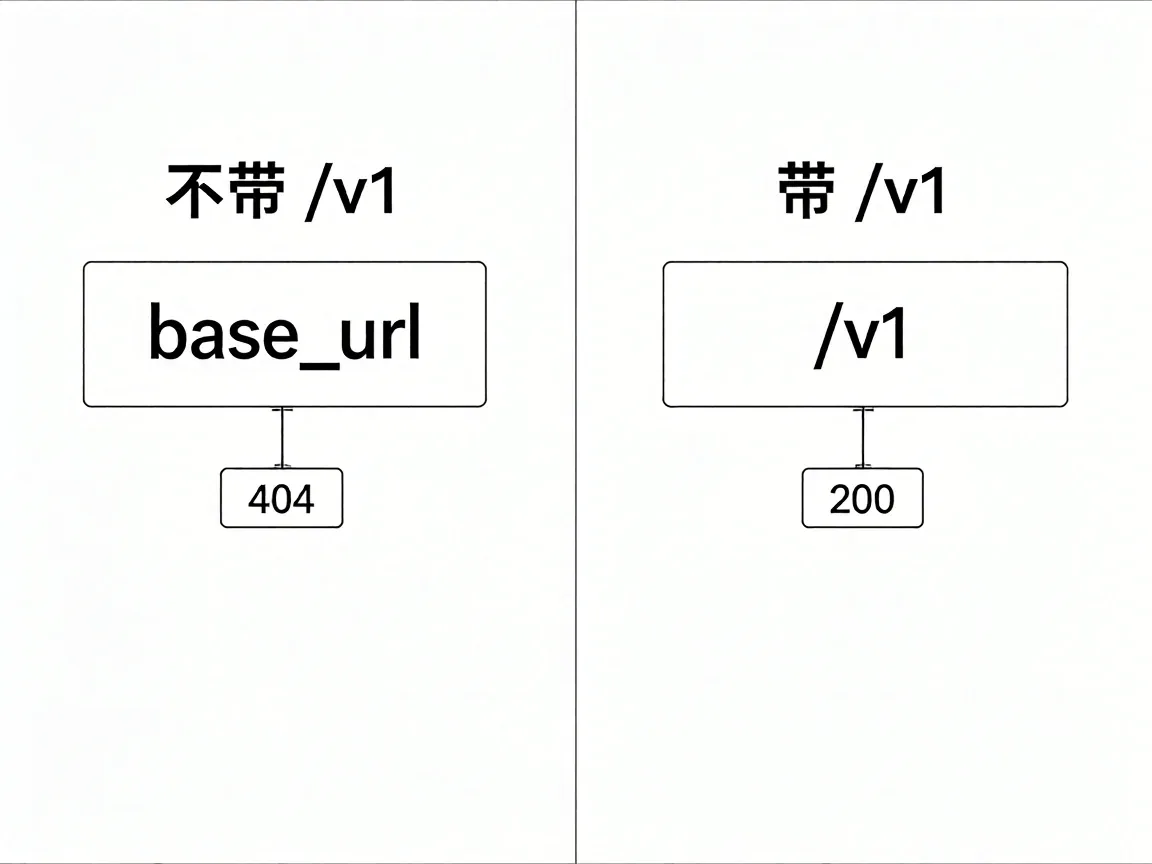
base_url 要写到 /v1 结尾,硅基流动的兼容层认的是完整路径。只写域名的时候,兼容层会把 /chat/completions 拼到根路径上,返回 404,而 404 长得又很像路径写错,容易往 key 的方向查。
末尾多一个斜杠结果一样。地址写成 /v1/ 再往后拼,会变成 /v1//chat/completions,也是 404,但响应体里 message 的措辞和少写 /v1 那次不同,这两条可以用来区分自己犯的是哪种错。
现在的写法是 base_url 写死到 /v1、末尾不带斜杠,拼路径用字符串相加,不用 urljoin。urljoin 遇到不带斜杠的 base 会把最后一段替换掉,v1 直接消失,这种错盯着代码看不出来,只有打印最终 URL 才现形。
api_key 最常见的毛病是复制时带了尾部换行。检查办法是把长度打出来,比控制台显示的字符数多 1 或 2,基本就是多了换行或者空格:
printf %s "$SILICONFLOW_API_KEY" | wc -c
一个 key 能调这个账号下所有已开通的模型,权限是账号级的。所以出现 401 时不用怀疑模型权限,问题一定在字符串本身或者请求头:Authorization 的值是 Bearer 加一个空格再加 key,少了这个空格一样是 401。
401 的 message 里只有 token 相关的字样,不会再提模型,所以看到 401 就别去动 model。
模型名称怎么选:先读 /models 的返回
模型名称是硅基流动配置模型里最容易填错的一项。控制台模型广场给的是短名,接口要的是带厂商前缀的完整 ID,两者对不上就报 Model does not exist,明明账号里能用的模型也调不动。
不确定就拉一遍列表,具体有哪些型号在架,以官方文档为准:
curl -s https://api.siliconflow.cn/v1/models \
  -H "Authorization: Bearer $SILICONFLOW_API_KEY" \
  | python -m json.tool | grep '"id"'
出来是一列 id,形如 "Qwen/Qwen2.5-7B-Instruct" 这种带斜杠的整串,连引号里的内容一起抄过去。只抄斜杠后面那半段,接口不认,报的还是同一句 Model does not exist。
同一家的型号常靠末尾的尺寸后缀区分,7B 和 32B 只差几个字符,改配置时容易只改了前半段。换完 model 立刻重发一次请求,别改完文件就当已经生效。
硅基流动配置模型的列表接口只回 id 一类的字段,看不到上下文长度和价格。选型要用的这两个数得回控制台翻模型说明,别把列表当参数表用。
跑通之后核对三行输出
把硅基流动配置模型接通,第一件事不是上业务,是看三个地方:HTTP 状态码、choices[0].finish_reason、usage 里的 token 数。
状态码 200 只说明请求被受理。finish_reason 是 stop 才算说完;是 length 说明 max_tokens 给小了,默认值在长回答上不够用;是 content_filter 说明输入被拦,跟参数没关系。
usage.prompt_tokens 比你自己估的字数大出好几倍时,多半是 system prompt 在循环里被拼了多次。这种情况请求照样返回 200,内容也对,只是账单会一天天涨上去,看日志看不出来。
三项里只有状态码是硬失败,另外两项是软信号。软信号不会报错,只让成本或者延迟慢慢变差,等发现的时候账单已经涨了一个月。
什么情况下别这么配
能跑通不代表该这么配。这套参数有前提,碰上几种环境照抄会出问题。
机器前面挂了网关或者正向代理,base_url 就别指公网域名,指内网网关地址。指公网等于让 key 在网关外面多走一跳,出问题时网关日志和调用日志对不上号。
单 key 跑到几百 QPS 会被限流,回 429。这时候申请提额或者按业务拆 key,换模型解决不了限流,换更大的模型只会更慢。
团队里已经有统一封装的 client,就别在业务代码里各写一份 base_url。几份配置对不上时,排查要花的时间比当初省下的多。
模型跑在自建推理或者私有化环境里的,这套写法整个不适用,endpoint 和鉴权都是另一套,前面三个值一个都不能照搬。能用上的只有字段名,值还是得回自己的账号里取一遍。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- ollama配置国内源怎么弄,下载慢到超时的问题终于解决 2026-11-08
- hermes接入agnes-ai API实现免费文本生成、文生图、图生图、图生视频 2026-07-20
- hermes接入agnes-ai API实现免费文本生成、文生图、图生图、图生视频 2026-07-20
- ollama配置国内源怎么弄,下载慢到超时的问题终于解决 2026-11-08
- MCP协议如何用于AI开发:工具暴露与上下文传递的实践 2026-11-07
- 两条路跑本地模型,llama.cpp和ollama区别在参数 2026-11-10