
百度收录配置怎么设置?先查robots再查sitemap
- 2026年11月9日
- 17 次
我现在的配置是两处文件加一次提交:robots.txt 只留 User-agent、Disallow、Sitemap 三类行,sitemap.xml 放根目录,最后到后台提交一次。落到手上,百度收录配置怎么设置就是这三步,顺序不能反。三步都不难,难的是状态判断——文件写得对不对,爬虫看到的是不是同一份。
顺序之所以是 robots 在前,是因为爬虫每次进站之前先取这个文件。它挡住的目录,后面在后台提交多少条地址都抓不到;它返回 5xx,抓取会停下来等站点恢复。这条也有不成立的时候:站点所有权还没验证,后台根本不给提交入口;站点前面套了 CDN,robots.txt 被边缘节点缓存着旧版本,改完要刷一遍缓存才看得到新内容。
先查 robots.txt:第一步
答案不是某个开关,是把一条链路走通:robots.txt 放行、sitemap.xml 可访问、后台提交、抓取诊断能取到页面。前面一环断了,后面的动作都不作数。
第一步只做一个动作,看服务器对这条路径回什么:
curl -I https://www.example.com/robots.txt
HTTP/1.1 200 OK
Content-Type: text/plain
-I 只取响应头,不下载正文,比整份拉下来快。返回 200 加 text/plain 是正常状态;200 加 text/html 说明这条路径被伪静态兜底到了首页,爬虫读到的其实是一段 HTML;404 会被当成没有任何规则,等于全站放行;5xx 会让抓取暂停,等站点恢复之后重试。四种情况里,只有第一种和第三种能继续往下走。
服务器上 curl 通过,不代表外面通。我一般在本机和一台外网机器各跑一次,两边结果不一样,问题就出在 CDN 或者防火墙,不在文件。
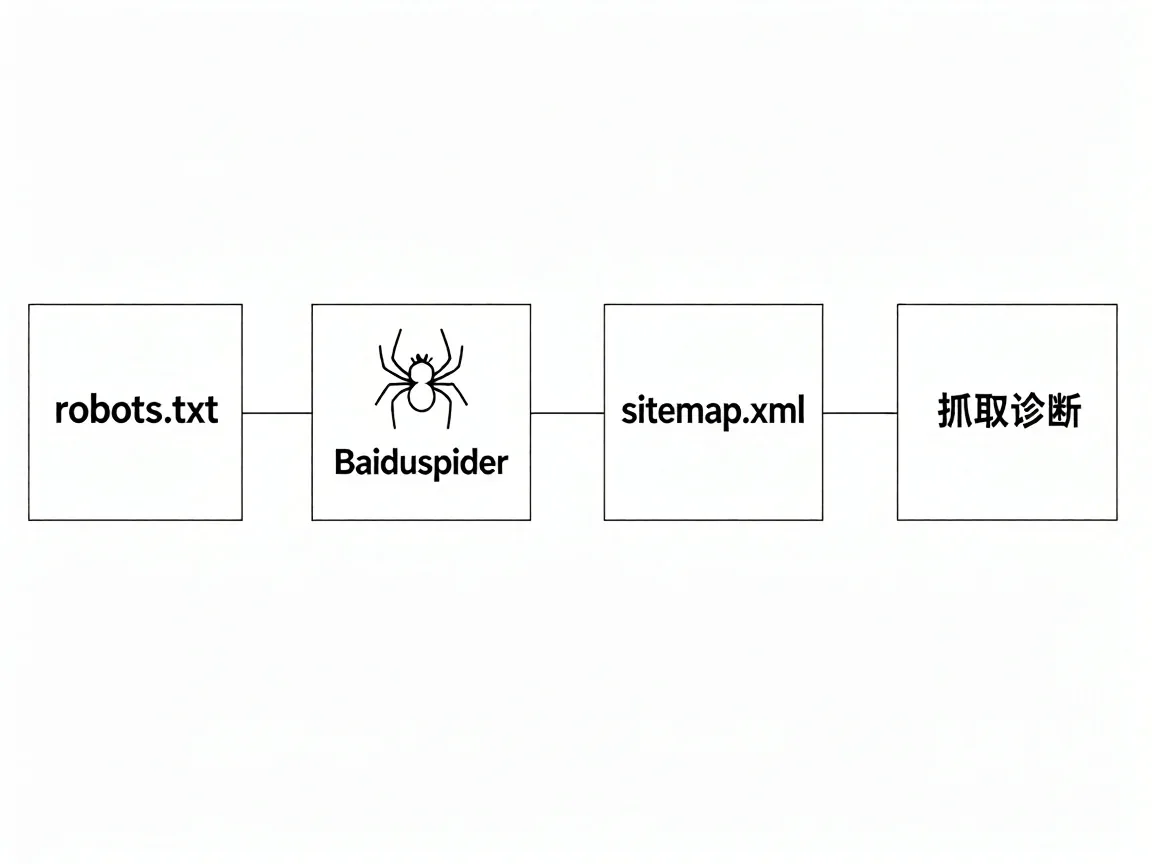
图上这条链路是四个环节:爬虫进来先取 robots.txt,再按里面的 Sitemap 行去找 sitemap.xml,最后落在后台的抓取记录上。这一环返回 5xx,或者返回 200 但内容其实是 HTML,链条就断在那里,后面查多久都查不到原因。404 是另一种情形,它等于没有规则,能往下走,只是 sitemap 那一行也跟着没了。
第二步:robots.txt 的写法
我只写三行,多一行都不加。第一行 User-agent: Baiduspider,第二行 Disallow: 后面留空,第三行 Sitemap: 加完整地址,带协议。
Disallow 留空表示全站放行。要挡后台就写 Disallow: /admin/,不要写成 Disallow: /——那是全站禁止,连 sitemap 本身都读不到。这条错见过不止一次,站点从收录几百条掉到个位数,前面一个月还在怀疑是服务器的问题。
CSS 和 JS 的目录也别挡。百度取到页面之后要渲染一遍,样式和脚本拿不到,快照里就是一堆裸文本,页面质量判断会跟着受影响。带 hash 的静态目录,用一行 Disallow: 整体放过去,比逐条列路径稳妥。
文件存成 UTF-8,别带 BOM。开头多出几个不可见字节,解析器可能整段读不下去,现象是规则明明写着却不生效。
按这个写法,规则和地图两件事都交代清楚了,百度收录配置怎么设置的前半段就完成。剩下的交给文件本身。
第三步:sitemap 提交入口
sitemap.xml 要能被匿名访问,放根目录,不要挂在需要登录的路径下。文件里是标准的 urlset,每条 url 下面一个 loc,有更新时间的补 lastmod,格式按 ISO 8601 写。这个文件读不到,百度收录配置怎么设置就只做对了一半。
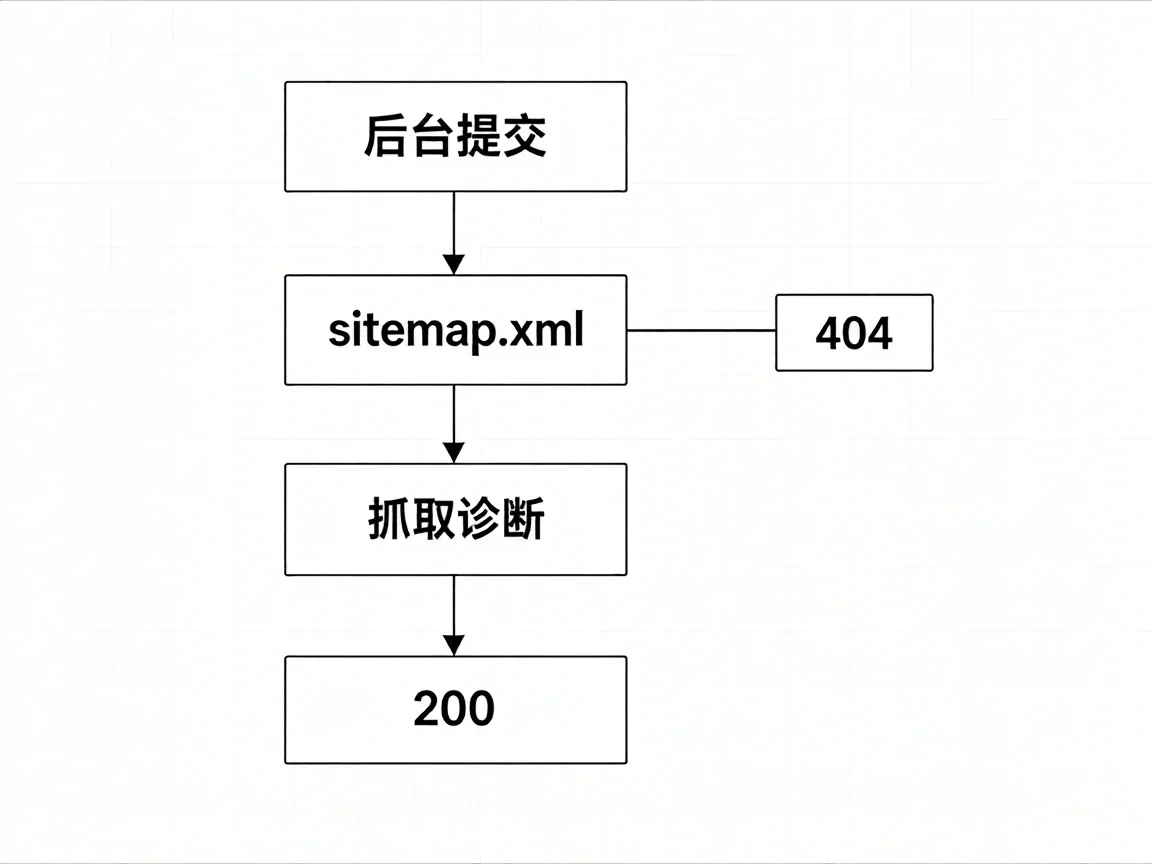
提交入口在百度搜索资源平台的资源提交菜单里,各版本后台的菜单位置会调整,具体路径以官方文档为准。填地址、提交、等状态变成已抓取,这是正常路径,一般不需要手动干预。
提交之前先自己抓一遍,这一步能省掉大半的等待:
curl -sI https://www.example.com/sitemap.xml | head -3
HTTP/1.1 200 OK
Content-Type: text/html; charset=utf-8
这是改之前的返回。状态 200,Content-Type 却是 text/html——nginx 的 try_files 把不存在的 xml 兜底给了首页,后台提交照样成功,状态一直停在等待抓取,因为爬虫每次拿到的都是一份 HTML 首页,一条 loc 都读不出来。
改法是在配置里给这个路径单独放行,别落进前端路由:location = /sitemap.xml { try_files $uri =404; }。改完再抓一次,Content-Type 变成 xml 类型才算对——text/xml 或 application/xml,看发行版自带的 mime.types 给的是哪个,还是 text/html 就是没生效。
sitemap 里只放返回 200 的页面。混进一批 404 的地址,抓取配额就浪费在无效页上,新页面反而排在后面。条数多了拆成索引文件,单份文件的大小和条数上限有明确规定,按文档给的数字来。
改错之后会看到的两种现象
robots.txt 改回来不会立刻恢复。抓取按周期走,当天看索引量没动静是正常的,百度收录配置怎么设置也不是改完就见效的事,反复改配置只会越改越乱。
把文件改回去只是一半,还要核对爬虫实际拿到的内容。差别在抓取诊断里:能取到 200,说明链路通了,剩下的只是排队;一直返回 403 或者超时,那是服务器、防火墙、CDN 在拦,跟后台填的地址没关系。我遇过一次 WAF 把人机校验开到了整站,爬虫拿到的是一段 JS 挑战页,后台显示抓取失败,日志里连 404 都没有。
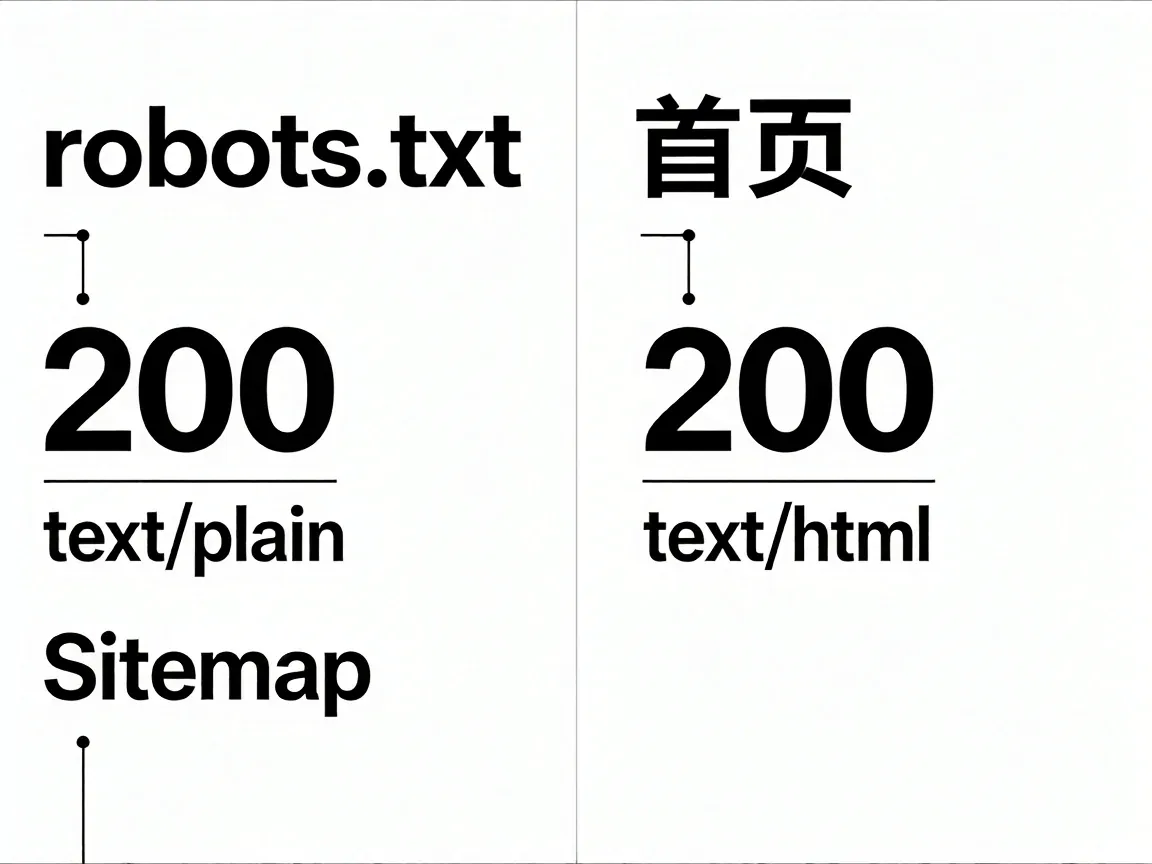
左边是正常那份:200、text/plain、文件里有一行 Sitemap。右边是出问题那次:同样是 200,Content-Type 是 text/html,内容其实是首页,一行 robots 语法都没有。只看状态码会以为配置没问题,实际什么都没生效。
三行自查
配置完不用等后台的数字,三条命令跑一遍就知道通没通:
curl -sI https://www.example.com/robots.txt | head -1
curl -s https://www.example.com/robots.txt | grep -i sitemap
curl -sI https://www.example.com/sitemap.xml | grep -i content-type
第一条看返回码是不是 200,第二条看 Sitemap 那一行在不在,第三条看 Content-Type 是不是 xml。三条都过,剩下的只是等抓取周期;有一条不对,回到对应的那一步改,别在后台反复提交。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- wordpress的robots.txt在哪儿?wordpress修改robots文件的方法 2022-09-22
- 百度收录率多少正常?三个口径下的正常区间 2026-11-10
- Css3实现网站多彩tags标签云模块 2021-05-27
- PHPCMS中Tags标签伪静态步骤:PHPCMS首页、文章页调用tags标签的方法 2022-11-13
- 网站权重一般有几个等级,新站从零到一我走了大半年 2026-11-08
- 学习前端html必须掌握要懂的英文单词 2021-01-05