
python文件的读取和写入,我按行与按块各跑了一遍
- 2026年11月13日
- 46 次
上周一个每天跑的对账脚本出了问题:退出码 0,产出文件 8.2M,wc -l 却是 0。12 万行被写成了一行,毛病不在数据,在python文件的读取和写入这一层——f.write(line.strip()) 把行尾的换行一起削掉了。修完之后把按行和按块两条路各重跑了一遍,差别比预想的更具体。
拆开看,要定的只有三个
拆开看,python文件的读取和写入要定的只有三个:按行、按块、模式。判断依据也只有一句话——记录能不能用换行切开。能切开就按行,切不开、或者单行长度不可控就按块。
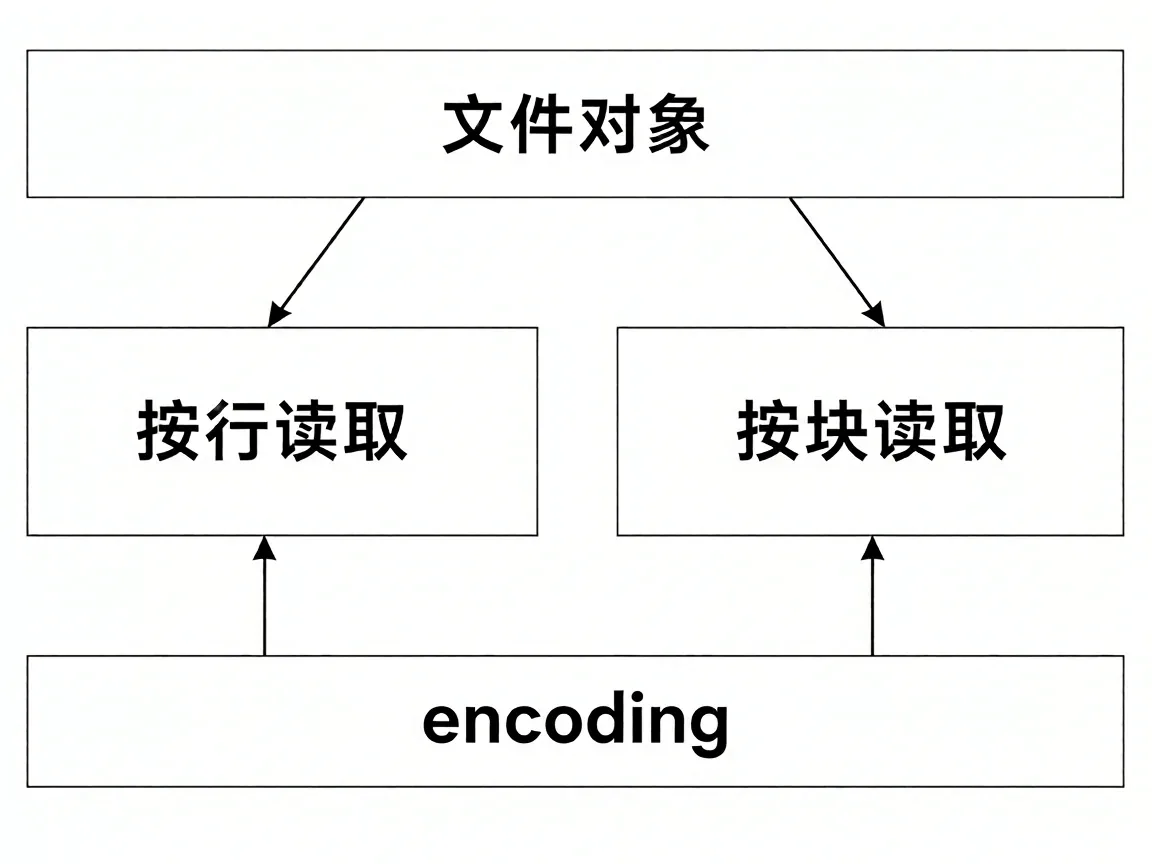
跟文件多大没有必然关系。2GB 的日志按行读,进程常驻内存也就几 MB;反过来,200MB 的 minified JSON 只有一行,readline() 要一直读到换行为止,照样把整份数据吞进内存。
三个里头先定模式,因为它决定 read(n) 的 n 到底数什么。
按行读取:迭代文件对象就够
for line in f 是最省内存的写法,文件对象自己维护缓冲区,占用跟文件总量无关。
with open(src, "r", encoding="utf-8", newline="") as fin, \
        open(dst, "w", encoding="utf-8", newline="") as fout:
    for line in fin:
        fout.write(line)
这段是原样搬运。读进来的 line 自带换行,fout.write(line) 不用补 \n;一旦先 strip() 再写,就得自己把换行补回去,补漏一次就是 8.2M 一行的场面。两端都写 newline="",是为了让读到的换行原样写出去,中途不翻译。
readlines() 少用。它返回一个 list,等于先把整个文件读进内存再按行切开,前面那个 2GB 的例子换成它,4G 的机器跑到一半就被内核收走,dmesg 里留一行 Out of memory: Killed process 22731 (python3)。
进程被 SIGKILL 杀的时候 with 的 close() 不执行,缓冲区里还没落盘的部分直接丢,输出文件就是半截。
不写 encoding 的后果更常见。这时取的是 locale.getpreferredencoding(False),Windows 中文环境下是 cp936,拿它读 UTF-8 日志,第一行就抛 UnicodeDecodeError: 'gbk' codec can't decode byte 0xe4 in position 12: illegal multibyte sequence。position 12 落在第一个汉字的首字节上,跟内容对不对无关,是解码器挑错了。
行尾还有个细节:for line in f 保留 \n,最后一行如果没有换行符就原样留着。做校验和的时候,这个差异会让两个看着一样的文件差一个字节。
去行尾用 rstrip("\r\n")。只写 rstrip("\n") 在纯 LF 文件上看不出问题,碰上 CRLF 就留下一个 \r,后面对字节的时候差一个 0d。strip() 更不能用,它连行首的空格一起削,定长字段的文本里那些空格占着列位,删掉之后整行左移,按列切就全错位。
按块读取:read(n) 的 n 不是字节
按块这一条最容易被名字骗过去,也是python文件的读取和写入里最容易切坏数据的一处。文本模式下 read(1024) 读的是 1024 个字符,一个汉字算一个,落盘字节数每次都不一样;要按固定字节切,模式必须写 "rb",此时 read(n) 才是 n 个字节。
CHUNK = 1 << 20
buf = b""
with open(src, "rb") as f, open(dst, "wb") as out:
    while chunk := f.read(CHUNK):
        buf += chunk
        *lines, buf = buf.split(b"\n")
        for line in lines:
            out.write(line + b"\n")
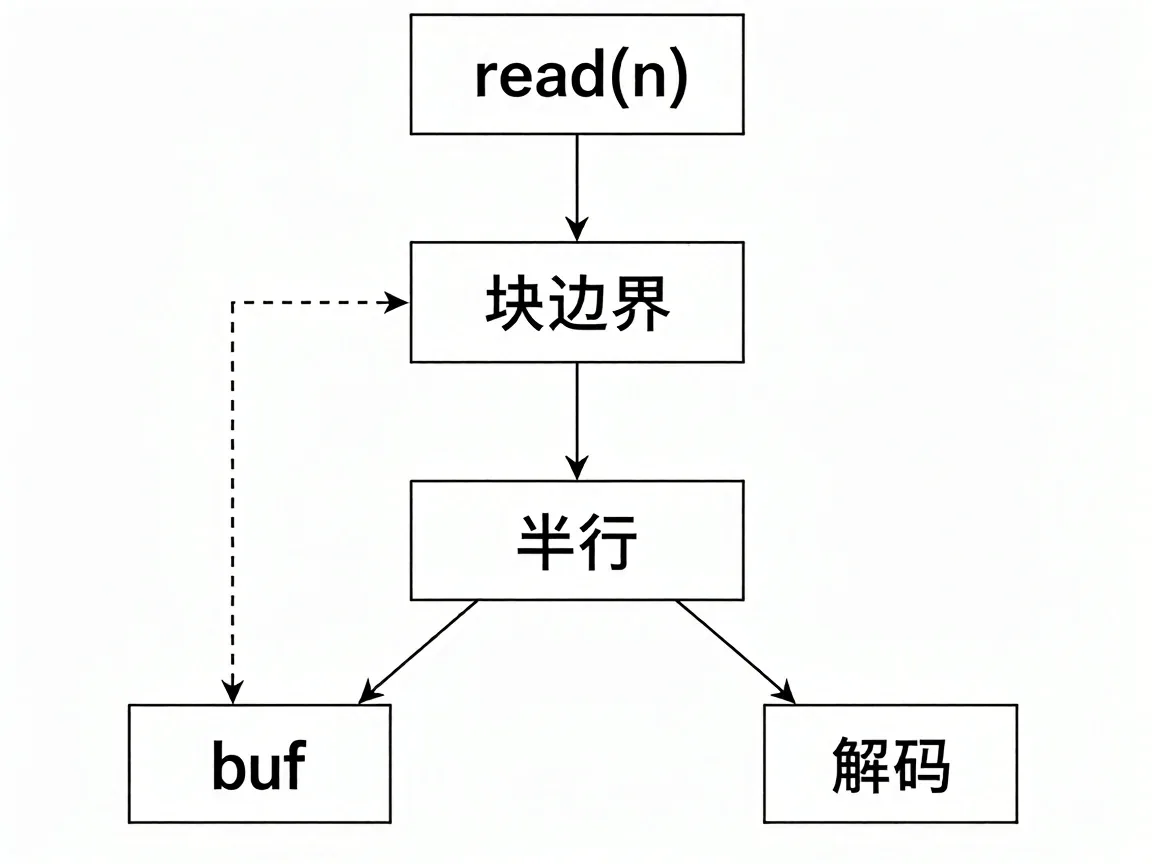
while chunk := ... 要 3.8 起。关键在 *lines, buf = ... 这一行:块边界几乎不会正好落在换行上,切完的最后一段是半行,得留在 buf 里跟下一块拼。少了这一步,日志里会出现从中间断开的记录,下游 json.loads 直接抛 JSONDecodeError。
二进制切块是python文件的读取和写入里最容易切坏字符的一处。UTF-8 汉字占三字节,1MB 的边界落在字中间时,chunk.decode("utf-8") 抛 UnicodeDecodeError: 'utf-8' codec can't decode bytes in position 1048574-1048575: unexpected end of data。要么用 io.TextIOWrapper 包一层,要么用 codecs.getincrementaldecoder("utf-8")(),后者会把不完整的尾巴留到下一次 decode。
块大小本身没那么要紧,64KB 到 1MB 之间,同一台机器上顺序读的差别落在噪声里。真正的差别在拼接方式:字符串 += 几千次之后开始变慢,攒成 list 再 b"".join 就没事。
写入端:换行和 flush
写入是另一半,这一段出问题,多数落在换行和 flush 上。"w" 截断重写,"a" 追加,"x" 目标已存在就抛 FileExistsError。
换行转换是更隐蔽的一层。文本模式下 "r" 把 \r\n 统一读成 \n,"w" 又按系统习惯把 \n 写成 \r\n。一份 LF 结尾的文件过一遍脚本,cmp 报第一处差异在第 13 个字节,正好是第一行行尾多出来的那个 0d。两端都写 newline="",或者干脆走二进制,字节才能对上。
flush 该在长循环里手动调。with 正常退出会 close() 并刷缓冲,脚本被 kill、机器掉电都走不到那一步。跑几十分钟的导出任务,每写若干行 f.flush() 一次,代价是一次系统调用。
csv 模块写文件时,open() 必须带 newline="",这条是文档写明的;漏了它,Windows 上每行之间会多出一个空行。
几个进程往同一个文件追加,"a" 在 O_APPEND 下单次 write 是原子的,但 Python 的缓冲会把几行攒成一次写出去,行不会被截成两段,先后顺序不保证。要事后对顺序,就在行首带一列时间戳。
清单:六项对一遍
六项对着看,前两条决定走哪条路,后四条决定参数。
- 一条记录严格一行、行内不会超长 →
for line in f - 单行可能几百 MB,或者数据是二进制帧 → 按块读,模式
"rb" - 要按字节偏移定位 →
"rb"加seek;文本模式的tell()返回不透明值,只能喂回seek(),不能当偏移量存 - 输出要给别的程序读 →
encoding和newline都写死,别靠系统默认 - 中途可能被 kill → 循环里定期
flush() - 要做字节级比对 → 两端都用二进制,或两端都
newline=""
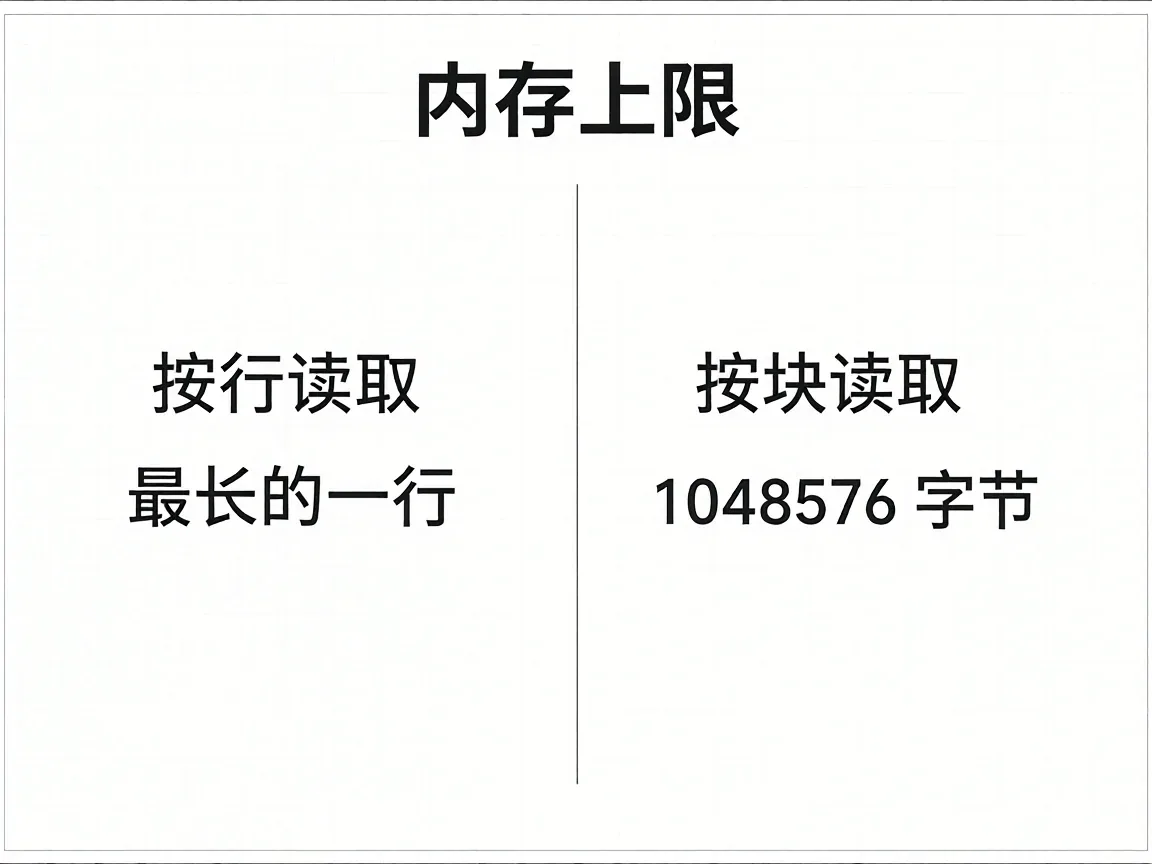
按行读的内存上限由最长的一行决定,按块读的上限就是 1 << 20(1048576 字节)再留半行的余量。
读法定错了,后面调参数都是白费。这个顺序没法倒过来。
块大小还没定
块大小这一项还悬着。同一台机器上 64KB 和 1MB 跑同一个 2GB 文件,time 出来的 real 落在同一个量级,差不出可测的东西,说明瓶颈不在这儿。等数据挪到网络盘上再按往返延迟重测,那时候 1MB 未必还合适。
另一处没定的是文本模式的 tell()。我只验证过把它原样喂回 seek() 能对上,跨版本、跨平台能不能当偏移量存下来复用,还没试。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- python安装错了怎么改?先确认pip指向的解释器路径 2026-11-19
- PHP array_reduce() 函数详解:数组归约与聚合 2026-07-02
- DeepSeek-Harness使用OpenCode Go订阅及解决接入后400错误 2026-09-30
- Eyoucms内容页百度Mip改造之JS代码改造篇 2021-05-28
- python列表的最大值最小值怎么取?三个函数加一次遍历 2026-11-10
- 宝塔nginx服务器简单禁止Python网络爬虫爬取网站 2021-09-16