
网站打开慢是什么原因造成的?按耗时查5个环节
- 2026年11月12日
- 63 次
机器 2019 年上线,2 核 4G,CentOS 7,nginx 1.18 反代 PHP-FPM,MySQL 同盘,四年只加过一次内存。首页稳定在 1.1 秒上下,文章页更久。查网站打开慢是什么原因造成的,得先把一次请求拆成五段:解析、握手、TLS、首字节、传输。这台机器五段里有四段正常,只有一段每次都在一秒钟上下。
先给结论:多数情况慢在服务端首字节
一次页面请求可以切成 DNS 解析、TCP 握手、TLS 协商、服务端首字节、内容传输五段,浏览器渲染另算。家用宽带和 4G 网络下,前三段加起来通常是几十毫秒,除非解析商不给力或者证书链不全。真正吃掉总时间一半以上的,多半是第四段——服务器吐出第一个字节花了多久,也就是 TTFB。
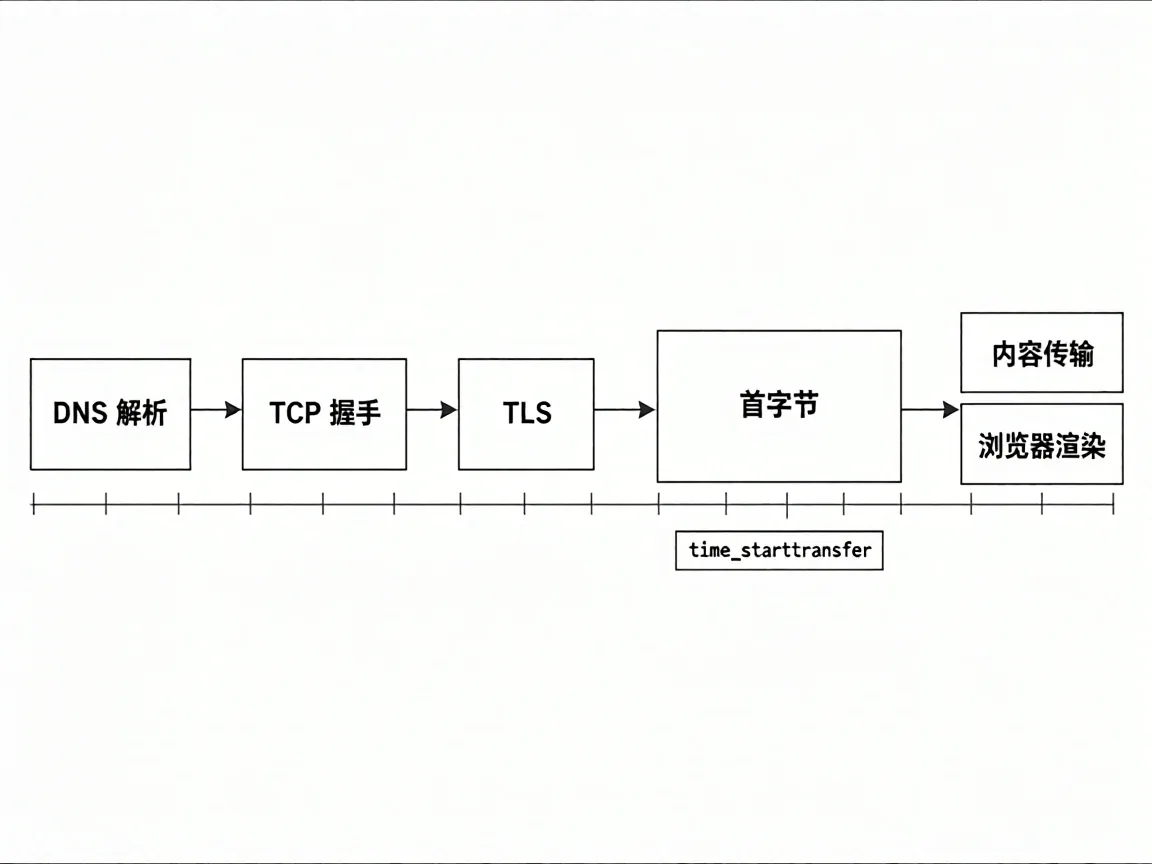
把网站打开慢是什么原因造成的归到带宽上,是这几年最常见的一次误判。带宽只决定第五段的传输速度:一个 200KB 的首页在 4Mbps 出口上大约 0.4 秒,而 TTFB 从 200 毫秒涨到 2 秒,中间没有任何一条带宽曲线会动。
所以排查顺序应该跟耗时顺序一致,从最靠前的环节往后走,遇到第一个异常值就停下来看。
用 curl 的 -w 把五段耗时打出来
本地终端跑一条 curl -w 命令,五个变量一次全拿到。time_appconnect 减 time_connect 是 TLS 的净开销,time_starttransfer 减 time_appconnect 是服务端处理时间。
curl -s -o /dev/null \
  -w 'dns=%{time_namelookup} tcp=%{time_connect}
tls=%{time_appconnect} ttfb=%{time_starttransfer}
total=%{time_total}\n' https://leetao.cc/
我这边连发三次,数值基本稳定:
dns=0.004 tcp=0.029
tls=0.098 ttfb=0.845
total=1.112
做减法:握手 25 毫秒,TLS 69 毫秒,服务端 747 毫秒,传输 267 毫秒。五段数字摆在一起,网站打开慢是什么原因造成的,通常只剩一个候选。
同一个地址多测几次,波动超过三成的那个数先别下结论,可能是本地出口在抖。
dns解析慢怎么判断
这一段只看一个数:time_namelookup。它占总时间一成以上,并且连续几次请求都这样,就不是网络抖动。同一台机器上第一次 0.18 秒、紧接着第二次 0.004 秒,差出来的 170 多毫秒就是本机 resolver 没有缓存、每次都要往上问的代价。
再往下分两种。换一台机器、换一个公共 DNS 就快了,问题在本地或运营商的递归服务器;换了还是一样,看域名的 CNAME 链。接 CDN 之后三四级 CNAME 很常见,每一级多一次查询,链越长首次解析越慢。
判断办法不复杂:dig 域名 +trace 从根域一路打下来,看哪一跳的 Query time 突然变大。TTL 也值得看一眼,设成 60 秒等于缓存几乎不起作用,每个新访客都要重新解析一次。
服务器响应慢怎么查
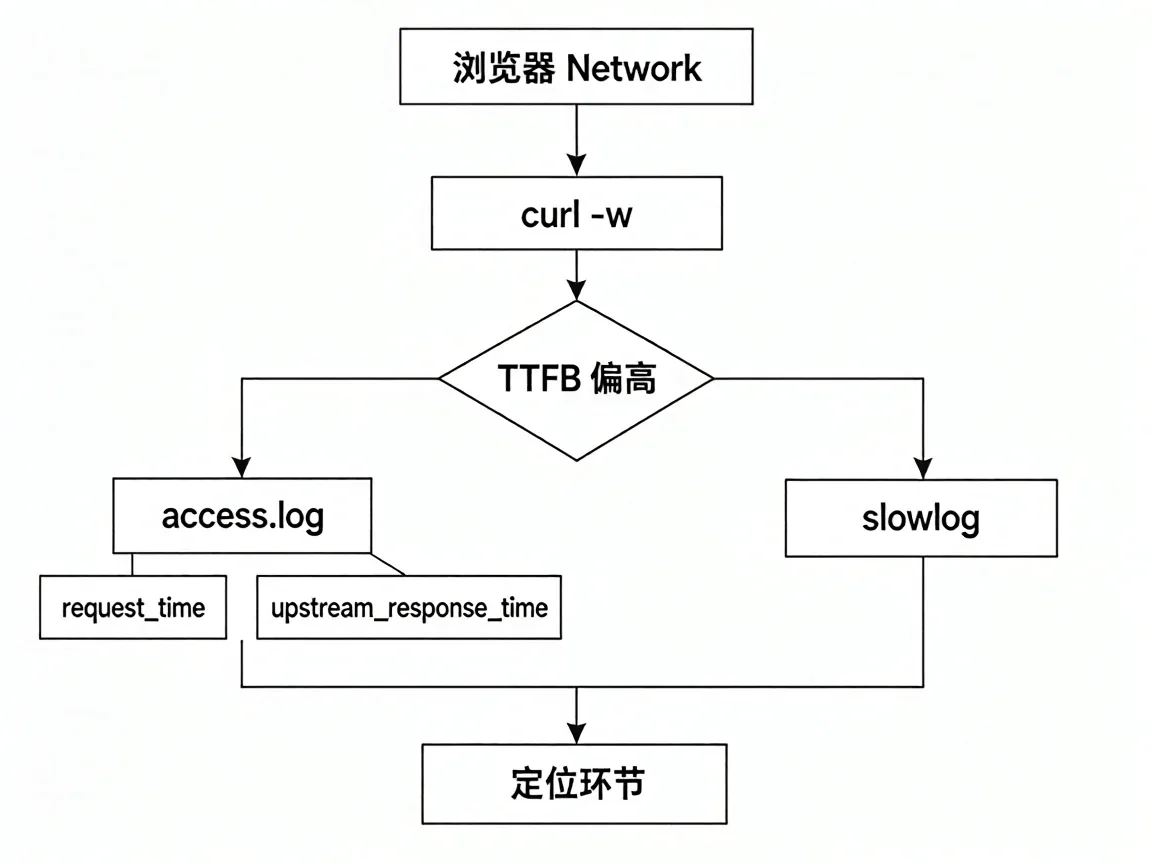
查网站打开慢是什么原因造成的,走到这一步只剩两种可能:nginx 慢,或者后端慢。默认的 access.log 里没有这两个数,要分两步:先在 http 块里定义格式,再到 server 块里把 access_log 指向这个格式,reload 之后的新请求才带上。
http {
    log_format timing '$request_time $upstream_response_time $upstream_addr';
}
server {
    access_log /var/log/nginx/access.log timing;
}
只加 log_format 不改 access_log,日志里一片空白——格式定义了没人用,是这一步最常见的漏。
两个值的差就是答案。$request_time 从收到请求算到响应发完,$upstream_response_time 是等 PHP-FPM 的时间。日志里出现 2.310 0.012 这种组合,说明 PHP 只花了 12 毫秒,两秒多耗在 nginx 往外发,通常是客户端网络差,或者响应体太大没开 gzip。这类行一多,定位环节就落在 nginx 上,不在后端。$upstream_addr 记下的是哪台后端接的活,多机部署时能把单台异常摘出来。
反过来 2.310 2.290 才是后端的事。往 PHP 走:打开 request_slowlog_timeout,慢请求的调用栈会写进 slowlog,常见的是没走索引的查询卡在 PDO->query。MySQL 那边再看 long_query_time,两份日志对上时间点,链路就闭合了。
这一段答的是最贵的一环:每多 100 毫秒,所有访客都要多等 100 毫秒,CDN 也救不回来。
三条路线的取舍:逐段测、日志反推、动基础设施
路线一是前端逐段测。前提是本机能打开页面,代价是一条 curl 加一个浏览器 Network 面板,十分钟能排除掉一半可能;局限是只有客户端视角,跨地域的差异看不到。
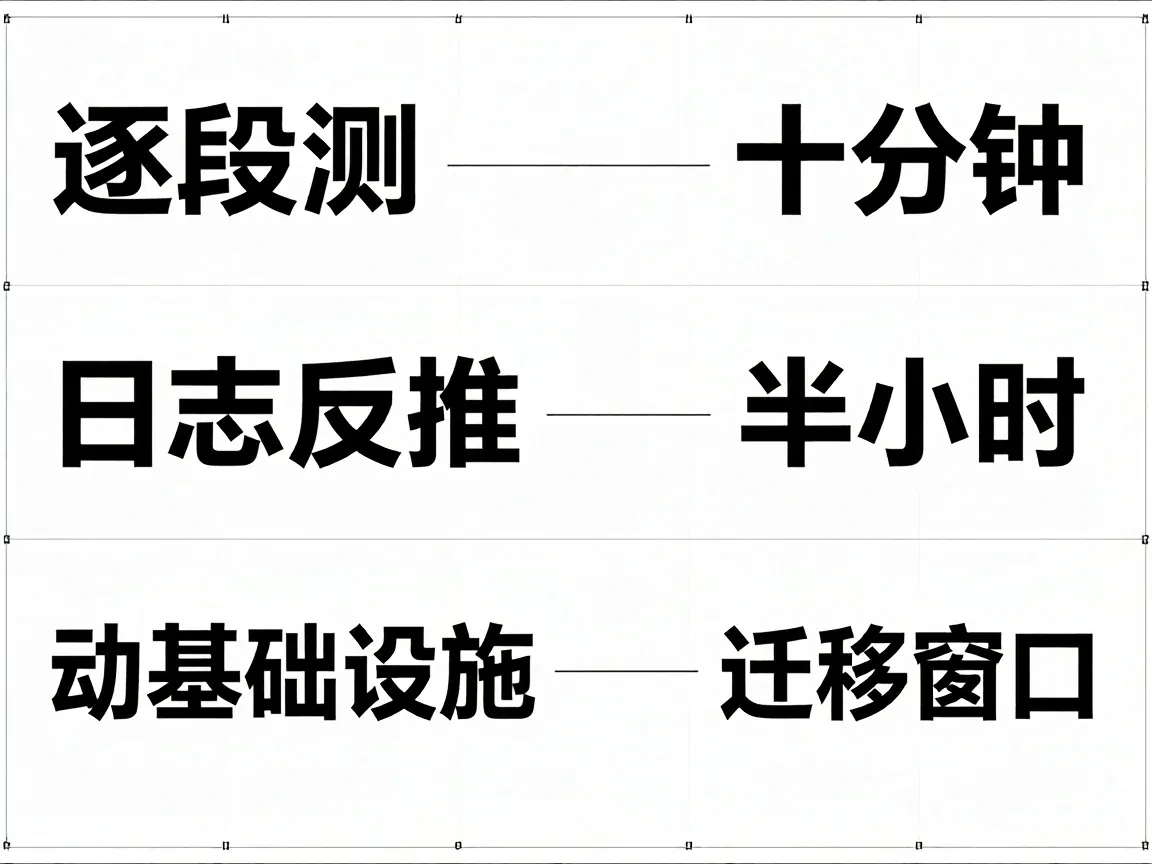
路线二是日志反推。前提是有日志权限、能改 log_format 并 reload,代价是重启窗口和日志量上涨,换来的是全量数据,能看到真实访客的分布。已经怀疑后端时走这条。
路线三是动基础设施:上 CDN、升带宽、换机型。前提最少,代价最高,适用场景其实只有一个——前两条都证明瓶颈确实在传输段。
三个维度摆开,顺序就清楚了:先用路线一拿到五段耗时的比例,再用路线二确认这个比例是普遍现象,两条都对上才考虑路线三。顺序反了,钱花了问题还在。三条路线的时间成本也差着一个量级:十分钟、半小时、一个迁移窗口。
回到这台四年没换过的机器
当初处理这台机,先做的是路线三。带宽从 1Mbps 升到 5Mbps,又挂了 CDN,每月多出几十块,首页从 1.1 秒变成 1.0 秒——那点差别全在传输段,TTFB 一点没动。真正吃掉 747 毫秒的是一条没索引的查询,加上索引之后掉到 90 毫秒。
错在把「打开慢」默认成「带宽不够」,没有先量。重来的话顺序是 curl 五段、日志确认、改 SQL,前后不到一小时;实际走的是两个月的 CDN 开销加一次无谓的迁移窗口。
现在 CDN 到期没再续,5Mbps 也没再续,回到 1Mbps 那条线,首页 0.3 秒。
若非作者标注皆为李涛自留地原创文章,转载或复制请以超链接形式并注明出处。
- 跨域是设置前端还是设置后端?配在发送响应头的一侧 2026-11-14
- robots协议如何查看?三个入口与三种返回状态 2026-11-19
- php清除session只删变量没用,会话文件还在服务器上 2026-11-12
- jQuery实现指定日期页面变灰代码 网站页面实现页面变灰效果 2022-12-02
- Windows电脑截图快捷键是什么?电脑截图快捷键方法介绍 2022-10-13
- react按钮跳转页面没反应?从事件绑定查到路由配置 2026-11-15